
OmniEval:打破黑盒,为金融 RAG 系统绘制全方位“体检报告”
OmniEval: An Omnidirectional and Automatic RAG Evaluation Benchmark in Financial Domain
本文提出了 OmniEval,一个针对金融领域的全方位自动化 RAG(检索增强生成)评测基准。它通过矩阵式场景划分(5 种任务 × 16 个金融主题)和多阶段评估体系,为金融 RAG 系统提供了精细化的性能画像,并开源了包含 1.3 万余条数据的高质量数据集。
TL;DR
在垂直领域,检索增强生成(RAG)已经成为解决 LLM 幻觉和知识迟滞的标配。然而,如何评价一个金融 RAG 系统是否“及格”?中国人民大学的研究团队发布了 OmniEval,这是首个针对金融领域设计的、全方位且自动化的 RAG 评测基准。它不仅涵盖了 16 个细分金融主题,还通过 SFT 微调出的专用评估器解决了长久以来“机评不如人评”的痛点。
1. 痛点:为什么通用的 RAG 评测带不动金融场景?
金融领域对 AI 的要求可以用“极端”来形容:
- 知识隔离:通用语料库中缺乏最新的年报、招股书等特定知识。
- 任务复杂:不仅要能提取事实(Extractive QA),还得会算利润率(Numerical Reasoning),甚至要对比两份财报的异同(Contrast QA)。
- 评价失效:传统的 Rouge-L 指标只要关键词对上了就给高分,但在金融里,一个小数点的错误(数值准确性)或逻辑上的张冠李戴(幻觉)都是致命的。
现有评测工具(如 PIXIU, FinanceBench)要么缺乏自动化生成能力,要么只看最终输出而忽略了检索路径(Retrieval Quality)的诊断。
2. 核心机制:矩阵式场景评估体系
OmniEval 的核心创新在于其 Task-Topic Matrix(任务-主题矩阵)。
矩阵化场景覆盖
研究者将金融咨询拆解为两个正交维度:
- 5 大任务(Tasks):抽取式 QA、多跳推理、长篇 QA、对比 QA、对话式 QA。
- 16 个主题(Topics):涵盖股市、投行、房产保险、宏观经济等。
这种设计能够精准定位模型在哪个环节“掉链子”。例如,某个模型可能在“保险事实提取”上得心应手,但在“投行多跳推理”上却表现糟糕。
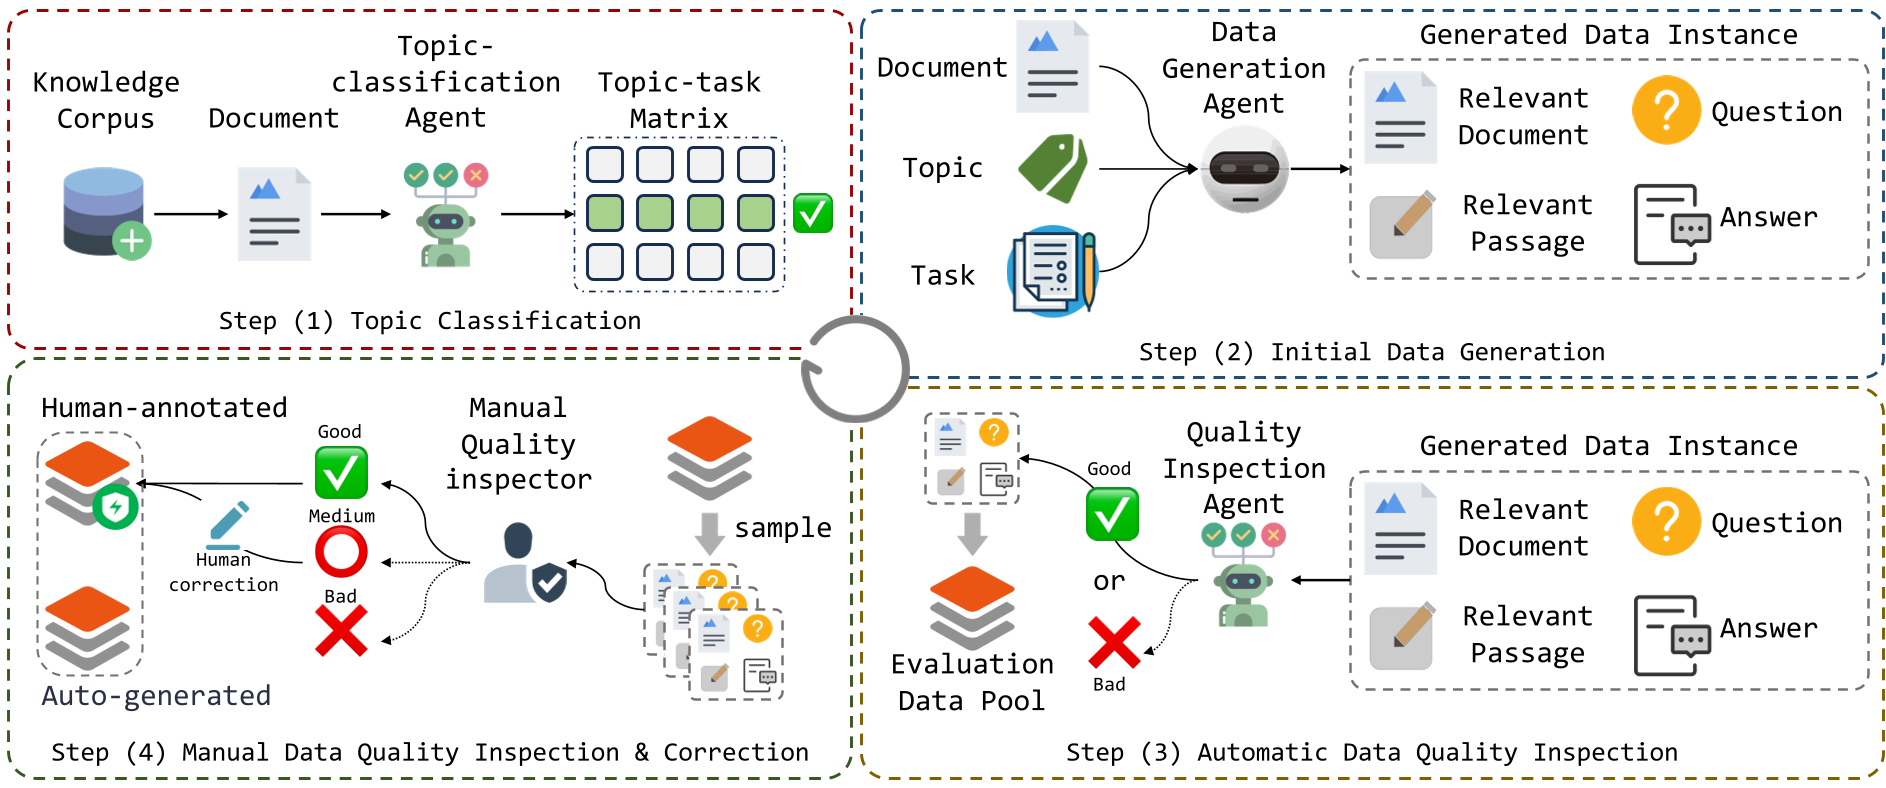 图 1:OmniEval 的自动化数据生成流水线,结合了多 Agent 协作与人工校验。
3. 方法论详解:如何训练一个“挑剔”的评估器?
为了解决 LLM 评估不稳定的问题,作者并没有简单使用 GPT-4 的 Zero-shot 评分,而是采用 SFT(监督微调) 方案:
- 五大评估维度:准确性(ACC)、完备性(COM)、幻觉(HAL)、利用率(UTL)和数值准确性(NAC)。
- 微调评估器:作者对比了 Llama-3.1 和 Qwen-2.5 多个尺寸的模型。最终发现,经过 Lora 微调的 Qwen2.5-7B-Instruct 在与人类评价的一致性(Accuracy & Kappa)上超越了 72B 的大模型,准确率达到 74.4%。
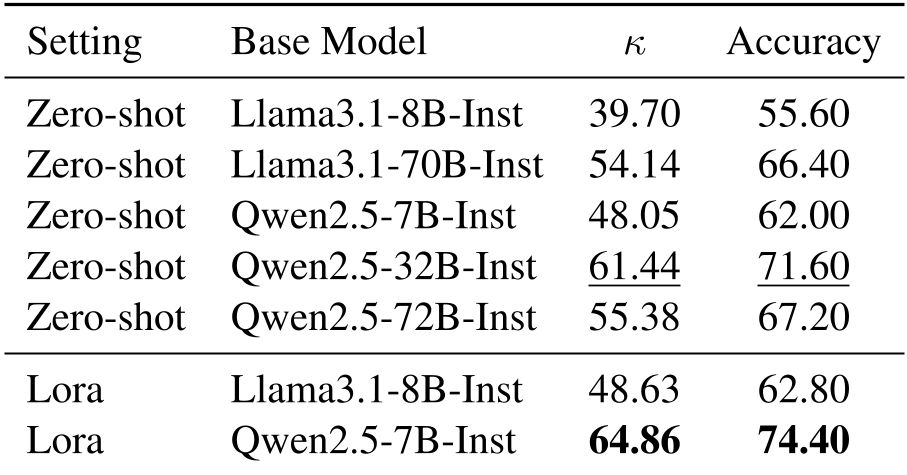 表 1:不同评估器在金融场景下的准确性对比,微调后的 7B 模型表现惊艳。
4. 实验发现:谁才是金融领域的 RAG 霸主?
通过在自动化生成集(1.14w 条)和人工标注集(1.7k 条)上的大规模测试,OmniEval 揭示了几个残酷的现象:
- 检索器是天花板:GTE-Qwen2-1.5b 由于在 SFT 阶段融入了部分 LLM 知识,在检索端显著优于 BGE-M3 等传统模型。
- 生成端各有千秋:由于金融任务的硬核属性,即便是 Llama-3.1-70B 这样的顶级模型,在面对多跳推理(Multi-hop Reasoning)和数值计算时,性能依然有巨大的提升空间(ACC 指标普遍低于 0.5)。
- RAG 是刚需:对比 Close-book(闭卷)模式,RAG 挂载外部知识库后,LLM 的幻觉指标(HAL)大幅下降,体现了垂直领域外挂索引的必要性。
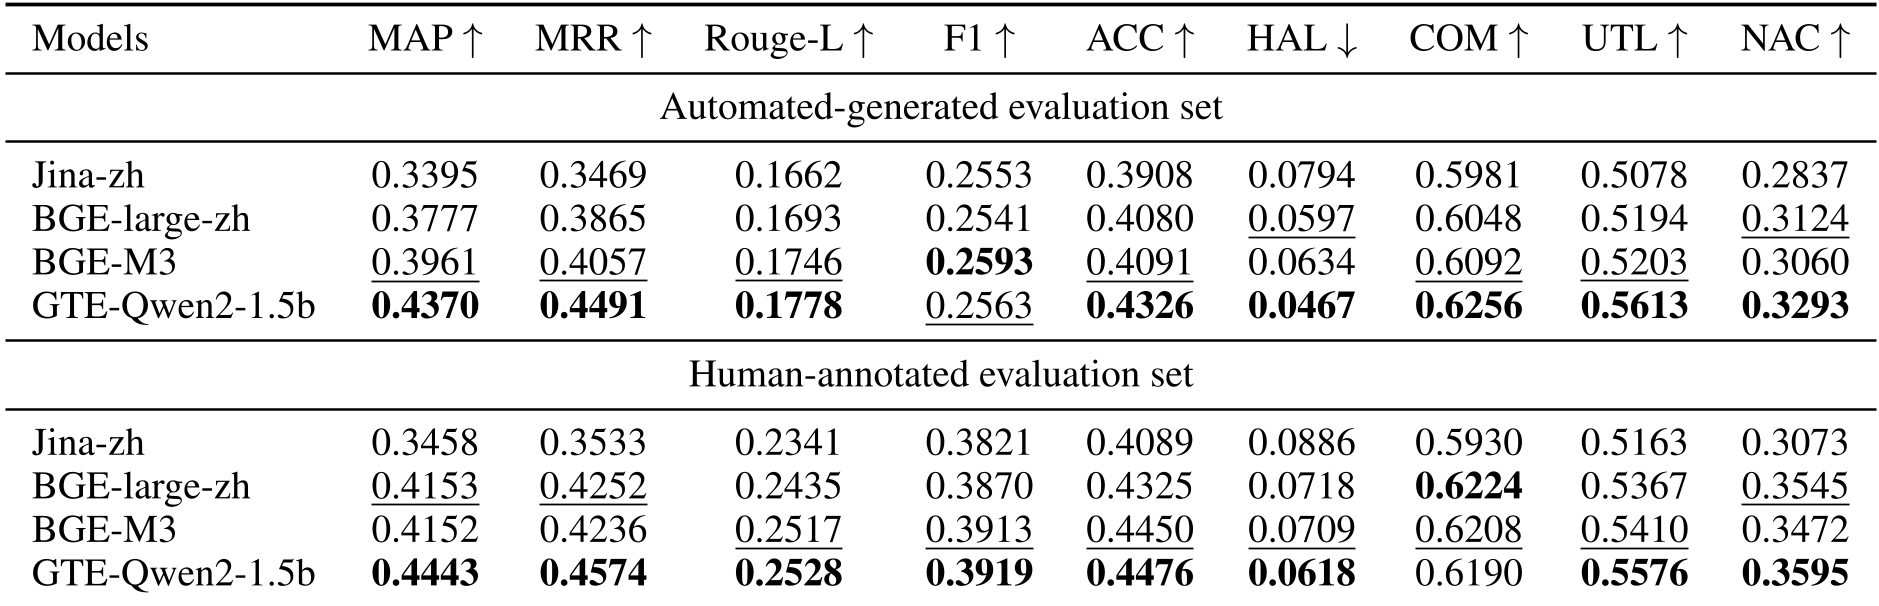 表 2:各类检索器与生成器的组合评测。
5. 深度洞察与总结
OmniEval 告诉我们:
- 垂直领域 RAG 不能“偏科”:单纯提升 LLM 的推理能力是不够的,如果检索器无法在 16 个细分主题下保持高召回,生成端只会是“巧妇难为无米之炊”。
- 小模型评估器的崛起:通过高质量的金融评估数据进行 SFT,小参数模型完全可以胜任垂直领域的公正评委,成本远低于调用 GPT-4 API。
局限性:目前的评测主要侧重于文本和数值,对于金融财报中常见的表格解析(Table Parsing)和多模态图表分析还未完全闭环。
未来启示:未来的金融 AI 优化应当从“广而泛”转向“精而专”,利用 OmniEval 提供的矩阵画像,针对性地补齐模型在特定金融任务上的短板。