
告别长 Prompt 推理:微软提出在策上下文蒸馏 OPCD,让大模型“把外挂知识背下来”
On-Policy Context Distillation for Language Models
本文提出了在策上下文蒸馏(On-Policy Context Distillation, OPCD)框架,旨在将大语言模型的临时上下文知识(如解题经验或系统提示词)内化为固定模型参数。通过让无上下文的学生模型在自身生成的轨迹上进行在策采样,并最小化与有上下文指示的教师模型之间的逆向 KL 散度(Reverse KL Divergence),该方法在多项数学推理和文本游戏任务中超越了现有的离策蒸馏与上下文学习基线。
TL;DR
大语言模型(LLM)的上下文学习(In-Context Learning, ICL)能力让人惊艳,但这种“临时内存”十分短暂——一旦 Session 被重置,大模型就会瞬间“失忆”,每次交互都需要重新输入长长的 Few-shot 样例、思维链或系统提示词(System Prompt)。这不仅极大地增加了推理阶段的延迟和 K-V Cache 显存开销,更可能因为外推长度限制导致性能坍塌。
针对这一痛点,微软研究院在 2026 年初的最新论文 《On-Policy Context Distillation for Language Models》 中提出了一种全新框架 —— On-Policy Context Distillation (OPCD,在策上下文蒸馏)。它不仅能够将大模型提取出来的临时“解题经验”或长达数千 Token 的系统提示词完美地内化到模型的模型权重(Parameters)中,还在数学推理、文字游戏等任务上超越了带有“作弊小抄”(In-Context Prompt)的原始模型,同时还几乎无损于模型的分布外(OOD)泛化能力!
1. 痛点深挖:为什么以前的上下文蒸馏容易“学成废柴”?
为了消除长 Prompt 带来的推理开销,学术界曾提出上下文蒸馏(Context Distillation):训练一个“不带 Context 的学生模型(Student)”,去逼近“带着 Context 作为指导的教师模型(Teacher)”的概率输出。
但以往的方法(如 Snell et al.)遭遇了两个难以逾越的瓶颈:
1. 暴露偏差 (Exposure Bias) 的诅咒
常规蒸馏使用的是**离策(Off-Policy)**训练。即直接把教师模型在有上下文时生成的轨迹,或者干净的 Ground-Truth 语料塞给学生。但在实际推理(Deployment)时,学生模型需要自己做自回归生成,一旦在生成第 3 个 Token 时犯了错,之后便会陷入“一步错步步错”的无底深渊,这在强化学习中称为暴露偏差。
2. 正向 KL(Forward KL)强迫“模式覆盖”引发幻觉
传统的蒸馏损失函数使用的是正向 KL 散度: 从数学物理学直觉来看,正向 KL 的定义中,学生分布 作为分母。这导致只要 ,学生分布 也必须大于 0。这种 "Mode-covering" (模式覆盖) 倾向会强制低容量的学生模型去生硬地模仿教师分布所有的概率特征,包括一些不相干的长尾输出和高熵不确定性。当学生模型“脑力不足”(参数量有限)时,强行模仿的结果就是产生严重的幻觉(Hallucinations),生成质量雪崩。
2. 核心解法:OPCD 逆向 KL 加上策采样的“寻模”直觉
微软提出的 OPCD(On-Policy Context Distillation) 正好将这套范式颠倒了过来,其核心主张为:“用学生自己的生成样本来训练,并采用逆向 KL 散度”。
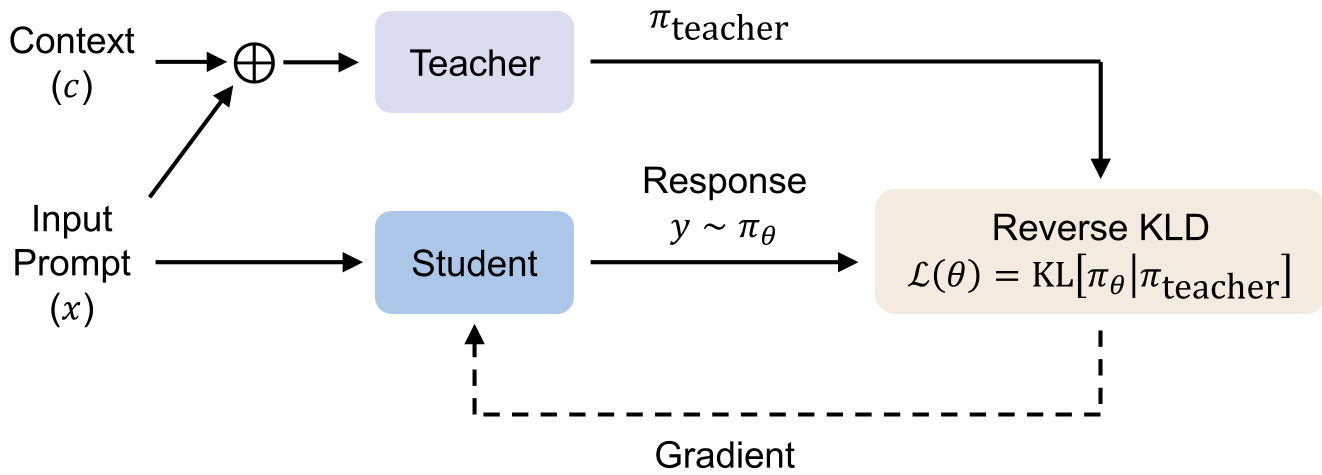
物理/逻辑直觉解析
它的工作流程如下:
- 学生自主演练(On-Policy Rollout):不给学生模型准备任何 Context(“闭卷考试”),只给输入 ,让学生模型完全凭借自己的当前权重生成一整个响应轨迹 。
- 教师现场校对(In-Context Correction):拥有 Context 的教师模型读取学生生成的轨迹,计算逆向 KL 散度(Reverse KL Divergence):
- 在策梯度更新:因为是逆向 KL,它表现出强烈的 "Mode-seeking"(寻模) 属性。
从直觉上说,逆向 KL 只要保证学生认为高概率的点,在老师那里也觉得高概率即可。学生不需要去死记硬背教师的所有分支和多样性,而只需集中精力把自己生成路径上的每一个 Token 概率对齐到教师认为“正确、高频”的绝对信心区域。这极大地保证了生成的确定性和精准性,从根本上降低了幻觉发生的可能性。
3. 数学形式:如何优雅地估算无休止的词表 KL 散度?
在自回归文本生成的过程中,如果直接计算全词表上的逆向 KL,由于词表规模巨大(通常 ),会导致显存和算力的双重灾难。
OPCD 最终优化的损失函数在序列级别展开如下:
在具体实现中,作者没有做全词表积分,而是采用了一种极具工程智慧的Top-k 近似求和机制。通过只关注学生模型极小概率输出的顶部 个 Token 集合 (在文中实验中 ):
这样一方面剔除了教师低频噪声对梯度的污染,另一方面极大幅度提升了 RL 在策对齐的计算效率。
4. 实验与结果:超越“带小抄”的原始模型
作者在两大应用层面对 OPCD 进行了全面校验。
应用一: experiential knowledge distillation(经验知识蒸馏)
模型在多次做题(如英文数学 DAPO-Math 和 TextArena 文本游戏)之后,自我提取出一些泛化的“解题经验”(元知识,不带 Ground Truth Label),然后使用 OPCD 将这些累积的经验逐步融进模型的权重里。
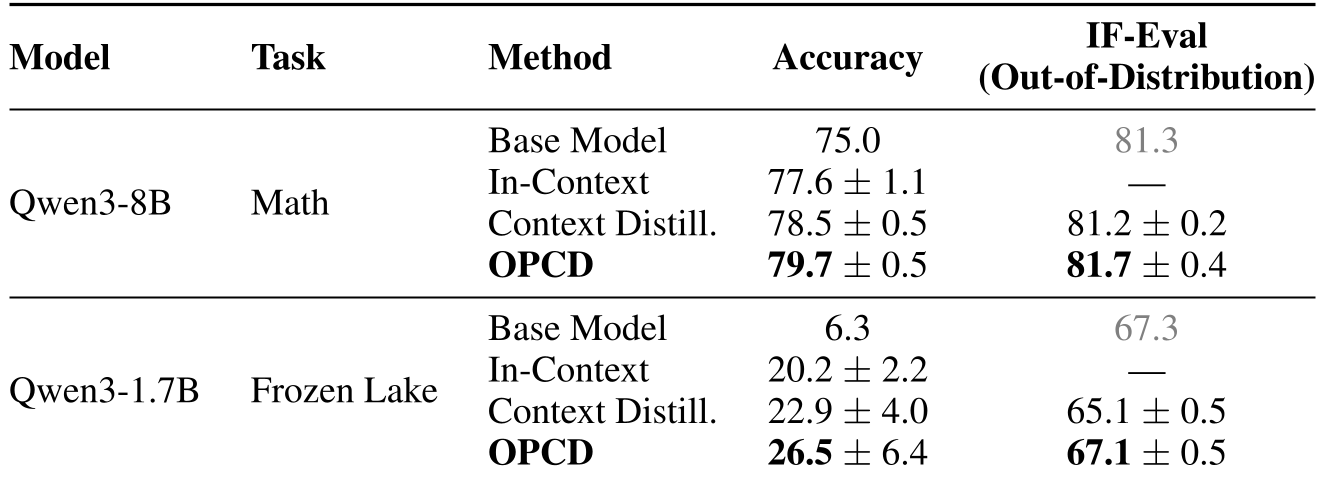
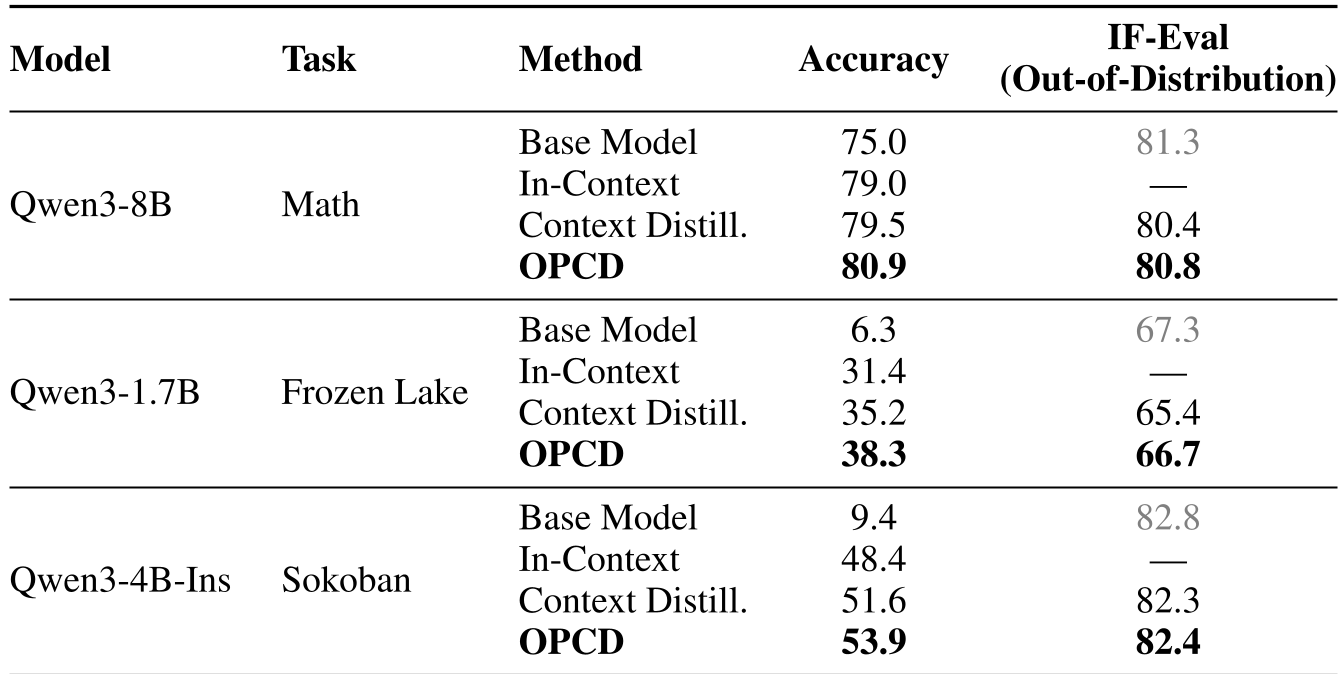
实验核心发现:
- 超越 ICL 上限:在 DAPO-Math 上,Qwen3-8B 基础模型分数为 75.0%。外挂经验 Context(In-Context)时分数为 77.6%,而经过 OPCD 蒸馏内化之后,在完全不带任何 Context 运行推理的情况下,准确率达到了惊人的 79.7%!
- 多轮对齐的红利:因为在策蒸馏让学生接触到了自己在训练集中从未见过的状态空间分布,提供了额外的良性自我纠正信号,从而形成了正向反馈。
应用二:系统提示词内化(System Prompt Distillation)
在特定垂直领域(如医学 MedMCQA 和安全指令检测),我们往往需要非常冗长且经过微调的系统提示词(System Prompt)。OPCD 可以将这些极其昂贵的 System Prompt 直接打包进底层参数。
实验表明(见 Table 3 & Table 4),在 Llama-3.1-8B-Ins 和 Qwen2.5-7B-Ins 等模型上,OPCD 获得的准确率和泛化一致性均显著超越了传统的离策(Context Distillation)系统。
5. 硬核探索:两个颠覆直觉的发现
在论文的深入分析中,有两个现象对于模型的日常训练极具启发:
现象一:小模型装不下大模型的“高智商经验”(排异反应与跨尺寸对齐)
很多工程师做系统设计时,喜欢用 GPT-4 把经验提取出来,直接作为 Few-shot 或 RAG 背景灌给 1.5B/3B 的小模型作为 Context。 论文中做了一组对照:使用 Qwen3-8B 收集高质量的“做题经验”,并将其直接塞进 Qwen3-1.7B 和 Qwen3-4B 的 Context 中(即下图中的 “In-Context” 虚线)。
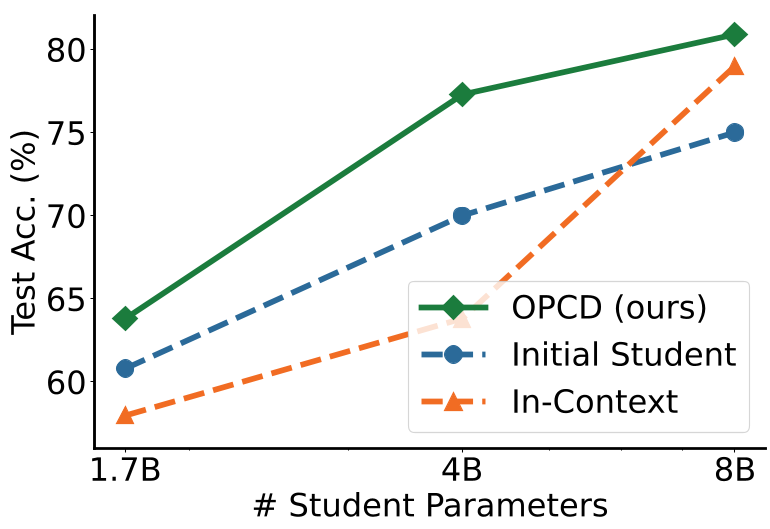
我们看到了颠覆常识的图景:直接把大模型的经验放进外部上下文,居然使 1.7B 模型的表现显著退化了!(在 1.7B 模型中直接注入,表现跌落至 Base 之下)。 原因解析: 较小的模型不具备与高级解题经验相匹配的特征对齐空间(Alignment Gap)。经验虽然对原作者(8B 模型)是灵丹妙药,对小模型却是无法理解的“天书”。 OPCD 的奇迹: 如果我们用 Qwen3-8B 带着经验作为 Teacher,通过 OPCD 的逆向 KL 对 Qwen3-1.7B 进行在策喂养,1.7B 的性能反而能够一路高歌猛进(图中蓝线与绿线),实现完美的知识降维打击与参数同化。
现象二:Mitigating Forgetting(在策蒸馏不忘本)
由于离策蒸馏粗暴地重塑了全局流形,模型很容易在大脑内化新知识的时候产生严重的“灾难性遗忘”(Catastrophic Forgetting)。 作者实验了给模型进行安全分类的系统提示词内化,并同时测试它在 OOD 数学和 OOD 医学推理上的退化情况。
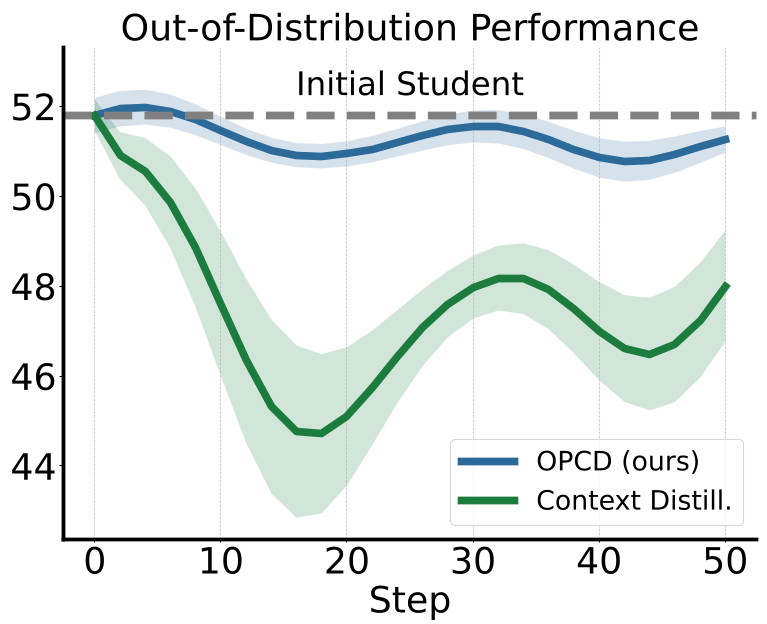
如上图(Figure 3)右侧所示,相比离策蒸馏(Context Distill.,橙色线)在医学数据上的惨烈狂跌,OPCD(蓝色实线)几乎完全没有引起跨领域 OOD 能力的崩溃。究其原因,是因为在策采样只会激活动模空间(Active Generation Space)中与当前生成词极其相关的权重突触进行修正,未参与纠错的参数保持沉默,大大缓解了对非目标任务的参数侵蚀。
6. 深度洞察与局限性(Limitations)
虽然 OPCD 表现出色,作为资深学术主编,我们仍然需要客观地透视其局限:
- 对 Teacher 精准度的高度依赖性:因为逆向 KL 鼓励寻模行为,如果你的 Context-conditioned Teacher 给出了一些高度自信的“荒谬错误”(即幻觉概率极高),OPCD 也会以极快速度让学生把这个偏见作为“圭臬”加以吸收。
- Self-Distillation 的内在不稳定性:论文的表 5(Table 5)指出,如果让学生和教师共享同一份权重同时更新(类似 PPO 中的一些弱对齐设计),由于反馈环(Feedback Loop)的震荡,极易产生梯度漂移和坍塌(在 Sokoban 任务中自纠错准确率仅为 18.8%,而采用冻结教师的策略时准确率为 53.9%)。
- 计算效率的 RL 痛点:因为是 On-Policy 采样,每一轮迭代都需要在线自回归生成整个轨迹,这造成了大量的训练期 K-V Cache 累积与解码等待,其算力开销显著大于简单的数据单向教师蒸馏(Offline Single-pass)。
7. 展望将来
OPCD 成功用极具美感的“在策寻模”消除了长上下文对 Transformer 部分推理资源的侵占。可以预见,未来的端侧大模型(Edge AI)、实时对话式 Agent、以及多模态人机交互系统,都能借由 OPCD 在闲时进行“经验消化与参数睡眠”,进而在前台保持超敏捷的高速轻量推理,开启了“外挂经验-固化参数-自主飞轮”的进化闭环。