
[v1.1] AUTODISCOVERY:基于“贝叶斯惊喜”开启开放式自动科学发现的新范式
Open-ended Scientific Discovery via Bayesian Surprise
本文提出了 AUTODISCOVERY,一种面向“开放式”自动科学发现(ASD)的新方法。该方法引入了“贝耶斯惊喜度”(Bayesian Surprise)作为核心驱动力,利用蒙特卡洛树搜索(MCTS)在 21 个真实世界数据集上实现了 SOTA 水平的科学假设探索效率。
TL;DR
在自动科学发现(ASD)领域,如何让 AI 不只是“回答问题”,而是学会“主动提问”?来自 Allen Institute for AI 和 UMass Amherst 的研究团队推出了 AUTODISCOVERY。这不仅仅是一个刷榜模型,它通过数学化的 Bayesian Surprise (贝叶斯惊喜度) 模拟了人类科学家的好奇心。通过 MCTS 在深不见底的假设空间中寻宝,它能比传统方法多挖出 29% 的高价值科学发现。
核心定位
如果说传统的 ASD 是“命题作文”(给数据和问题,求答案),那么 AUTODISCOVERY 则是“自由探究”。它在学术坐标系中处于 Open-ended ASD (开放式自动科学发现) 的前沿,旨在解决“全自主科研”中搜索效率低、评价盲目等瓶颈问题。
痛点与动机:为什么“有趣”很难被量化?
过去的研究常使用“多样性(Diversity)”或“人类有趣性代理指标”来引导 AI 探索:
- 多样性陷阱:单纯追求不同,会让 AI 陷入浪费资源在无数平凡、琐碎的假设上。
- 主观性迷雾:所谓“有趣”,在不同专家眼中标准天差地别,LLM 很难稳定模拟这种主观偏好。
作者的 Insight:科学的影响力往往与“出人意料”正相关。如果一个实验结果剧烈震荡了 LLM 原有的认知(先验 vs 后验),那么这个点极大概率就是“科学前沿”。
方法论详解:数学直觉与工程实现
1. 贝叶斯惊喜度的数学表达
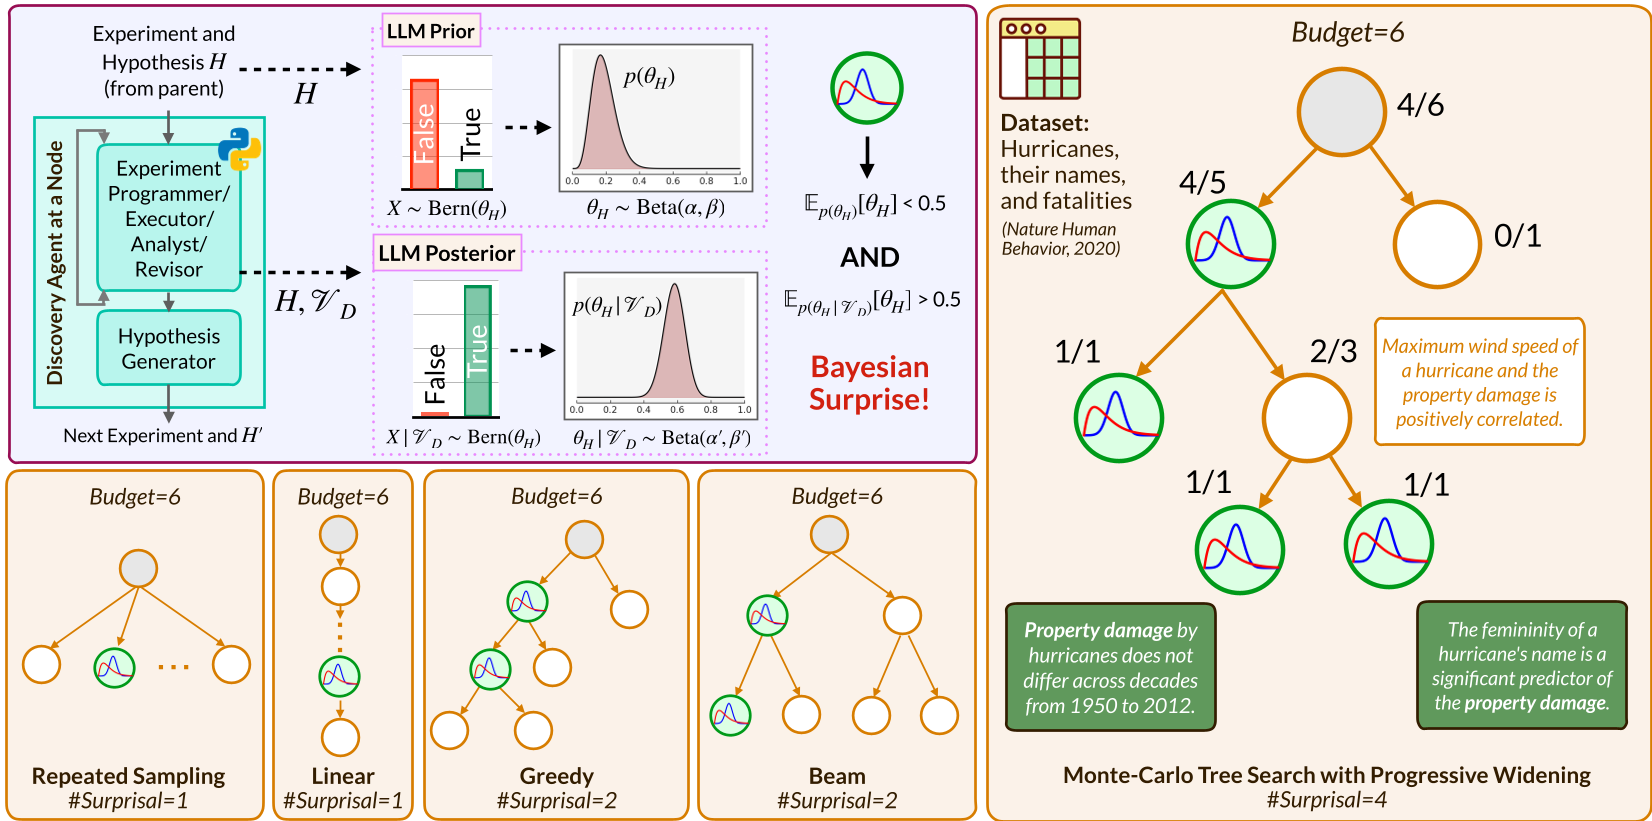
作者将 LLM 视为一个贝叶斯观察者。对于假设 ,其支撑程度分布建模为 Beta 分布 。
- Prior (先验):仅看假设,LLM 认为它对的概率。
- Posterior (后验):在 Python 环境中执行实验、观察真实数据代码输出后,LLM 更新后的认知。
- Surprisal (惊喜度):定义为两者的 KL 散度。
2. MCTS 导航策略
由于假设空间是嵌套且无限的(A 假设引出 B 实验),作者使用了 Monte Carlo Tree Search (MCTS)。
- Selection (选择):使用 UCT 公式平衡“去已知惊喜区深挖”和“去未探索区探路”。
- Expansion (扩张):利用渐进拓宽机制,防止树结构过快变深导致搜索不平衡。
- Deduplication (去重):利用 LLM 驱动的层次聚类(HAC),确保 AI 不会在同一个结论的不同表达上浪费生命。
实验与结果:它真的比人类聪明吗?
在 21 个真实世界数据集(涉及生物学、经济学等)的横向评测中,AUTODISCOVERY 展现了极强的“嗅觉”:
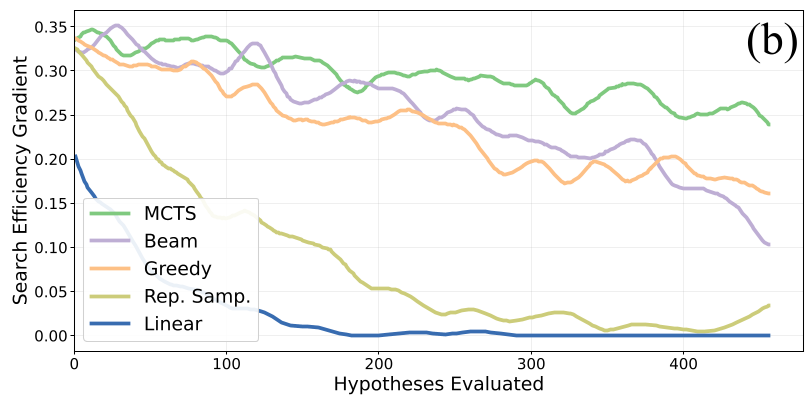
- 搜索效率:在固定 500 次实验的预算下,其累积发现的惊喜数量远超 Greedy Search 和 Beam Search。
- 专家认同:研究邀请了 500+ 背景为 PhD/MS 的专家进行双盲测试。结果显示,67% 被系统判定为“惊喜”的结论,专家也认为确实反直觉且有意义。
深度洞察:认知陷阱与未来挑战
本文在 Research Changelog 中提出了一个非常有意思的观察:LLM 在处理冲突证据时存在“认知惯性缺失”。如果不显式进行贝叶斯更新,LLM 往往会完全被当下的实验数据“洗脑”,而丢弃掉它作为预训练模型积累的博大先验知识。
局限性分析
- 环境鲁棒性:Agent 频繁安装 Python 库有时会导致执行环境崩溃。
- 伪科学风险:如果数据质量不高,AI 可能会产生“逻辑自洽但现实错误”的科学发现。
- 计算资源:MCTS 的每一轮迭代都涉及高昂的 LLM API 调用成本。
总结
AUTODISCOVERY 的成功不仅在于它刷高了多少百分比的指标,更在于它论证了 Bayesian Surprise 是通往 Open-ended AI 的一把钥匙。通过将“惊讶”这种心理学感受数学化,我们距离那个能独立写出下一篇 Nature 论文的 AI 又近了一步。