
OpenGame:从一句话到一张光盘,开源 Agent 突破游戏开发复杂度牆
OpenGame: Open Agentic Coding for Games
本文推出了 OpenGame,这是首个专为端到端 Web 游戏开发设计的开源智能体(Agent)框架。核心贡献包括 GameCoder-27B 领域模型、具备“模版与调试”双重进化的 Game Skill 机制,以及动态评估基准 OpenGame-Bench,显著提升了从自然语言到可玩游戏生成的成功率。
TL;DR
游戏开发是软件工程中的“深水区”,因为它要求实时逻辑、物理引擎、资产流水线和高度耦合的状态管理。OpenGame 是第一个专为 Web 游戏全流程开发打造的开源智能体框架。它不仅仅是“写代码”,而是通过 Game Skill(模版化+调试协议) 实现了从创意到可运行项目的自动跨越。
核心地位:这是目前首个将“领域专用模型、结构化工作流、持续进化闭环”三者统一的游戏开发智能体,在多项动态评估指标上超越了 Cursor 与 GPT-4 等通用 SOTA 方案。
1. 痛点:为什么 LLM 在游戏开发上会“翻车”?
即使是目前最强的模型(如 GPT-4 或 Claude 3.5),在面对“做一个横版过关游戏”这样的需求时,往往会遭遇三种典型的失败:
- 逻辑断层 (Logical Incoherence):模型在跨文件管理全局状态时容易“失忆”,导致游戏虽然能编译,但角色无法移动或关卡永不终结。
- 引擎黑洞 (Knowledge Gaps):通用模型常违背 Phaser 等引擎的最佳实践,通过底层 JS 重新造轮子,而不是利用高效的引擎 API。
- 资产链接断裂 (Cross-File Inconsistencies):最常见的问题——代码里的图片 Key 和生成的资源文件对不上,导致游戏白屏。
2. 核心架构:Game Skill 的进化论
OpenGame 的核心竞争力来自其 Game Skill 机制,它不像传统 Agent 那样每次都“从零开始”,而是具备了经验记忆。
2.1 模版技能 (Template Skill)
Agent 从一个不带任何物理特性的“元模版 (M0)”开始,随着任务积累,它会自动提炼出如“重力横版”、“网格逻辑”、“防御塔动态”等 5 类特定模版族。这种从经验中提取骨干架构的方法,极大地缩小了模型的搜索空间。
2.2 调试技能 (Debug Skill)
作者并没有给 Agent 硬编码死板的 Checklist。Debug Skill 维护了一个活的调试协议 (Living Protocol)。每当编译器报错或运行时异常被修复,Agent 就会记录:错误签名 -> 根因分析 -> 验证过的修复方案。下一次再遇到类似的资产引用错误或场景初始化顺序问题,系统能精准“避坑”。
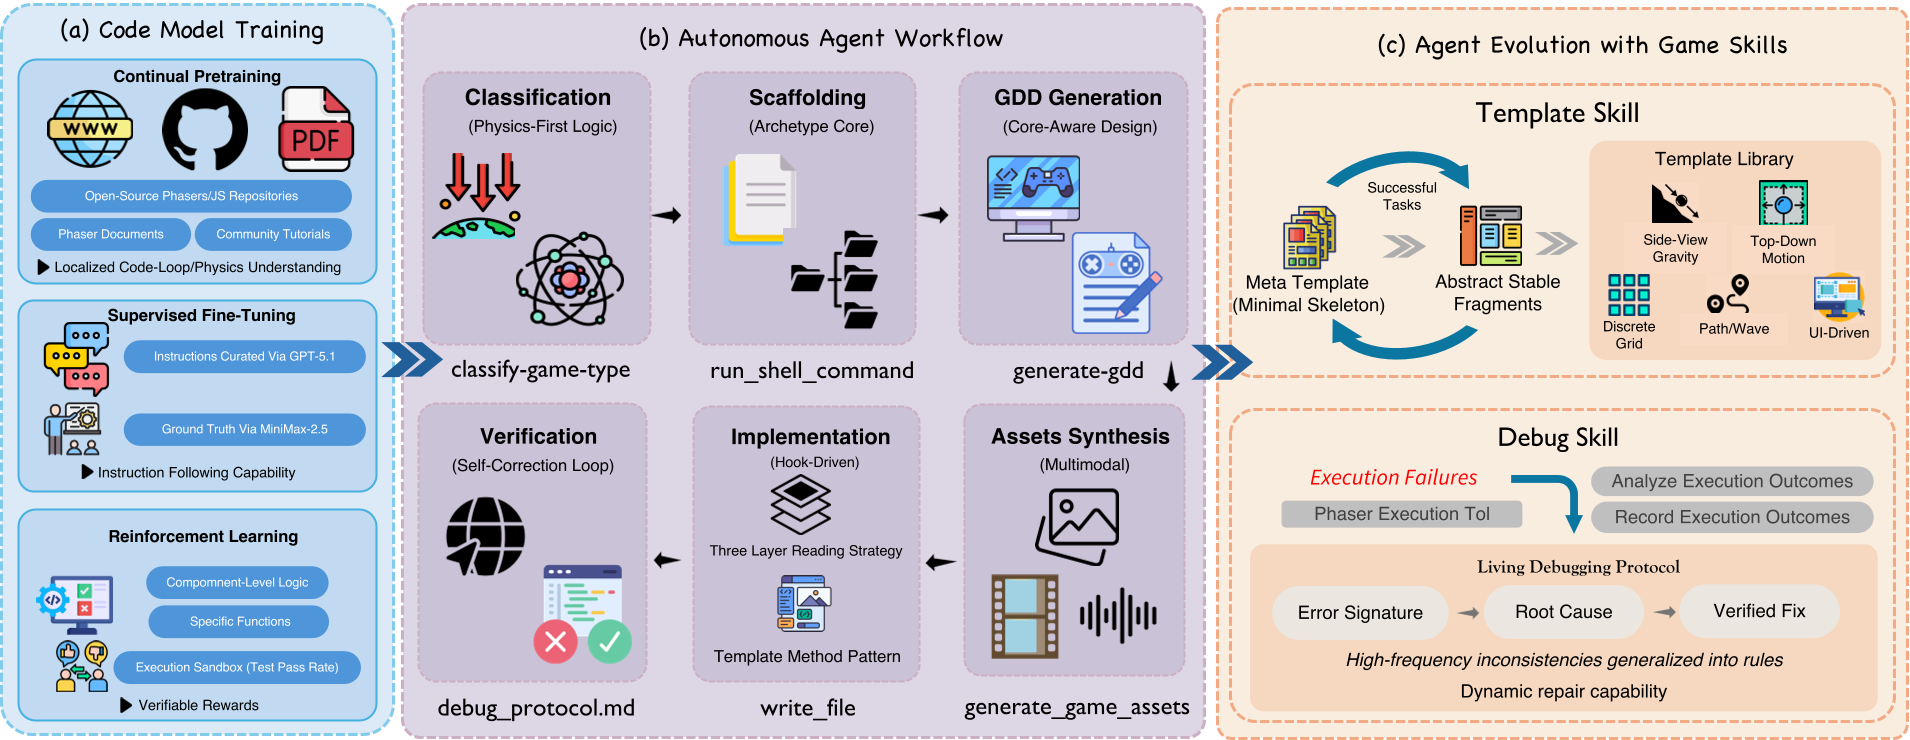 图 1:OpenGame 整体架构,涵盖了模型训练、 Agent 工作流以及技能进化模块。
3. 基座模型:GameCoder-27B
为了给 Agent 提供足够强大的大脑,团队构建了 GameCoder-27B。他们没有直接使用 Qwen2.5 的原始权重,而是进行了三阶段魔改:
- CPT (持续预训练):喂入了海量的 Phaser 官方文档和 GitHub 上的高质量游戏源码。
- SFT (监督微调):针对复杂的、多步骤的开发指令进行蒸馏对齐。
- RL (强化学习):这是关键,通过执行反馈(能否通过单元测试)作为奖励信号,确保生成的逻辑不仅看起来对,而且跑得通。
4. 实验:真实的“可玩性”评估
传统的代码评估看 Pass@1,而 OpenGame 推出了 OpenGame-Bench。它不再关注代码是否漂亮,而是关注:
- Build Health (编译健康度):甚至能在无头浏览器里跑起来且没报错吗?
- Visual Usability (视觉可用性):通过 VLM(视觉语言模型)判断图像是否重叠、动画是否一致。
- Intent Alignment (意图对齐):用户想要的是“忍者”, Agent 做的是“方块”吗?
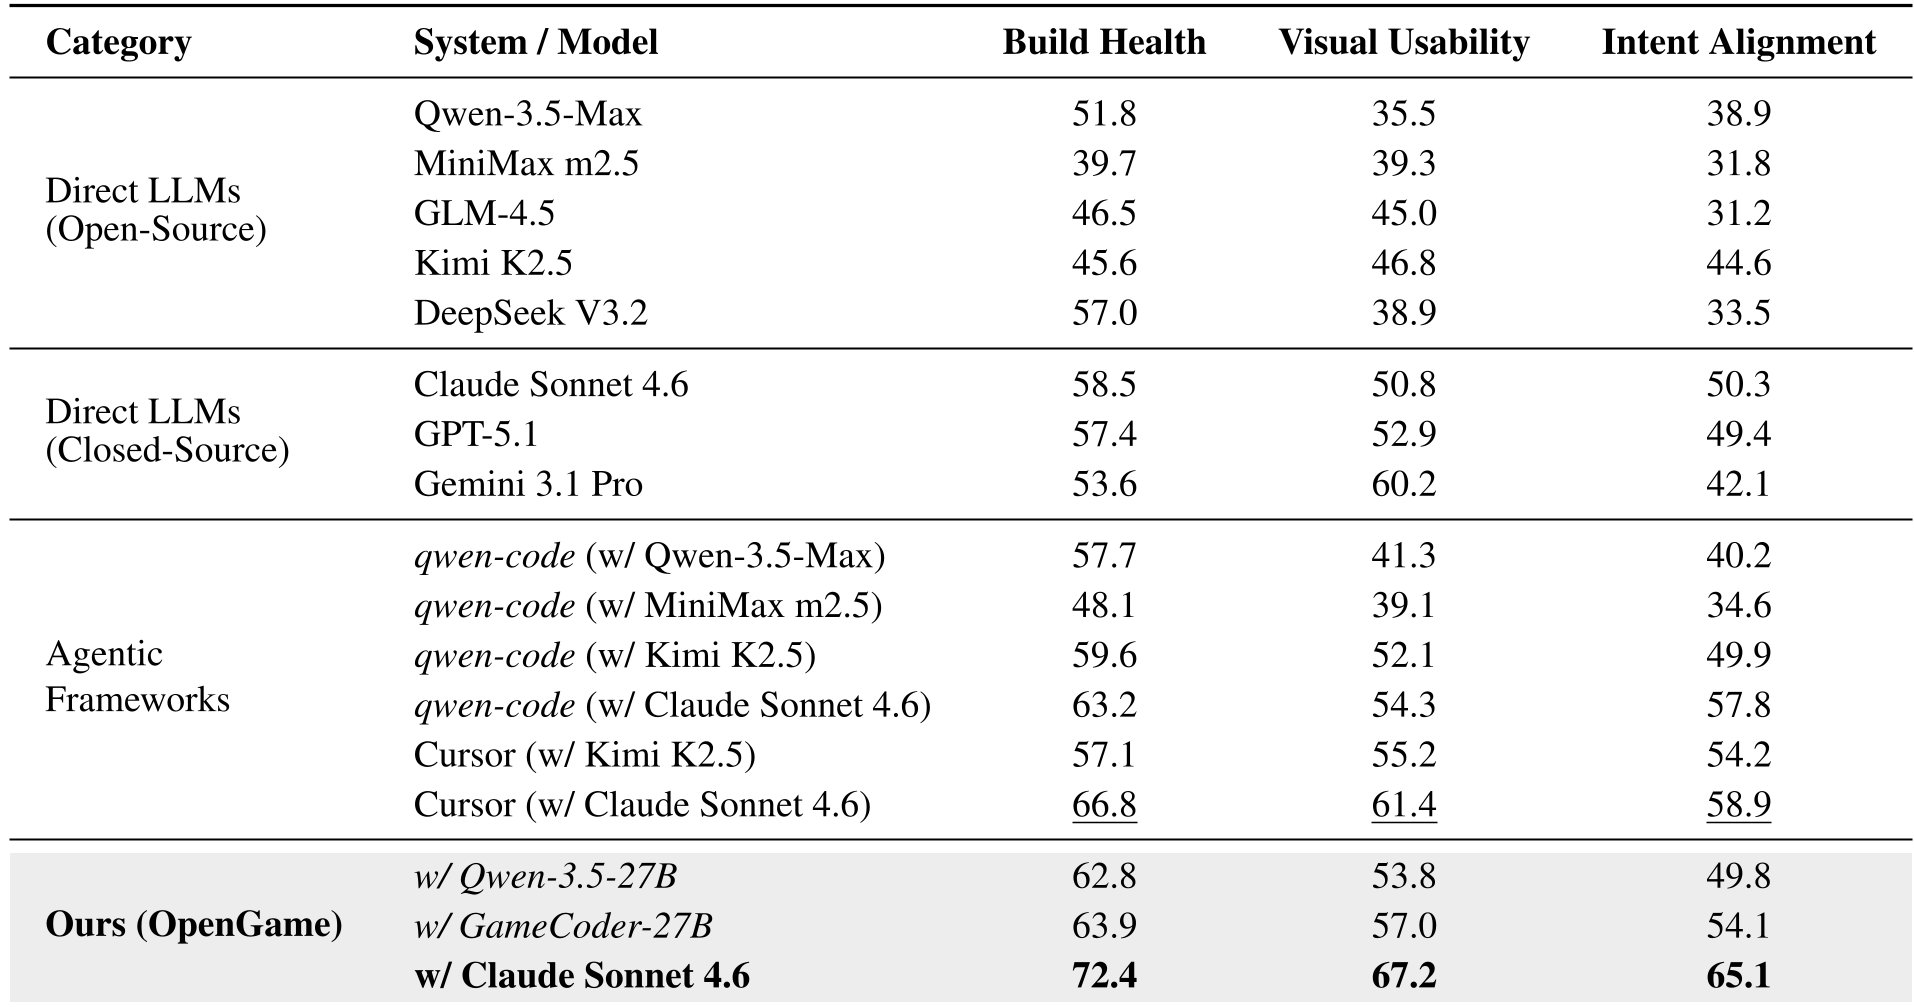 表 1:OpenGame 在各项指标上均超越了 Cursor 等强 Agent 框架。
5. 局限性与洞察
尽管 OpenGame 在物理驱动类游戏(平台跳跃、射击)中表现极其优异(IA 分数 > 70),但在抽象逻辑类(如策略游戏、复杂 UI 解谜)中仍有短板。这是因为这类游戏的逻辑失败通常是“无声的”(不报错,只是逻辑错),目前的自动调试协议还难以捕捉潜藏的业务逻辑漏洞。
总结建议:OpenGame 的成功证明了,对于复杂的工业级应用生成,“领域模型 + 动态注入的架构先验” 比纯粹的通用强推理更具效率。它为人工智能赋能内容创作者,实现真正的“创意民主化”迈出了坚实一步。