
OrderGrad:超越均值,精准操控大模型的“长尾”表现
OrderGrad: Optimizing Beyond the Mean with Order-Statistic Policy Gradient Estimation
本文提出了 OrderGrad,一套针对“序统计量(Order-Statistic)”目标的梯度估计框架。该方法通过简单的奖励转换,使得强化学习能够优化诸如 VaR、CVaR、Top-M@K 等非均值分布目标,在 LLM 数学后训练任务中显著提升了 Pass@k 性能并有效抑制了模型“啰嗦(Overthinking)”现象。
TL;DR
在强化学习中,我们习惯于让模型去追求“平均分的最高化”。但大模型的推理(Reasoning)任务更像是一场“选拔赛”:我们不在乎平均分,而在乎在 次采样中能否出现一个正确答案(Best-of-K)。由东京大学团队提出的 OrderGrad 框架,通过引入序统计量(Order-Statistic),让模型能够直接优化 Pass@k、风险价值(VaR/CVaR)等分布特性,彻底解决了传统均值优化在长尾任务和多样性探索上的无能。
痛点深挖:均值优化的“平庸之恶”
传统的策略梯度算法(如 REINFORCE、PPO)其核心逻辑是:。 这种方式在处理以下场景时会显得捉襟见肘:
- 极端表现优先:在 LLM 推理中,我们只需要模型在 100 个结果里出一个对的,而不是 100 个结果都“差不多对”。
- 鲁棒性需求:在机器人控制中,我们希望模型在最坏的情况下也不要摔倒(CVaR),而不是平均不摔倒。
- 多目标冲突:当正确率和回复长度发生冲突时,单纯的线性加权往往导致模型产生逻辑病态(如输出坍缩)。
Methodology:将排序转化为优势
OrderGrad 的天才之处展示了如何将一个复杂的分布优化问题,转化为一个极其简单的 奖励转换(Reward Transformation)。
1. 从均值到 L-statistics
作者定义了一个灵活的目标函数 ,它是采样奖励排序后的加权平均: 通过改变权重 ,你可以瞬间切换目标:
- 集中在高位 优化 Top-M@K(追求极致性能)。
- 集中在低位 优化风险收益(追求安全性)。
- 均匀分布 退化为普通均值优化。
2. 无偏梯度的秘密武器
直接对排序后的序列求导会面临偏差问题。OrderGrad 引入了一个计算量极小()的留一法排序优势值(Leave-one-out Rank Advantage): 该方法计算每一个样本产生的“排序提升”:如果加入这个样本,整个 Batch 排序后的目标值提升了多少?这保证了梯度估计的无偏性。
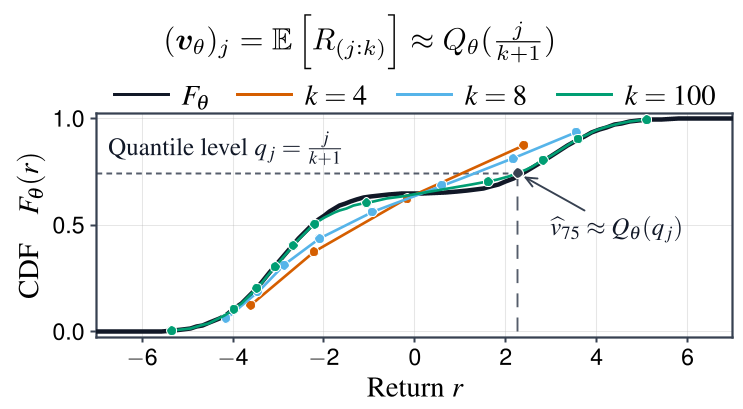 图 1:OrderGrad 将奖励分布映射到分位数空间,通过权重 实现精准目标控制
实验与结果:让 Qwen 推理更高效
在 LLM 数学推理实验中,OrderGrad 展现了教科书般的性能提升。
1. 突破 Pass@k 壁垒
在 Qwen3-4B-Base 上,使用 Top2@4 目标进行 fine-tuning 后,OrderGrad 在多个数学基准测试中显著超越了 GRPO 和 MaxPO。最重要的是,它有效防止了 Diversity Collapse(多样性崩溃)——这是许多推理模型在强化学习后变得僵化的通病。
2. 解决“过度思考”与“篇幅冗长”
这是一个非常惊艳的消融实验: 作者让 Top-M 的样本贡献“正确性奖励”,而让 Bottom-M(最长、最烂的样本)承受“长度惩罚”。
- 结果:模型在保持高准确率的同时,回复长度大幅缩短,彻底消除了无意义的“自我纠结”段落(如图 6a 所示)。而传统的加权求和方法(GRPO 变体)则直接让模型“摆烂”,准确率暴跌。
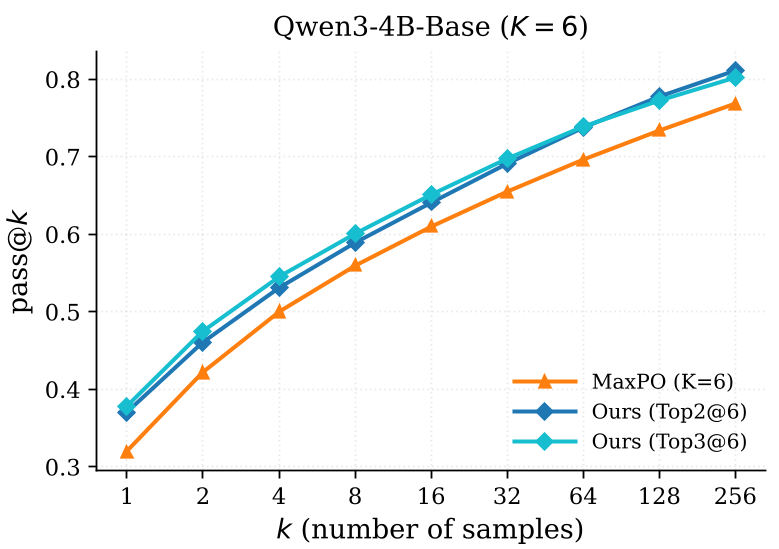 图 2:在数学任务中,OrderGrad 显著提升了 Pass@k 曲线,展示了更强的泛化探索能力
深度洞察:为什么这很重要?
OrderGrad 为我们提供了一种**“可编程”的奖励函数**。
在过去,如果模型输出太长,我们会减去 length_penalty;如果正确率低,我们会加上 accuracy_bonus。这种粗暴的加法经常导致权重难调。
OrderGrad 告诉我们:奖励应该发给正确的人,惩罚应该给到那个拖后腿的人。通过在排序空间进行操作,我们实际上是在对模型的“行为分布”进行显微手术。
总结与局限
OrderGrad 是一个极具学术美感且工程易实现的算法。它不仅统一了之前的 Max@k 等特例,还为风险敏感型 AI 铺平了道路。虽然它在超大规模 Batch 下的显存管理仍有优化空间,但其对逻辑推理模型的提升无疑具有重要的启发价值。
Takeaway: 以后在调 RL 奖励函数时,别只盯着均值,去看看你的排序分布!