
PST:1.5% 参数量达成极致压缩,大模型稀疏微调的“轻量化”艺术
Parameter-Efficient Sparsity for Large Language Models Fine-Tuning
本文提出了参数高效稀疏训练(PST),一种针对大语言模型(LLM)微调阶段的压缩方法。PST 通过结合数据无关与数据驱动的权重评估准则,并利用权重重要性矩阵的低秩性(Low-rankness)与结构化(Structuredness)特征,在仅训练 1.5% 参数的情况下,实现了与全量参数稀疏训练相当甚至更优的性能。
TL;DR
阿里巴巴团队提出的 Parameter-efficient Sparse Training (PST) 彻底解决了大模型在稀疏化搜索过程中“训练开销过大”的痛点。它通过对重要性矩阵进行低秩分解和结构化建模,在 BERT、RoBERTa 等模型上仅需训练原先 1.5% 的参数,就能在 90% 稀疏度下保持极佳性能。这标志着模型剪枝从“暴力搜索”转向了“精细化建模”的新阶段。
1. 痛点:为什么“变瘦”的过程反而让你“变胖”?
在 LLM 时代,模型剪枝(Pruning)是实现推理加速的核心手段。然而,现有的 Movement Pruning (MvP) 等 SOTA 方法存在一个悖论:为了让模型在推理阶段“变瘦”(稀疏化),你必须在微调阶段给它配一个和原权重一样大的“重要性分数矩阵” 。
这意味着:
- 显存爆炸:你需要双倍的显存来存储权重和对应的评分。
- 计算冗余:对于几十亿参数的模型,逐个计算权重的梯度下降极其低效。
如果你选择省事的 Magnitude Pruning (MaP)(直接根据权重大小删),在稀疏度达到 90% 以上时,模型性能会崩塌,因为它完全没考虑下游任务的特性。
2. 核心直觉:重要性矩阵的“内在规律”
作者并没有盲目地为每个参数分配评分,而是观察到了数据驱动的重要性矩阵(Importance Score Matrix)具有两种本特征:
- 低秩性 (Low-rankness):就像权重更新矩阵一样,重要性评分的变化也集中在少数关键维度上。
- 结构化 (Structuredness):实验发现,模型在剪枝时往往呈现出“整行”或“整列”被删除的趋势(如下图所示)。
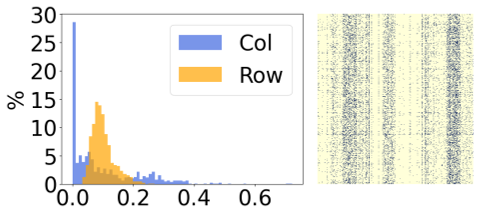 图 1:不同层在剪枝后的行/列稀疏占比,显示出明显的结构化冗余。
3. PST 方法论:三位一体的评分重构
基于上述直觉,PST 将重要性评分 重新定义为:
- (Data-free):保留原始权重的量级信息。
- (Low-rank):用两个极小的矩阵(如秩 )相乘来模拟复杂的重要性波动。
- (Structured):用一个行向量 和一个列向量 来捕捉整行或整列的重要性。
此外,PST 还借鉴了 LoRA 的思想,对权重更新过程也进行了低秩分解(),使得整个微调过程完全基于轻量化模块进行。
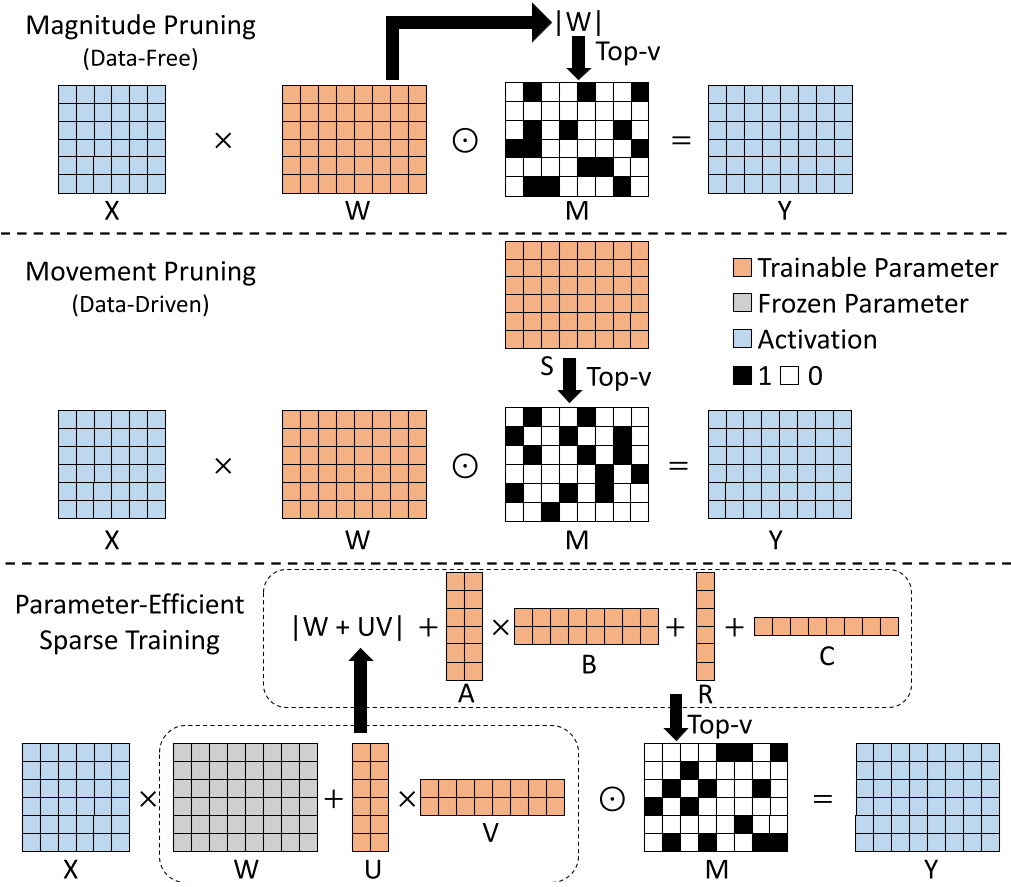 图 2:MaP、MvP 与 PST 的对比。PST 将巨大的 矩阵化整为零。
4. 实验:以小博大的巅峰表现对比
PST 在几乎所有主流 NLP 模型和任务中都表现优异。最令人惊讶的是在 90% 稀疏度下的表现:
- 参数效率:在 BERT 上,PST 的可训练参数仅为 2.91M,而传统方法需要 110M 或更多。
- 性能反超:在 RoBERTa-large 的 GLUE 测试中,PST 在 90% 任务下的得分(76.95)超过了全量参数训练的 MvP。
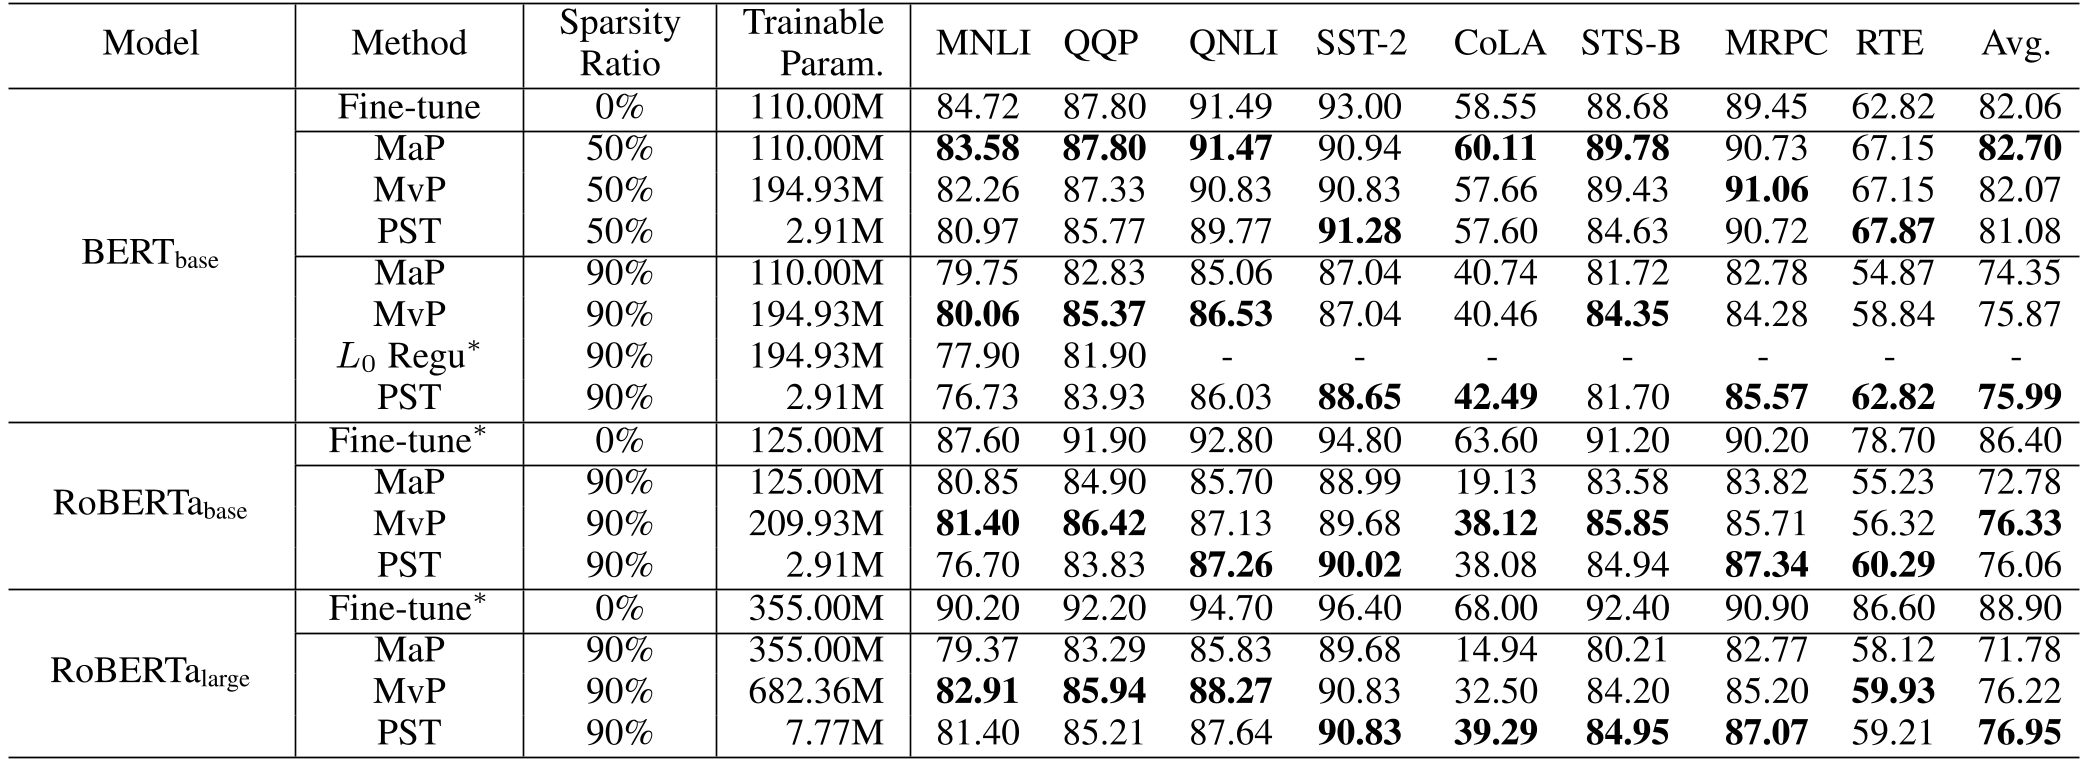 表 1:PST 在 BERT/RoBERTa 上的量化战绩。
消融分析 (Ablation)
作者发现,“结构化评分 ()”对性能的提升甚至超过了“低秩项 ()”。这说明在 NLP 模型中,神经元(即权重阵的行与列)的整体重要性比单个权重的独立重要性更具决定意义。
5. 资深主编点评:稀疏化的未来
PST 的价值在于它证明了**“压缩的过程也可以是压缩的”**。
优势:
- 极致的资源友好:对于预算有限的开发者,可以在普通游戏显卡上实现大模型的 SOTA 级剪枝。
- 物理直觉精准:准确捕捉了 Transformer 结构的 Inductive Bias。
局限性: 虽然在 90% 的极高稀疏度下优势明显,但在 50% 等低稀疏度场景下,其性能有时略逊于全量参数训练的基础方法。这可能是因为在权重较充裕时,低秩化带来的近似误差开始显现。
启示: 未来的大模型微调可能不再有“微调”和“压缩”的界限。像 PST 这样将 PEFT(参数高效微调)与稀疏化深度耦合的技术,将成为大模型端侧落地的终极钥匙。
本文基于 arXiv 论文汇总撰写。