
LLM 内部的“知识博弈”:揭秘 RAG 场景下参数记忆与外部上下文的调和机制
Understanding Parametric and Contextual Knowledge Reconciliation within Large Language Models
本文提出了名为“实体感知探测”(Entity-aware Probing)的框架,旨在揭示大语言模型(LLM)在检索增强生成(RAG)中如何调和参数知识与上下文知识。该方法通过引入特殊的 Token 标记和轻量化 LoRA 适配,成功追踪了 Transformer 内部各层中的知识流动(Entity Flow),揭示了两者在注意力机制与 MLP 层中的处理差异。
TL;DR
复旦大学与蚂蚁集团的研究团队通过一种创新的**实体感知探测(Entity-aware Probing)**技术,像“做 CT 检查”一样深入 Transformer 内部,观察 LLM 在处理 RAG 提供的外部信息与自身记忆冲突时发生了什么。研究发现:LLM 并非简单的二选一,而是将两类知识分流到不同的“车道”(注意力头),并在各层中进行信号叠加。
背景定位:RAG 的“黑盒”难题
检索增强生成(RAG)已成为解决 LLM 幻觉和时效性问题的标配。然而,当检索到的文档与模型预训练记忆打架时(例如:模型记得总统是 A,文档说总统是 B),模型内部是如何权衡的?这种权衡是发生在注意力机制的争夺中,还是在 FFN(前馈网络)的仲裁里?理解这一点对于构建更可靠的 AI 系统至关重要。
核心机制:实体感知探测器
为了不改动模型权重(Frozen LLM)又能追踪特定实体的“地位”,作者设计了一个巧妙的实验架构。
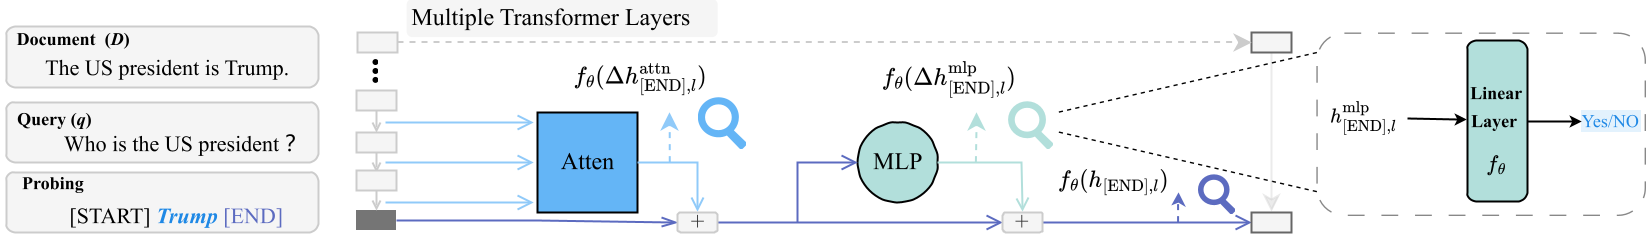
- 动态追踪:通过在输入序列末端添加
[START] 实体名 [END]标记。 - 轻量适配:仅对 Input Embedding 层进行 Rank-8 LoRA 训练,使探测器能从复杂的隐藏状态(Hidden States)中剥离出关于特定实体的“置信度”。
- 多点观测:在每层 Transformer 的 Attention 更新后、MLP 更新后以及层输出处设置观测点。
机械洞察:三条底层定律
1. 术业有专攻:不同的“头”
研究发现,LLM 内部存在明显的路径分离。
- Contextual Heads(上下文头):专门负责从 Context 中搬运信息,表现为高强度的注意力信号,像“显性检索”。
- Memory Heads(记忆头):负责提取参数中的知识。有趣的是,单一记忆头的强度远低于上下文头,说明参数知识是“碎片化”存储的,需要多层 MLP 逐步聚合。
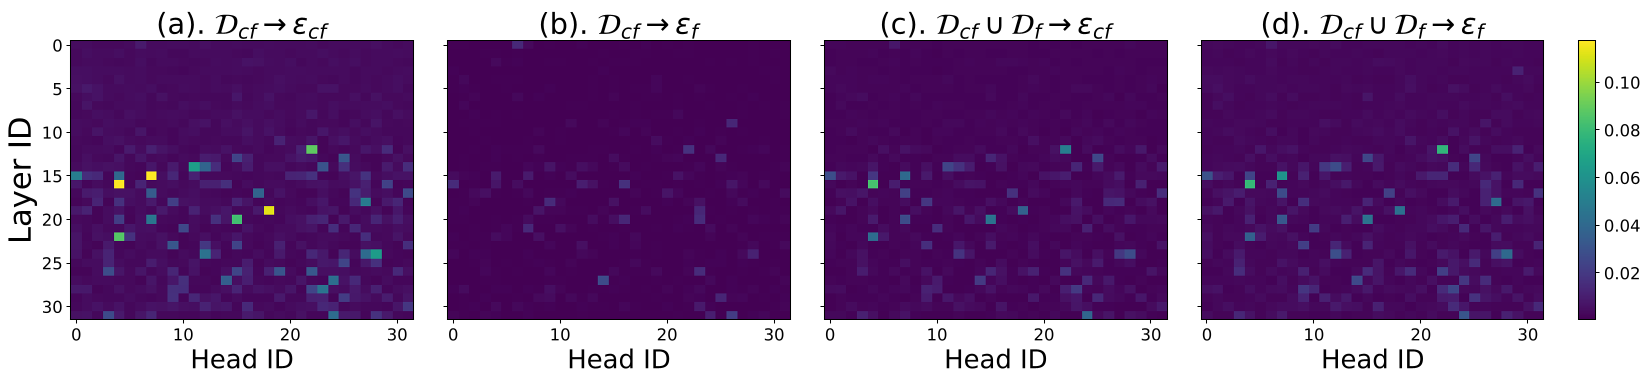
2. 只有“同类”才竞争
这可能是论文最令人惊讶的发现:参数知识和上下文知识互不干扰。
- 如果文档 A 和文档 B 冲突,它们会在“上下文头”里打架。
- 但如果文档内容和模型记忆冲突,它们各自在自己的通道里跑,并在残差流中并存。
3. 感知不对称:突发 vs 渐进
- 外部知识:在极早期层就会被注意力机制捕捉。
- 内部知识:随着层数加深,通过 MLP 层不断写入残差流,强度缓慢爬升。
实验战绩:手动干预证明因果
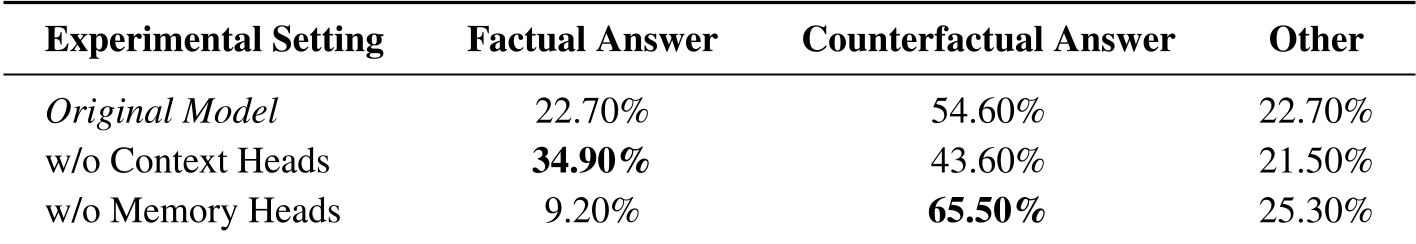
为了验证这些发现不是探测器的“幻觉”,作者直接对模型进行了“手术”:
- 切除上下文头:模型变得更固执,倾向于通过参数记忆回答(Factual Answer 占比从 22.7% 升至 34.9%)。
- 切除记忆头:模型变得更听话,完全依赖外部文档(Counterfactual Answer 占比从 54.6% 升至 65.5%)。
深度思考与未来展望
叠加态调和(Superpositional Reconciliation): LLM 在处理冲突时,并不是删除了某一方,而是让两方都在残差流中“飘着”。最终输出哪一个,取决于谁的累积幅度(Magnitude)更大。
局限性分析: 目前研究主要集中在 Decoder-only 架构(如 Llama 3, Qwen 2.5),且针对的是实体的简单替换。真实世界中的知识冲突(如逻辑谬误、时间偏差)可能更加复杂。
行业启示: 该研究为“引导”LLM 提供了理论基础。既然两类知识路径分离,我们或许可以通过特定的提示词(Prompting)来有目的地激活“上下文路径”,或者通过 Activation Steering 技术在推理时动态调整知识优先级,而无需昂贵的微调。
Takeaway: 正如作者所言,LLM 是一个复杂的动力系统,外部知识像“突发的冲击”,内部知识像“渐进的涌流”,两者在残差流的交响乐中最终达成共识。