
算法与人性的博弈:ChatGPT 冲击下的学术剽窃检测全景综述
Survey on Plagiarism Detection in Large Language Models_ The Impact of ChatGPT and Gemini on Academic Integrity(1)
本文是一篇关于大语言模型(LLM)时代下学术剽窃检测的综述研究。重点探讨了 ChatGPT 和 Gemini 对学术诚信的冲击,评估了现有的 AIGC 检测算法(如 DetectGPT, Ghostbuster)和工具(如 Turnitin, GPTZero),并分析了各种逃避检测的策略。
TL;DR
随着 ChatGPT 和 Gemini 的普及,传统的剽窃检测手段正面临前所未有的挑战。本文深入分析了 AI 生成内容(AIGC)的检测技术现状,揭示了“生成的文本越像人,检测就越困难”的本质矛盾。研究指出,单纯的技术手段已难以维护学术诚信,教育模式的范式转移迫在眉睫。
背景:从“剪贴”到“生成”的异变
在 LLM 出现之前,剽窃主要表现为文字的直接搬运。但在 AI 时代,学生只需输入 Prompt,模型即可生成一篇结构完整、逻辑自洽且在文本库中无查重的论文。这种“AI 代写”不仅破坏了学习过程,更让传统的基于文本相似度的检测工具(如 iThenticate)几乎瘫痪。
技术前哨:如何抓住 AI 的“尾巴”?
目前学术界和工业界主要在三个维度上展开技术反击:
1. 零样本检测 (Zero-shot Approaches)
这是目前最前沿的方向,其核心假设是:AI 倾向于选择概率最高的词汇。
- 核心逻辑:AI 生成的文本在概率分布上通常处于模型的“负曲率”区域。
- 代表作:DetectGPT。它通过检测文本及其微小扰动后的对数概率变化来判断来源。
- Fast-DetectGPT:在此基础上引入了条件概率曲率,将检测速度提升了 340 倍。
2. 水印技术 (Watermarking)
在模型生成文本的过程中,通过修改 Token 的采样概率分布,植入人类不可见但机器可解密的选择模式。
- 挑战:虽然 Kirchenbauer 等人提出的水印算法能降低误报,但一旦文本经过人工改写或翻译(Cross-lingual),水印极易被破坏。
3. 监督学习分类器 (Training Classifiers)
利用“人类写作数据集”和“AI 生成数据集”训练二分类模型(如 RoBERTa)。
- SOTA 表现:Ghostbuster 算法通过捕捉模型特征,宣称在多个领域达到了 99.0 的 F1 分数。
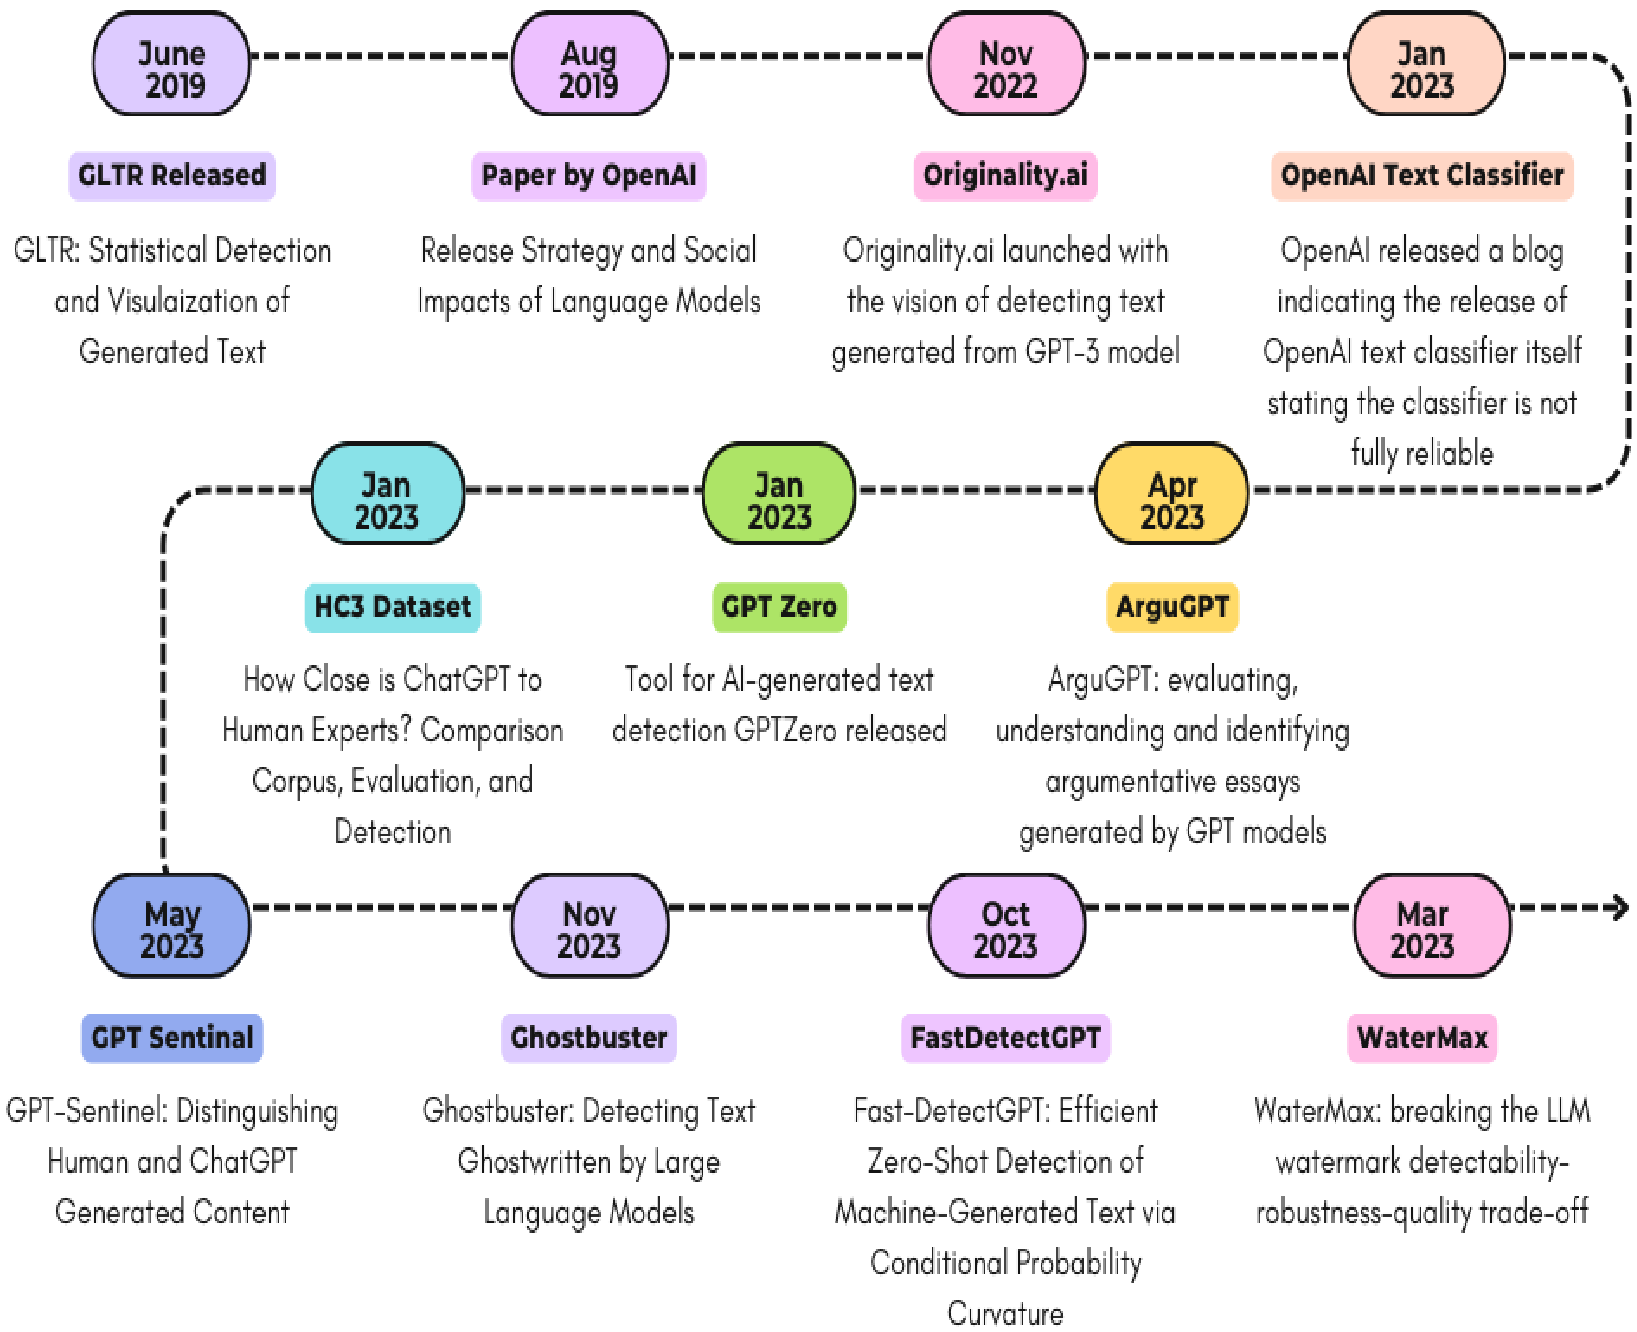 图 1:AIGC 检测领域的重大技术事件、数据集与工具发布时间表
矛盾的升级:检测器的“阿喀琉斯之踵”
论文中进行了一次尖锐的实验:将 ChatGPT 生成的内容通过 QuillBot 进行改写。
- 结果惊人:原本能被检测出的 AI 文本,在经过语义改写后,Turnitin 和 GPTZero 均给出了“100% 原创”的误判。
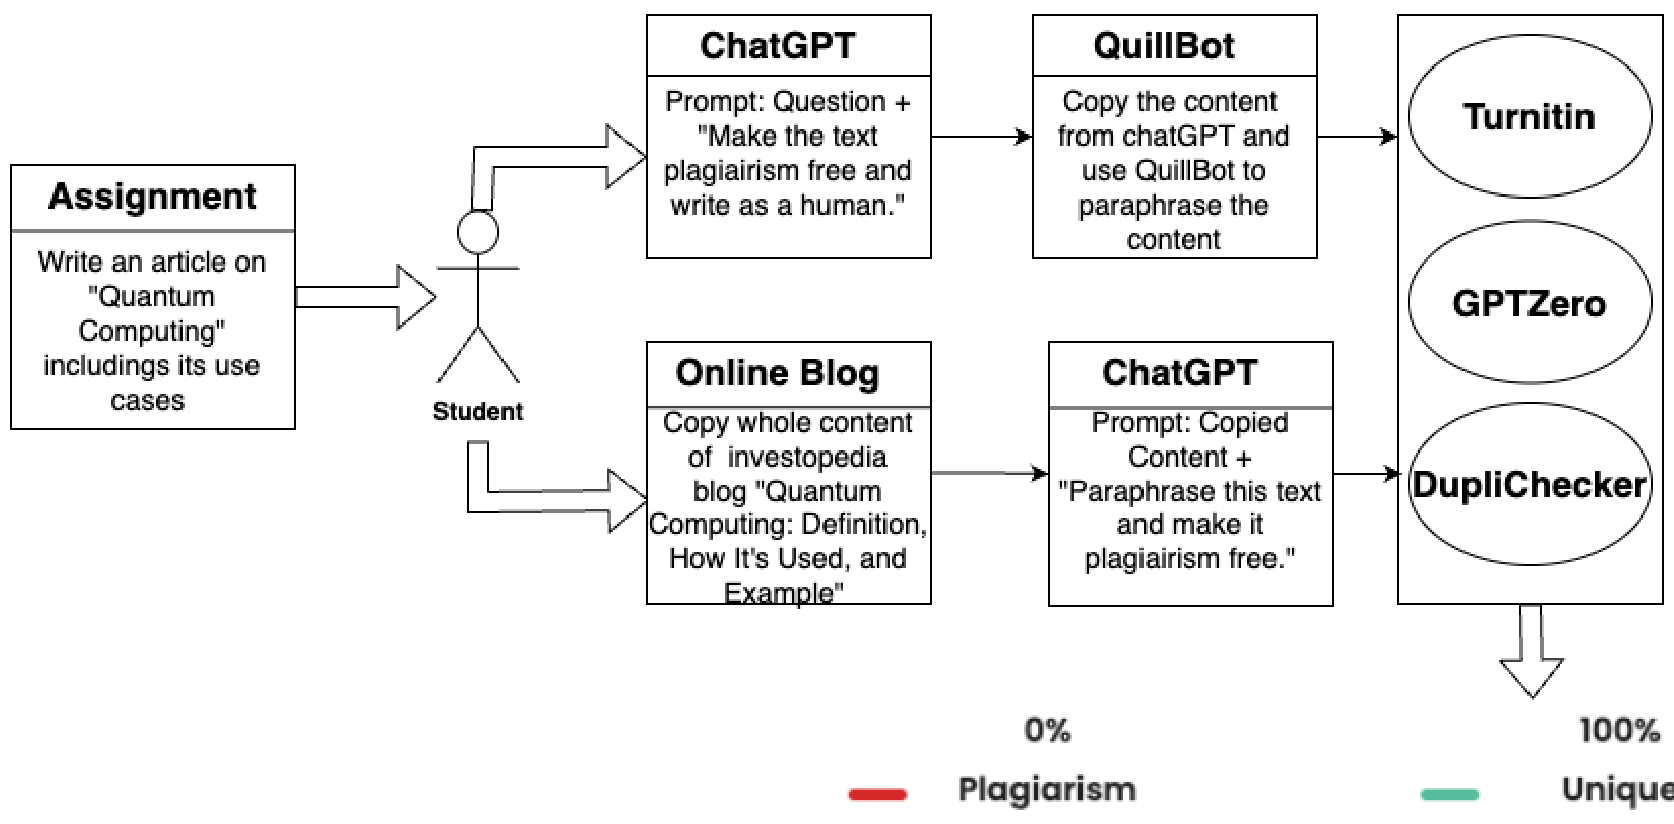 图 2:学生利用 AI 生成内容结合改写工具绕过检测器的典型路径
深度洞察:为什么 100% 的检测是不可能的?
- Inductive Bias 的冲突:LLM 的训练目标就是模拟人类。当 AI 达到 GPT-4 这种水平时,其逻辑分布与人类已高度重合。
- 逃避策略的低成本:只需加入一个空格(Single-space Strategy)或进行简单的同义词替换,就能让基于统计特征的检测器准确率大幅下降。
- 误报的代价:在学术场景下,诬陷一个原创学生为 AI 剽窃的代价(False Positive)远高于漏掉一个作弊者。目前没有任何工具敢承诺 0 误报。
实验数据对比
| 检测工具 | 准确率 (Acc %) | API 支持 |
|---|---|---|
| Originality.ai | 96% | 是 |
| GPTkit | 88% | 是 |
| Sapling | 60% | 是 |
| GPTZero | 40% | 是 |
数据分析:尽管部分工具在特定数据集上表现出色,但在实际学术环境中,面对改写和混合写作,表现差异巨大。
行业启示与未来展望
论文最终得出结论:“技术战争”没有终点。如果教育机构仅仅依赖检测工具,只会迫使学生寻找更隐蔽的作弊手段。
- 评估改革:从侧重结果的论文转向侧重过程的口试(Viva)、课室即兴写作和限时任务。
- 伦理共生:与其禁止,不如教导学生如何正确地“引用”AI,将其作为头脑风暴的辅助工具而非代笔。
- 可解释性检测:未来的检测工具不应只给出一个概率分数,而应结合 SHAP 等可解释性方法,标注出哪些段落存在明显的“机器逻辑”。
总结: 学术诚信的维护正从“警察抓小偷”的技术博弈,转变为教育评价体系的底层逻辑重构。LLM 不是学术的终结者,而是倒逼教育回归“思辨本质”的催化剂。