
用概率转移与熵正则重写监督微调:GEM 为什么比 CE 更适配 LLM 后训练
Preserving Diversity in Supervised Fine-Tuning of Large Language Models
本文研究 LLM 监督微调中的交叉熵损失导致输出多样性下降和对齐税问题,提出带辅助分布 q 的博弈化训练框架 GEM,理论证明其对应逆向 KL 最小化加熵正则;实验显示 GEM 保持下游性能并提升 best-of-N 与代码生成等 test-time scaling,同时降低对齐税。
核心速览
TL;DR
本文把 LLM 监督微调中的 CE 损失解释为一种从所有源词元向目标词元无差别搬运 logit 的过程,并指出这种 all-to-one、无终止点的转移会压缩输出多样性、加剧对齐税。作者引入辅助分布 q 作为元控制器,构建一个 min-max 博弈,证明其唯一均衡等价于逆向 KL 最小化加最大熵正则。在 Llama-3.1-8B 上,GEM 保持直接生成能力,chat best-of-N 胜率比 CE 高 3.1 个点,HumanEval pass@100 从 75.5 提升到 82.5,并在六项 OpenLLM 任务上把平均对齐税从 1.5 个点降到 0.3 个点。
背景定位
这项工作属于方法改进型:它没有更换模型架构,也没有增加奖励模型,而是重新设计 SFT 的损失函数。相比 CE 加 weight decay、NEFT 等经验正则,其本质不同在于把稀疏更新和停止规则统一到一个可解的博弈中,并把熵正则施加在受控分布匹配目标上,而不是简单地向 CE 加熵。这个定位与最近的 test-time scaling 趋势直接相关:后续 best-of-N、self-distillation 和 RL 都需要模型保留足够多的合理候选。
问题与动机
在 LLM 后训练流水线中,SFT 往往不是终点。模型先通过指令微调获得可解释、可标注的响应格式,再进入偏好学习、强化学习或推理时搜索。这些后续阶段都依赖采样和多样性:如果 SFT 把概率质量过早集中到少数回答上,后续探索就会缺少可用候选。论文把这一判断落到 CE 的梯度结构上:CE 只抬高目标词元,同时按当前概率压低所有非目标词元,因而会伤害语义相近但未被标注覆盖的合理替代。
这一机制在有限 SFT 数据中尤其危险。预训练阶段数据量巨大,CE 对替代概率的压缩可以被海量样本摊薄;SFT 阶段数据规模和覆盖范围都有限,开放任务中同一个 prompt 可能有多种合理回答、风格或推理路径。若 CE 仍然把所有非目标词元都当作需要惩罚的对象,模型不仅会降低多样性,还可能擦除预训练知识,表现为 alignment tax。论文认为 weight decay 和 embedding noise 是间接修补,没有直接约束分布本身;直接给 CE 加熵又会推高词表尾部的无意义 token,因此需要一个既能保护替代答案、又不放大噪声的分布匹配目标。
核心章节:把 SFT 改写成受控概率转移
交叉熵:被忽视的 logit 流
论文首先从 CE 的形式出发:
其中 是 Transformer 参数, 是条件生成分布, 是提示分布, 是监督数据中给定提示的条件响应分布。这个目标只关心观测响应 的对数似然,因此它把训练信号全部放在真实标签上,不显式保护其他语义上可能成立的词元。若 在 SFT 中不建模,它只是常数;若 由有限样本近似,CE 实际上等价于最小化经验 forward KL,这适合预训练的海量数据,但不一定适合开放生成和小规模 SFT。
接着论文把 CE 的梯度写成 logit 流:
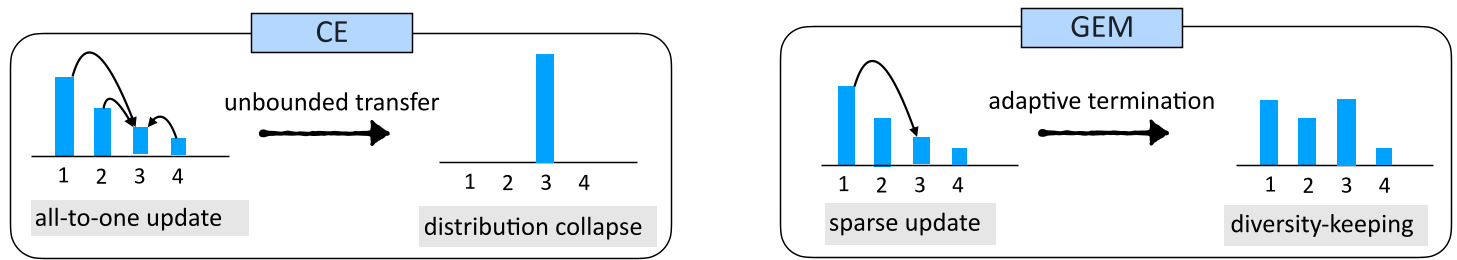
这里 是当前要学习的目标词元, 是词表大小, 是模型给词元 的概率, 是第 位为 1、第 位为 -1 的向量。相比原始负梯度,这个式子把 CE 写成一条 logit 流:每个非目标词元 向目标词元 转移 的 logit。该流的守恒性意味着目标词元获得的 logit 恰好等于所有源词元流出的总和,因此训练初期目标词元被快速抬高,而其他词元按其当前概率被等比例压低。若训练继续到所有源词元概率接近零,分布会塌缩到目标词元,这正是 CE 在有限 SFT 数据中容易过度记忆和减少多样性的机制。
辅助分布 q:把转移权交给元控制器
GEM 的核心改动是引入辅助分布 ,让 决定哪些词元参与概率转移。论文给出的博弈形式为:
这里 是待训练模型分布, 是辅助分布, 是监督数据中的真实响应词元, 是由 采样出的生成词元。第一个期望在 下压低生成词元的概率,第二个期望在真实词元上抬高概率;与 CE 的关键差异是压低哪些词元由 决定,而不是由模型当前分布 全量决定。若 ,该项会退化为 CE 的 all-to-one 流;若 只集中在少数高置信词元上,它就把稀疏更新规则编码进目标。这个 min 项因此不再只是拟合标签,而是控制概率转移的方向。
与 min 项相对的是 的优化目标:
这里 被解释为元控制器,它希望把概率放在 概率较高的词元上,同时 限制它过度尖锐。当 时, 退化为指向 中最大概率词元的 Dirac 分布;当 时, 的闭式解是 。若 ,,训练目标恢复 CE;若 小于 1, 比 更尖锐,低概率词元对转移的贡献被压缩,从而保护预训练阶段已经学会但当前数据未覆盖的替代可能。若 大于 1, 会更平滑并鼓励少数词元也参与转移,论文没有采用这种设置,因为它会进一步削弱多样性。
在这一视角下,GEM 的梯度可以写成:
这个梯度与 CE 的结构相同,但权重从 换成 。它说明 GEM 仍然在做 logit 流,只是流的强度由辅助分布 重新分配: 大的源词元承担更多概率转移, 小的源词元几乎不被更新。相比 CE,这个改动把更新哪些词元从隐式全量惩罚变成了显式受控选择;若 退化为 Dirac,算法只纠正最自信的错误预测,若 ,算法回到 CE 的密集更新。单 token 原型中的停止条件可以理解为:一旦目标词元成为最高概率词元,继续把其他词元概率压到零的边际收益下降;在博弈形式中,这一思想由熵正则和 的封闭解吸收。
理论依据:逆向 KL 加熵正则
论文随后证明,当真实条件分布满足 且 时,博弈存在唯一 Nash 均衡:
这里 是真实条件分布, 是控制平滑程度的超参。均衡点说明 最终恢复数据分布,而 是 的 温度平滑版本。相比 CE 试图逼近 并把概率质量推向单点,GEM 在 与 之间保留一个由 控制的平滑度。若 ,,算法趋向 CE;若 ,熵正则变强,但论文指出当 且 为 Dirac 时最优 不唯一且解析困难,因此主结果依赖 。
论文进一步把这个均衡对应到一个分布匹配目标:
其中 是 到 的逆向 KL 散度, 是 的熵,论文取 ,因此 越小、 越大,熵正则越强。这个目标把接近数据和保持多样放在同一个函数里:逆向 KL 负责不让 在 没有质量的地方乱给概率,熵项负责保留合理候选。然而逆向 KL 直接优化在实践上困难,因为它包含 ,而 SFT 只有有限样本;CE 对应 forward KL,可以从样本估计。GEM 的博弈形式绕开这一难点,因为它只需要当前模型 logits 和真实标签,不需要显式估计 的密度。
算法实现利用两个性质保持 CE 级效率。第一, 由当前模型 logits 除以 再 softmax 得到,不需要维护第二个网络,因此没有 GAN 判别器的显存开销。第二,训练损失直接对 求和,而不是从 随机采样,因此梯度方差低于依赖随机采样的对抗训练。论文报告在 batch size 4、序列长度 2048、词表 128k 的设置下,额外存储 约 2 GB,相对梯度、优化器状态和激活值可忽略。
实验与证据
主结果:多样性转化为 test-time scaling
论文主实验使用 Llama-3.1-8B 在 UltraFeedback 上微调,学习率 ,batch size 128,最大序列长度 2048,训练 3 个 epoch;GEM 取 。Section 6.1 报告了四种模型的生成熵,HumanEval pass@100 也列在同一设置下:
| 方法 | 生成熵 | HumanEval pass@100 |
|---|---|---|
| CE | 0.42 | 75.5 |
| CE + WD | 0.41 | 76.6 |
| NEFT | 0.43 | 75.6 |
| GEM | 0.76 | 82.5 |
这张表把机制和结果对应起来:CE、CE + WD 和 NEFT 的生成熵都在 0.4 附近,而 GEM 的生成熵达到 0.76,说明 GEM 确实保留了更多候选。代码任务中 GEM 比 CE 高 7.0 个点,相对提升 9.3%;CE + WD 只从 75.5 提到 76.6,NEFT 基本没有改善。论文还指出 GEM 达到可比性能所需的采样预算约为基线的一半,这与多样性带来更高 best-of-N 收益的机制一致。
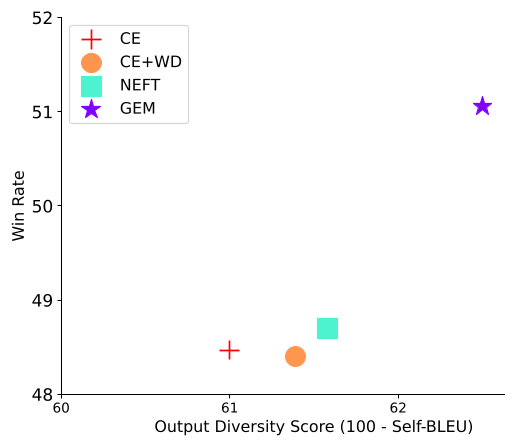
Table 3 报告了不同 beta 在 chat 任务上的随机采样和 best-of-N@32 结果:
| 配置 | 随机采样 | best-of-N@32 |
|---|---|---|
| CE | 24.5 | 47.3 |
| GEM (β = 1.0) | 24.7 | 47.5 |
| GEM (β = 0.9) | 24.7 | 48.3 |
| GEM (β = 0.8) | 24.8 | 49.4 |
| GEM (β = 0.7) | 24.9 | 50.4 |
| GEM (β = 0.6) | 24.3 | 50.1 |
这张表验证了理论中的退化关系: 时 GEM 接近 CE, 降低后 best-of-N@32 从 47.5 逐步升到 50.4。最佳设置 不仅把 chat 胜率提高 3.1 个点,还把随机采样从 24.5 提到 24.9,说明直接生成能力没有被牺牲。 的随机采样略低于 CE,但 best-of-N 仍然保持 50.1,说明采样收益对轻微多样性变化有一定鲁棒性。
对齐税与遗忘
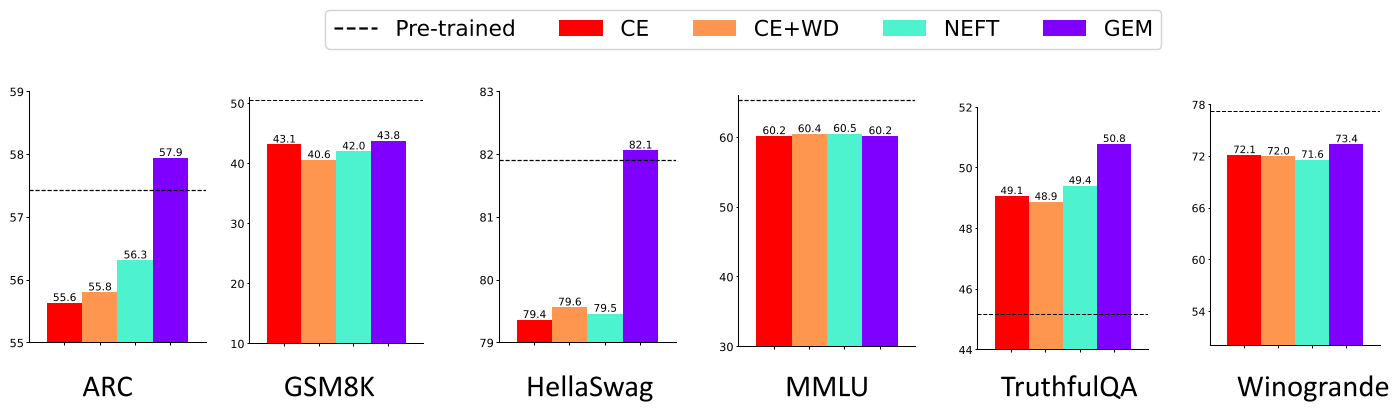
Figure 6 在 ARC、GSM8K、HellaSwag、MMLU、TruthfulQA 和 WinoGrande 上比较 SFT 前后的性能。基线模型在多数任务上下降,CE 下降最明显;GEM 的平均下降为 0.3 个点,CE 为 1.5 个点,约 80% 的 alignment tax 减少。论文还通过参数空间 l2 距离显示 GEM 更靠近预训练模型,说明保留多样性的更新同时减少了参数漂移。这个结果把问题与动机中的两个机制连接起来:多样性不是与知识遗忘独立的现象,而可能是预训练知识仍被保留在概率分布中的外显指标。
证据质量评估
这些主结果集中在 Llama-3.1-8B 和 UltraFeedback 上,因此最直接支持的是中等规模指令微调场景。论文附录扩展到 Qwen-2.5-3B、Qwen-2.5-7B、Gemma-2-9B 和 Llama-3.1-70B,除 70B 外使用 rank 16 LoRA,并声称趋势保持;但主文没有给出每个模型的完整数字表。beta 敏感性只在 chat 任务上报告,0.6 到 0.8 都优于 CE 的 best-of-N@32,0.6 的随机采样略低于 CE,说明直接生成能力对 beta 并非完全鲁棒。代码任务和对齐税没有给出完整的 beta 扫描,因此 0.7 的普适性仍主要依赖跨模型扩展和同一设置下的复现。
另一个边界是理论假设词表有限且 。真实 LLM 词表虽然有限,但序列级分布非常复杂,论文通过 reset trick 把多步问题拆成单步条件匹配:前缀来自数据分布,只在当前时间步做分布匹配。这个设计保留了一阶优化的计算优势,但引入了近似成分。论文附录也说明直接对整条序列做随机近似会在 80 步后失败,因此 reset 不是可选工程技巧,而是序列扩展的关键部分。
深度洞察与总结
这篇工作的核心贡献不是简单地给 CE 加熵,而是重新定义 SFT 的损失:把训练看成概率质量在词元间的流动,并用辅助分布 决定流动方向、强度和停止边界。CE 的问题在于全量转移和无界转移:它惩罚所有非目标词元,并把分布推向单点塌缩。GEM 的解法是通过 的闭式解实现稀疏更新,通过逆向 KL 加熵正则保证最终分布既接近数据又保留多样候选。实验上,这种保留直接转化为 best-of-N 和 pass@100 的提升,并伴随 alignment tax 的下降。
局限性的第一点是超参迁移:主实验固定 ,其他模型沿用同一设置,论文没有报告每个任务或模型是否重新搜索过。第二点是数据边界:主结果使用 UltraFeedback,跨指令数据集的稳定性没有在主文中展开。第三点是理论边界: 情况下最优解不唯一,论文将其留给未来工作;序列级 reset 也意味着单 token 理论到长序列优化之间存在近似。
更有技术含量的延伸不是简单替换训练任务,而是把 GEM 用作后训练的冷启动器。对 online RL,保留的尾部分布可以提供更多可探索样本,避免 SFT 模型过早 collapse 后奖励模型只能选择狭窄答案;对 RLHF,这有助于防止 SFT 阶段 preference collapse 被进一步放大;对 best-of-N 自蒸馏,GEM 产生的高熵候选更可能包含可蒸馏的高质量样本,从而降低 recursive fine-tuning 中的 mode collapse。换言之,GEM 的价值不在 SFT 本身刷分,而在于把 SFT 改造成更适合后续采样、搜索和迭代优化的概率分布起点。