
Q-Sparse:开启全激活稀疏时代,让大模型推理更轻快
Q-Sparse_ All Large Language Models can be Fully Sparsely-Activated
本文提出了 Q-Sparse,一种简单高效的大语言模型(LLM)全激活稀疏化方法。通过在训练中引入 Top-K 稀疏化和 Straight-Through Estimator (STE),Q-Sparse 能够使 LLM 在推理时仅激活部分神经元,并在 1-bit (BitNet b1.58) 和全精度模型上均实现了推理效率与模型性能的 SOTA 平衡。
核心速览
随着 LLM 规模的爆炸式增长,推理效率已成为阻碍应用落地的“天花板”。微软研究院(MSRA)近期发布的 Q-Sparse 给出了一份令人振奋的答卷:通过简单的 Top-K 机制和训练技巧,我们可以让任何大模型都具备“按需激活”的能力。
TL;DR: Q-Sparse 实现了一种**全激活稀疏(Fully Sparsely-Activated)**机制,支持从零训练、持续训练和微调。它不仅能让全精度模型在只激活不到一半神经元的情况下保持 SOTA 性能,更能与 1-bit 模型(BitNet b1.58)深度融合,挑战推理能效的物理极限。
痛点深挖:为什么稀疏化这么难?
在大模型的研究中,我们面临一个尴尬的现实:模型参数虽然多,但每次推理时全量计算是一种极大的浪费。
- 权重稀疏化:虽然能减小模型体积,但在 GPU 上很难跑出实际加速比(非结构化稀疏不友好)。
- 激活稀疏化(ReLU):过去常通过 ReLU 产生零值,但这种稀疏是“被动”且不可控的,且随着模型规模增大,由于梯度消失问题,很难在保持精度的前提下提高稀疏度。
- 计算瓶颈:LLM 推理的真正杀手是内存 I/O。如果能减少激活值的传输和计算,将直接提升推理吞吐。
方法论详解:Q-Sparse 的“暴力美学”
Q-Sparse 的核心公式异常简洁。对于任意线性层 ,它引入了一个 Top-K 掩码 : 其中 。
1. 梯度消失的终结者:STE
传统的反向传播会使掩码为 0 处的梯度也变为 0,导致模型无法学习。Q-Sparse 引入了 Straight-Through Estimator (STE),梯度在回传时直接“跳过”掩码,保持了梯度的流动性,这在底层网络结构的训练中至关重要。
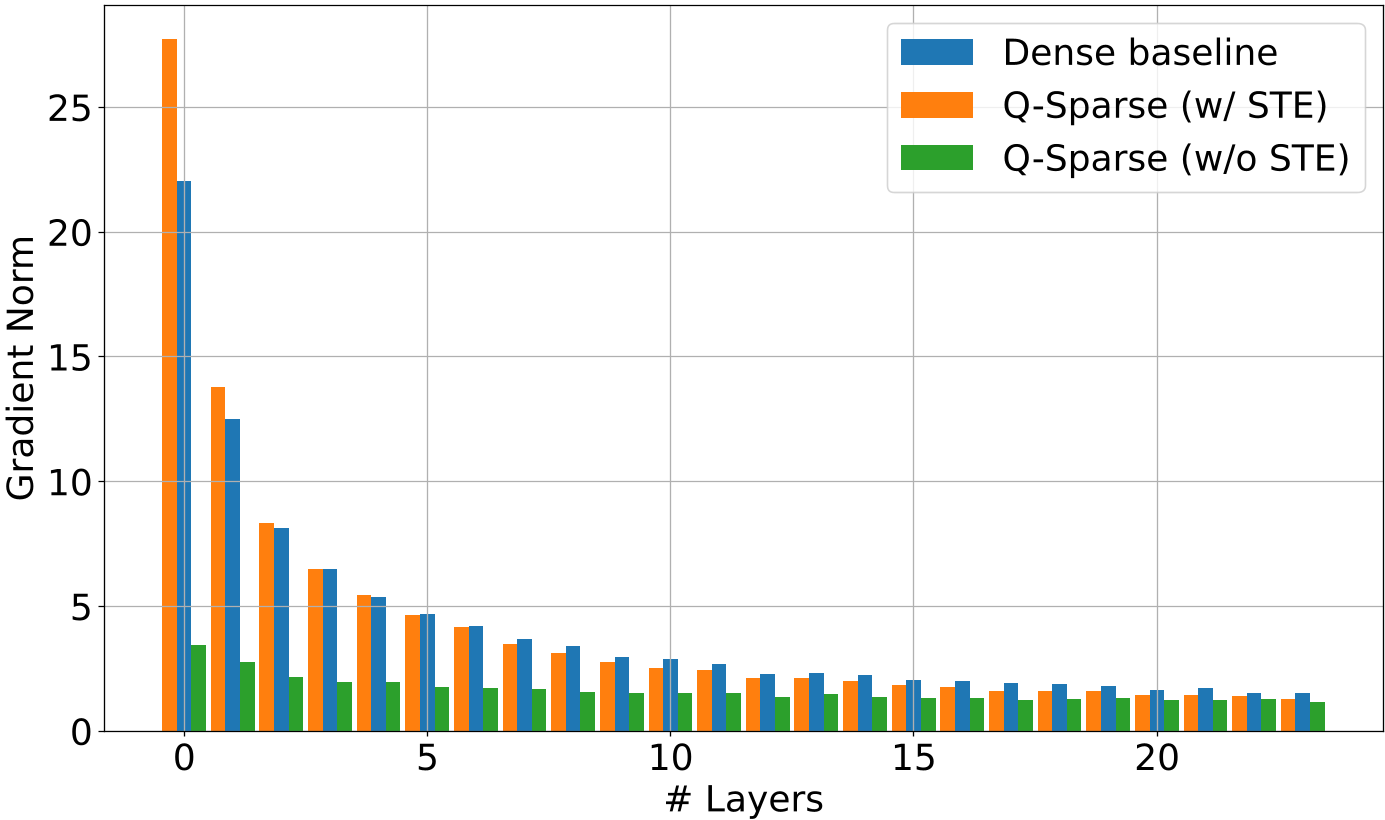 图 1:可视化证明了在不使用 STE 的情况下,底层梯度的坍塌;而 STE(绿色)能保持模型的可学习性。
2. Block Q-Sparse:拥抱硬件
为了解决 Top-K 操作在 GPU 批处理模式下不友好的问题,作者提出了 Block Q-Sparse。通过在 M 个连续元素内强制保留 K 个最大值(如 N:M 稀疏),它能够完美契合现代 GPU 硬件的稀疏指令集。
下一个 Scaling Law:推理最优(Inference-Optimal)
这篇论文最深刻的贡献在于其对 Scaling Laws 的重新审视。作者发现,稀疏化模型的性能提升遵循指数定律。
- 惊人发现:在大模型语境下,参数量 越大,稀疏模型与稠密模型(Dense)之间的性能差距越小。
- 最优稀疏率:对于全精度模型,45.58% 的稀疏率是性能与开销的平衡点;对于 1.58-bit 模型,这个值可以进一步大胆提升至 61.25%。
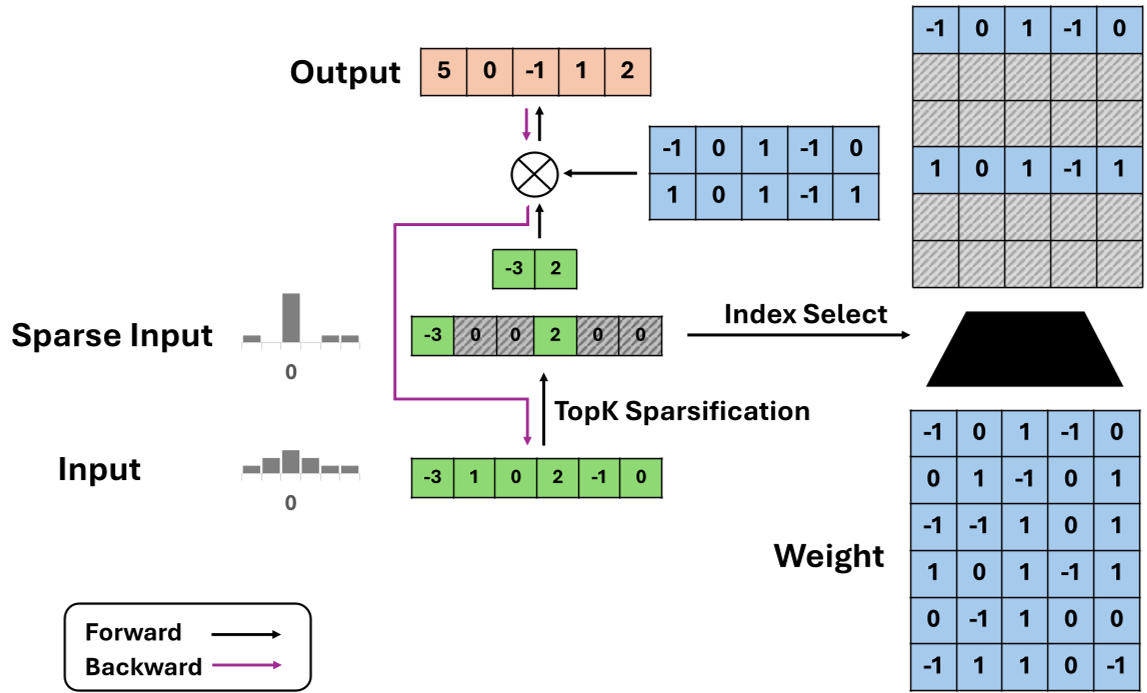 图 2:Q-Sparse 在相同推理预算下,Loss 曲线始终优于稠密基线。
实验与结果:Mistral 7B 的华丽转身
在多项 NLP 基准测试(ARC, MMLU, HellaSwag 等)中,Q-Sparse 表现优异:
- 持续训练表现:基于 Mistral 7B 持续精调,Q-Sparse 在仅激活 3.8B 参数(稀疏率约 45.7%)时,平均分达到了 63.7,极力逼近 Dense 基线的 64.6。
- 对比优势:相比前人工作 ReLUfication,Q-Sparse 在实现更高稀疏度的同时,精度优势显著(+2.9% 以上)。
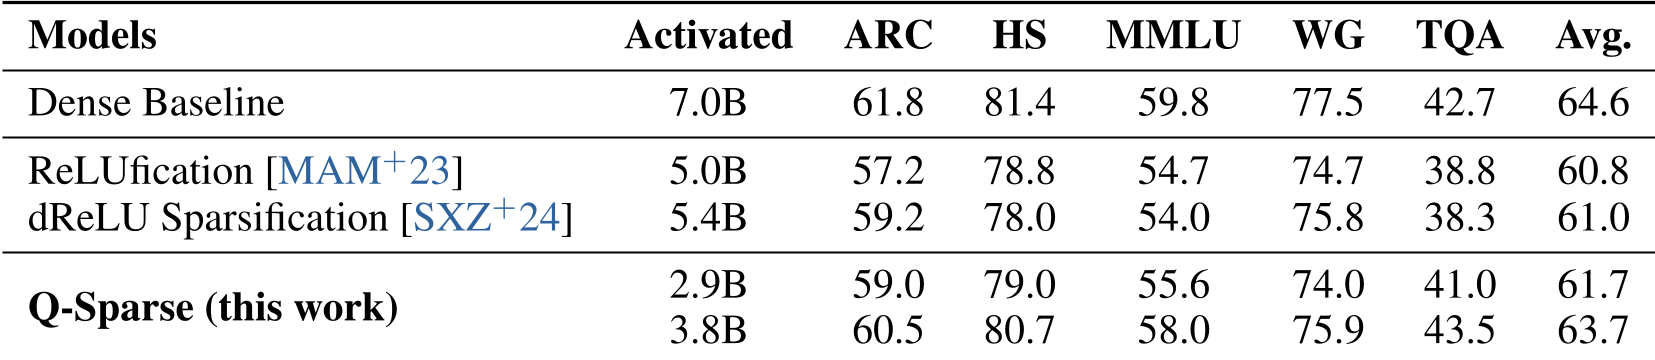 表 1:Q-Sparse 在激活参数大幅减少的情况下,依然保持了竞争力。
深度洞察与总结
Q-Sparse 标志着 LLM 效率研究进入了“协同优化”阶段。它不仅仅是一个训练技巧,更是与 1.58-bit (BitNet) 以及 YOCO (KV Cache 优化) 并列的效率三剑客。
Takeaway: 未来的 LLM 将不再是“沉重的黑盒”。通过 Q-Sparse 这种结构化稀疏技术,我们可以实现:
- 权重 1-bit + 激活稀疏化 + 极简 KV Cache
这套“组合拳”将使在手机、智能手表等端侧设备上高效运行千亿级 LLM 成为可能。
局限性: 虽然 Top-K 本身简单,但实现极高比例的硬件加速仍需定制化的 Kernel 支持。此外,对于长文本场景下 Top-K 选取的稳定性还需更多实测。