
[ACL 2024] AGR:基于大模型三阶段思维链,重塑零样本开放域问答检索
Analyze, Generate and Refine: Query Expansion with LLMs for Zero-Shot Open-Domain QA
本文提出了 AGR (Analyze-Generate-Refine),一种基于大语言模型 (LLM) 的思维链式查询扩展方法,专门用于零样本 (Zero-shot) 开放域问答任务。AGR 通过分析问题、生成候选答案及结合外部知识库精炼查询,在多个基准数据集上达到了 SOTA 性能。
TL;DR
传统的查询扩展(Query Expansion, QE)要么死板(基于统计),要么“挑食”(依赖监督数据)。本文提出的 AGR (Analyze, Generate, and Refine) 框架通过 LLM 的三段式推理,成功实现了在没有任何领域训练数据的情况下,让检索器“读懂”用户的真实意图。实验表明,AGR 在零样本场景下不仅检索更准,且端到端问答的精确匹配度(EM)甚至超越了顶尖的有监督模型。
1. 痛点:为什么 LLM 直出的 QE 仍然不够好?
在 OpenQA 系统中,用户的问题往往简短且存在语义鸿沟。现有的解决方法主要有:
- 有监督 QE (如 GAR, EAR):需要大量标注数据,换个数据集(跨领域)就哑火。
- LLM 直出 (如 Query2Doc):直接让 LLM 生成一段相关文本。虽然方便,但存在两大隐患:一是缺乏分析,模型可能没理解清楚用户的细微需求;二是质量失控,模型一旦产生幻觉(Hallucination),错误的扩展项会导致检索器南辕北辙。
2. 核心方案:Analyze, Generate and Refine
AGR 的直觉非常清晰:模仿人类解决问题的步骤。既然 LLM 擅长推理,那就让它在扩展查询之前先“思考”三步:
2.1 分析 (Analyze)
并不是直接生成答案,而是先要求 LLM 提取查询中的 Key Phrases,并生成一份 Question Analysis。这相当于在进行语义对齐,确保模型抓住了问题的关键点(Inductive Bias)。
2.2 生成 (Generate)
AGR 利用分析结果作为 Context,采样生成多个候选答案。关键的一步在于,它引入了 Contextual References (CRs):
- 模型利用候选答案初步检索库中的 Top-K 文档。
- 再将这些真实的文档作为上下文,喂回给模型生成第二轮更可靠的扩展项。这一步通过外部知识库显著降低了模型的幻觉率。
2.3 精炼 (Refine)
面对一堆候选扩展项,AGR 要求 LLM 进行“自我审查”(Self-Review),辨别哪些是噪声,哪些是真理,最后合并成一个逻辑自洽、高度相关的最终扩展文本。
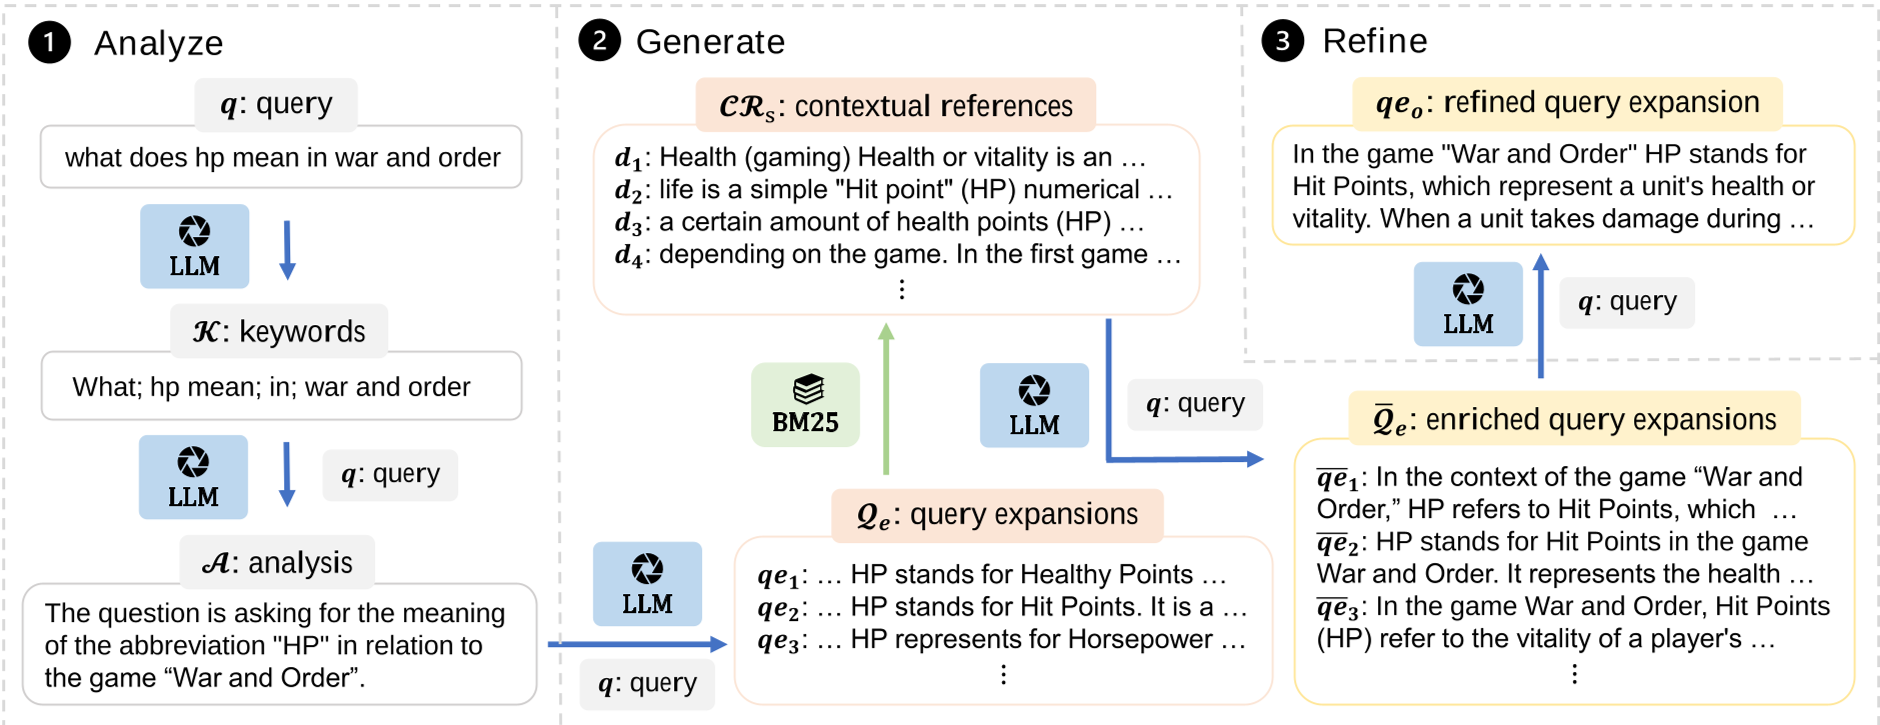 图 1:AGR 框架流程图,展示了从问题到最终 QE 生成的三个渐进子任务。
3. 实验战果:以零样本之姿力压有监督
在 Natural Questions (NQ), TriviaQA, WebQ 等四个数据集上的测试显示,AGR 的表现极为强悍。
- 检索性能:在零样本场景下,AGR 的 Hit@5 接近甚至超过了强力的有监督基线 EAR-RD*(该基线在特定领域内训练过)。
- 端到端 QA:这是 AGR 最出彩的地方。在 NQ 数据集上,其 EM@1 分值达到 37.73,远超同类基于 LLM 的 QE 方法。
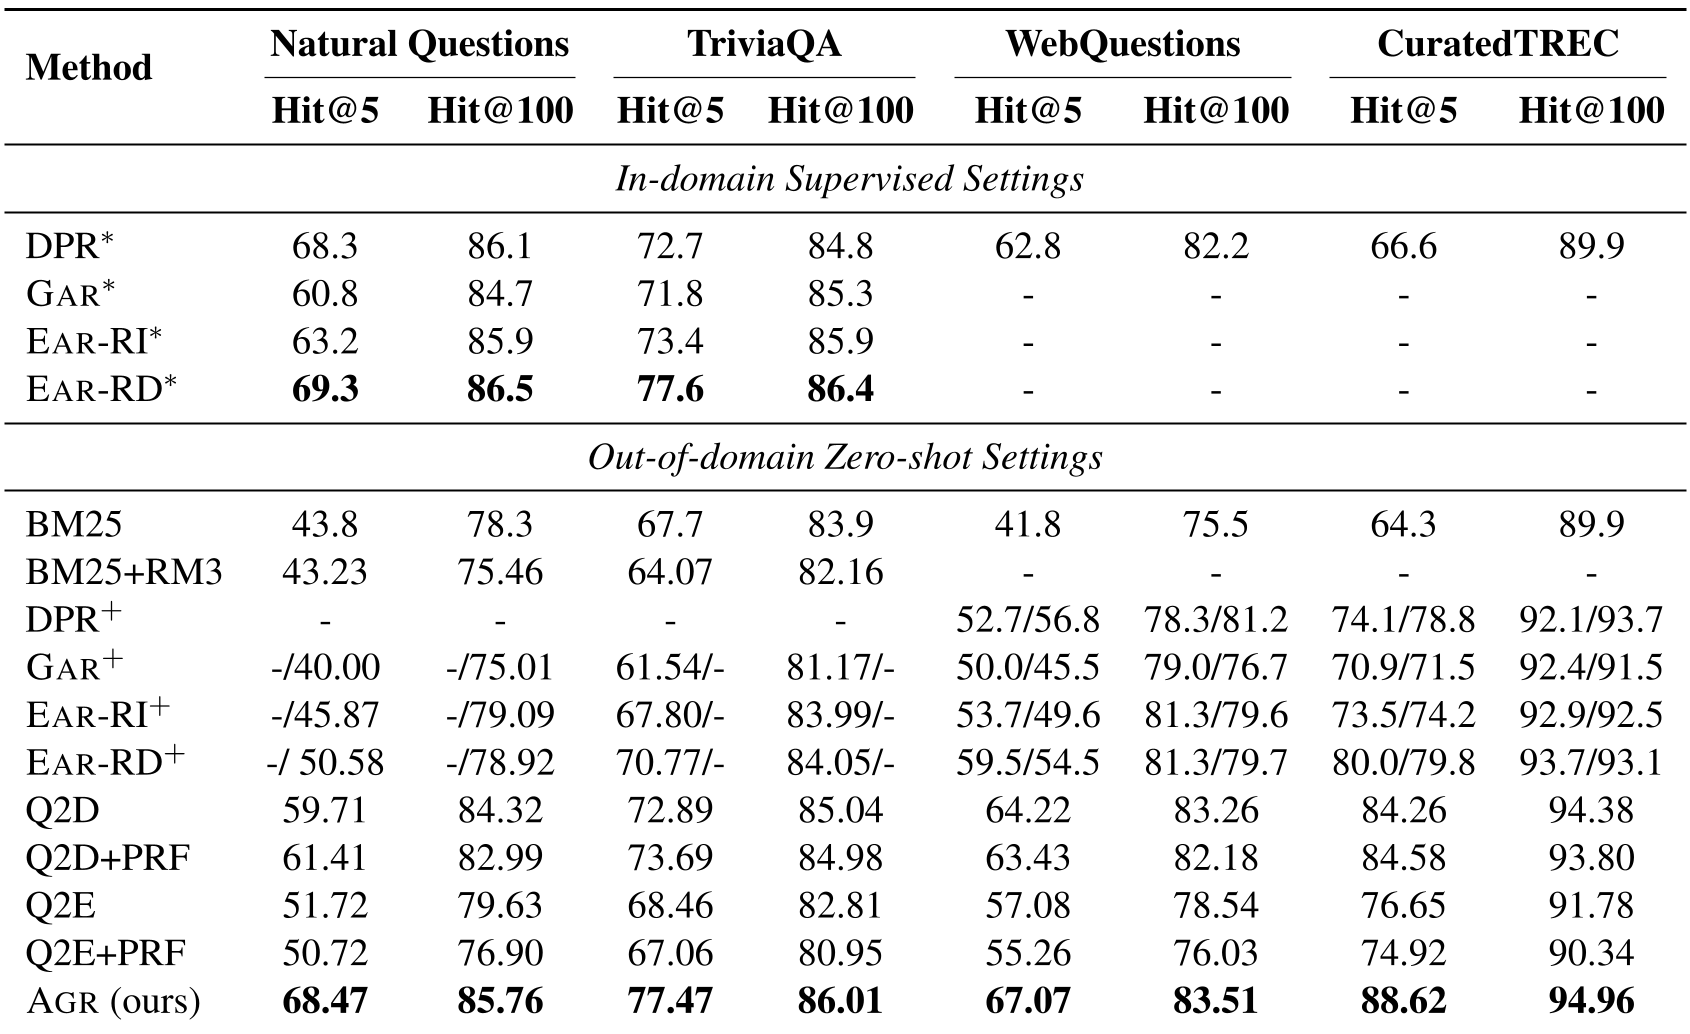 表 1:AGR 与各种基线在检索准确率上的对比。可以看到 AGR 在零样本(Out-of-domain)设置下的统治力。
4. 深度洞察:为什么 Refine 如此重要?
论文的消融实验(Ablation Study)给出了有趣的结论:如果不加 CRs (外部参考文档),性能会大幅崩塌(Hit@5 下降约 4.4%)。这说明纯靠 LLM 的内部知识是不够的,必须通过“生成-检索-二次生成”的闭环来纠偏。
此外,作者发现 AGR 检索出来的 Top-1 文档质量非常高。在案例研究中,对比 EAR-RD 模型,AGR 生成的 QE 能够引导检索器找到内容更充实、更贴合答案核心语境的文档,从而让后续的 Reader 组件更容易给出正确答案。
5. 总结与局限
AGR 提出了一种优秀的“检索增强式查询扩展”范式。它不需要繁琐的微调,非常适合需要快速部署且对准确率要求极高的生产环境。
其局限性在于:由于涉及多次 LLM 调用(分析、生成、精炼),其时间开销 (Inference Latency) 较大(大约是普通方法的 2-3 倍)。未来如果能通过并行化推理或更小的模型蒸馏来优化,该方法将具有更大的工程应用价值。
关键词: OpenQA, Query Expansion, LLM, Zero-shot, Chain-of-Thought