
RaFe:无需标注,让排序器教小模型如何“重写”查询
RaFe: Ranking Feedback Improves Query Rewriting for RAG
本文提出了 RaFe 框架,一种利用排序器(Reranker)反馈来优化 RAG 系统中查询重写(Query Rewriting)的小模型训练方法。通过将公共 Reranker 的评分作为强化学习信号,RaFe 在无需人工标注的情况下显著提升了检索精度和下游 QA 任务的性能。
TL;DR
在检索增强生成(RAG)领域,如何把用户的原始提问(Query)改写得更利于检索,是提升最终端到端效果的关键。浙江大学与阿里巴巴的研究者近期提出了 RaFe (Ranking Feedback) 框架。其核心思想是:不用昂贵的 GPT-4 标注,也不要人工对齐,直接让 RAG 系统里的 Reranker(排序器)作为导师,通过它给出的评分来训练改写模型。
现状痛点:为什么查询重写这么难训练?
尽管 LLM 很强大,但在实际生产中,为了性能和成本,我们更倾向于用一个小模型(如 Qwen-7B)专门负责改写。然而,训练这个小模型通常面临两个坎:
- 标注代价高:传统方法需要知道哪些文档是“真正确”的,这需要大量人力。
- 信号不匹配:有时 LLM 觉得改写得很好,但底层的检索器(Retriever)却听不懂,导致搜不出东西。
研究团队发现了一个深刻的直觉:查询改写的终极目标是搜到好文档,而 Reranker 的本职工作就是评价文档好不好。 既然如此,何不让 Reranker 直接给改写结果打分?
RaFe 方法论:排序器即反馈
RaFe 的训练分为两个阶段:
- SFT(冷启动):先用 LLM 生成少量的改写数据进行基础微调。
- 反馈训练(核心):
- 离线模式:利用 DPO 或 KTO 算法。系统根据 Reranker 的平均得分设定阈值,将改写结果分为“好”与“坏”,构造偏好对进行优化。
- 在线模式:利用 PPO 算法。将 Reranker 的评分直接作为 Reward(奖励值),实时指导改写模型的策略更新。
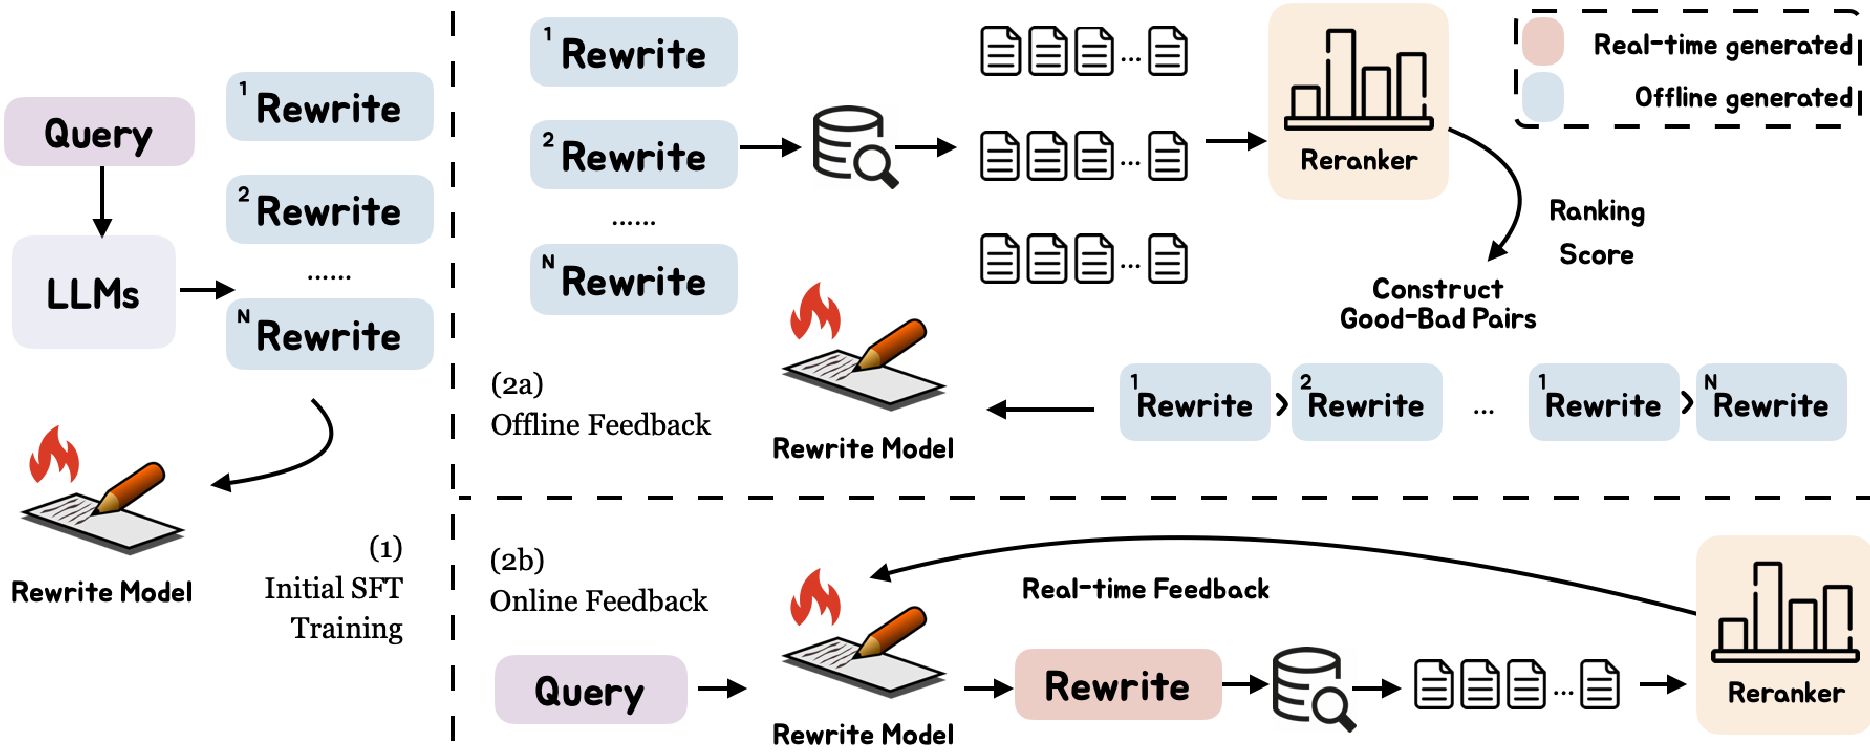 图 1:RaFe 框架总览,包含 SFT 阶段和基于 DPO/PPO 的反馈阶段。
实验结果:小模型也能逆袭
RaFe 在 English (NQ, TriviaQA, HotpotQA) 和 Chinese (WebQA) 等多个数据集上进行了验证。
- 性能提升:在
EXPAND-Ranked(即保留原查询并扩充重写查询,最后统一排序)设置下,RaFe 相比原始检索(OQR)有显著提升,QA 准确率普遍增长 2%-3%。 - 成本优势:与使用大模型(LLM)作为反馈源相比,RaFe 的反馈计算耗时从 78 小时骤降至 0.67 小时,极大地提升了迭代效率。
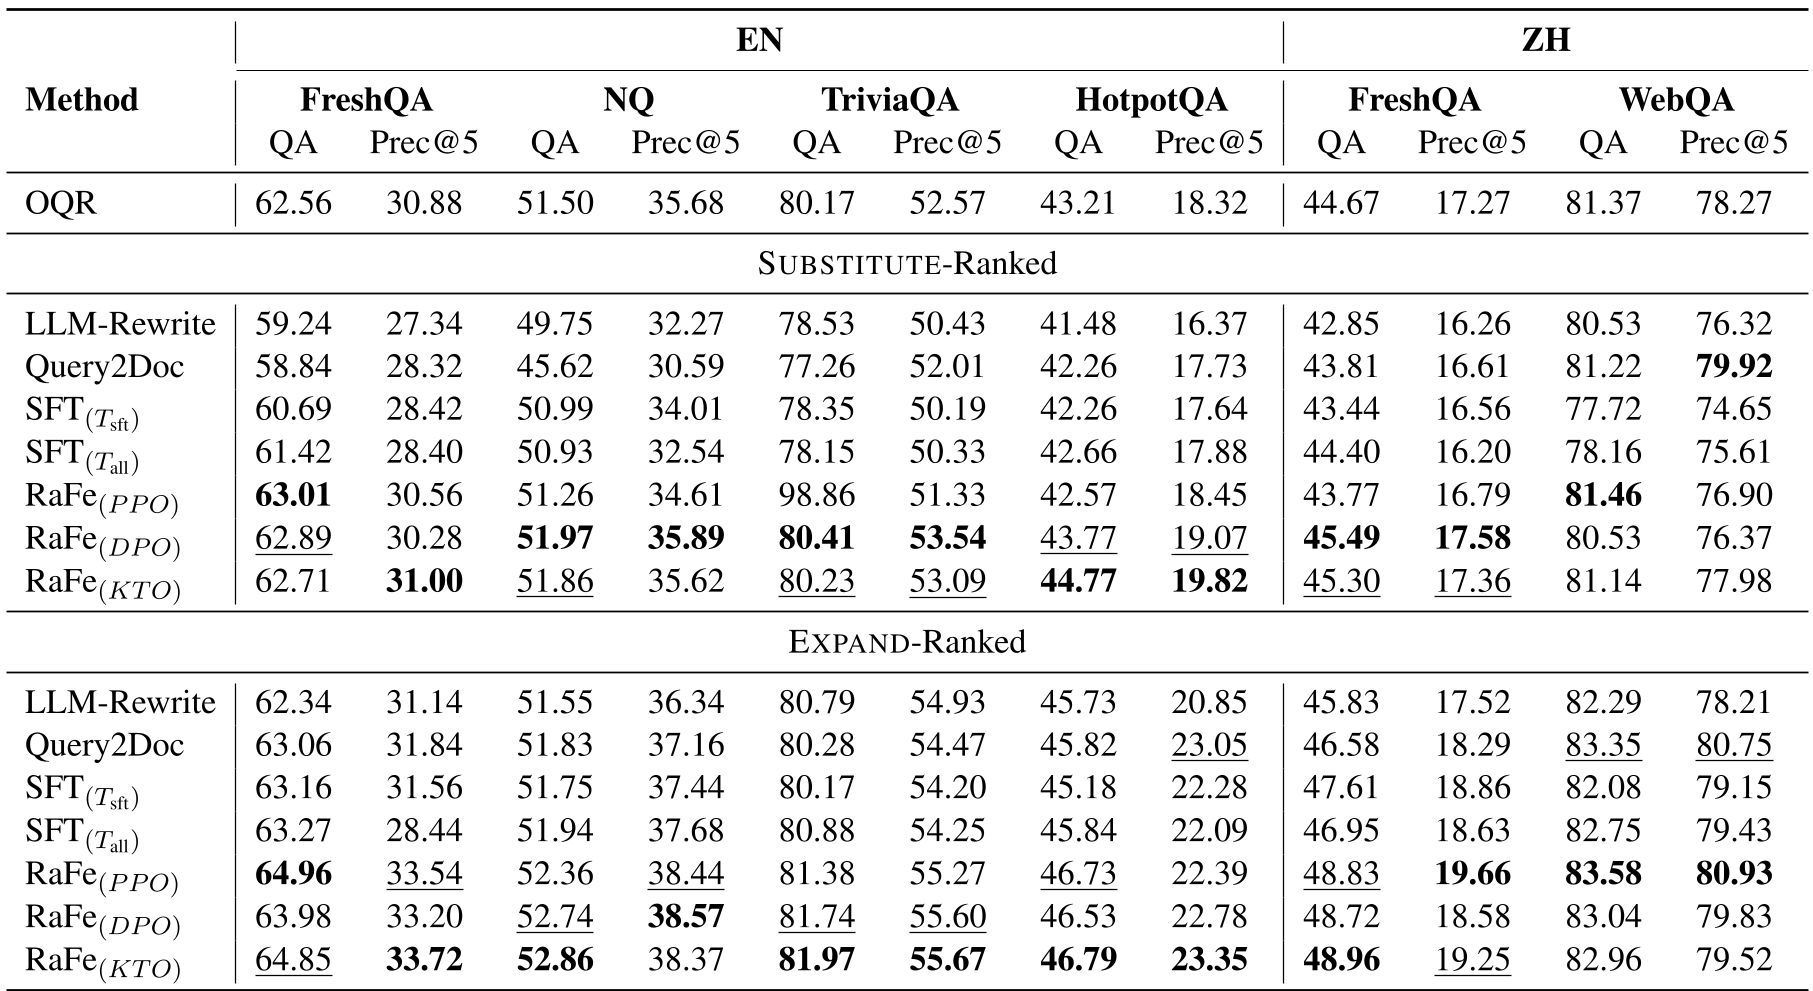 表 1:RaFe 在多个实验设置下的详细对比,可见其在 Ranked 模式下表现尤为突出。
深度分析:为什么 Reranker 反馈更管用?
作者通过 Case Study 揭示了 RaFe 相比简单 SFT 的三个独特优势:
- 语义保真度(Semantic Preservation):RaFe 能避免过度改写导致的语义偏移,更忠实于原意。
- 检索友好(Retrieval-Friendly Format):它能把冷僻词(如 Recipient)转换成检索器更容易索引的常用词(如 Winner)。
- 格式语感(Sentence Structure):由于直接向检索结果学习,RaFe 生成的句子结构更符合检索系统的“胃口”。
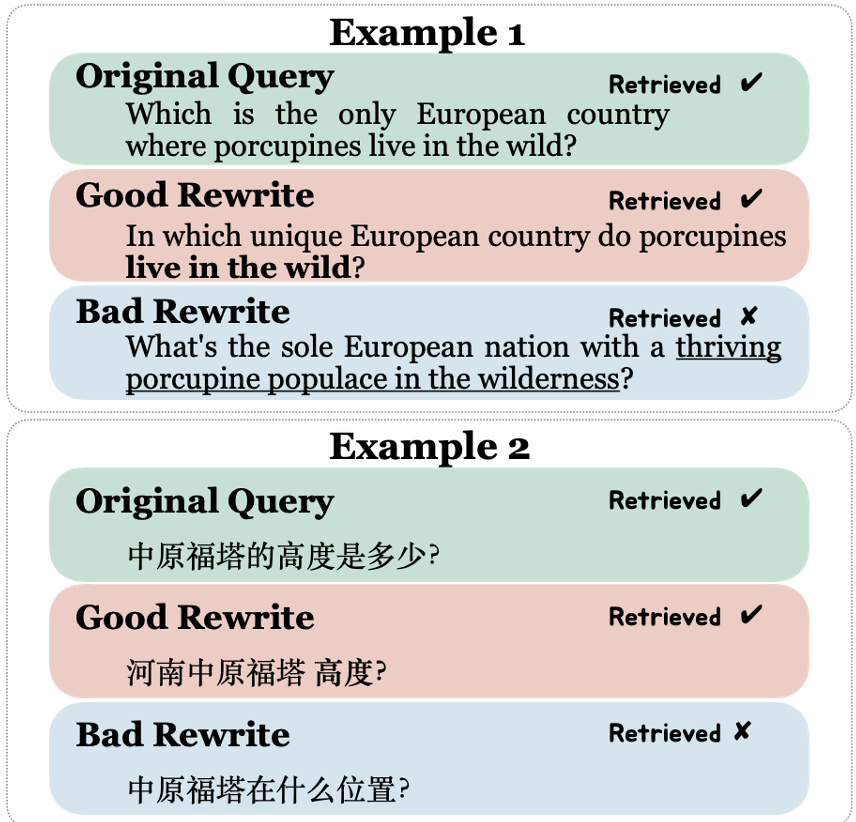 图 2:RaFe 改写案例,展示了其在修复语义歧义和优化检索格式方面的能力。
总结与未来展望
RaFe 证明了一个重要结论:在 RAG 链路中,组件之间的协同性比单个组件的“绝对智能”更重要。 通过将 Reranker 的排序直觉蒸馏给重写器,我们能以极低的成本获得泛化性极强的改写模型。
未来的研究方向可能包括:重写器与排序器的联合训练(Joint Training),真正实现整个 RAG 系统的内生对齐。
资深学术主编点评: 该工作最具启发性的一点在于它利用了检索管道内的“自洽性”。在追求 AGI 的路上,我们常常依赖更强的模型来教导弱的模型,但 RaFe 告诉我们,不同任务(如排序与生成)之间的目标一致性,也能产生高质量的学习信号。