
RAG-HAT:打破幻觉僵局,构建自进化的检索增强生成微调流水线
RAG-HAT: A Hallucination-Aware Tuning Pipeline for LLM in Retrieval-Augmented Generation
本文提出了 RAG-HAT,一种针对检索增强生成(RAG)场景的幻觉感知微调框架。该方法通过构建包含幻觉检测、自动化改写和 Direct Preference Optimization (DPO) 训练的流水线,在提升 LLM 回答质量的同时显著降低了幻觉率。
TL;DR
在检索增强生成(RAG)应用中,LLM 的“幻觉”一直是落地高可靠场景(如医疗、法律)的头号天敌。本文介绍的 RAG-HAT (Hallucination-Aware Tuning) 框架,通过一套高度自动化的流水线:检测幻觉 -> 生成解释 -> 自动化改写 -> 偏好微调 (DPO),在无需人工干预的情况下,显著降低了模型的幻觉率,并同步提升了回答的专业性与丰富度。
痛点深挖:为什么 RAG 依然会“胡言乱语”?
即便拥有了检索到的外部参考文档,LLM 依然面临以下挑战:
- Context-Awareness 不足:模型虽然读了参考资料,但在生成时会受到预训练权重中“先入为主”错误知识的影响。
- 边界模糊:很难界定什么是“合理的推理延伸”,什么是“无根据的虚构”。
- 数据困境:训练用于抑制幻觉的偏好数据集(Chosen vs. Rejected)通常依赖昂贵的人工标注,难以覆盖多样化的任务。
方法论详解:RAG-HAT 的核心机制
RAG-HAT 的精妙之处在于它构建了一个“闭环自校准”系统。
1. 两阶段检测模型 (Detection with Interpretation)
作者认为,简单的 True/False 标签不足以指导模型改进。他们基于 Llama-3-8B 训练了一个检测模型,分为两阶段:
- 第一阶段:专注于准确判断是否存在幻觉(Predict Only)。
- 第二阶段:引入 LoRA 训练,使模型能生成人类可读的解释和防御性建议(Defensive Advice)。
- 物理直觉:通过让模型“解释”为什么这行字是幻觉,为后续的改写提供了精准的坐标。
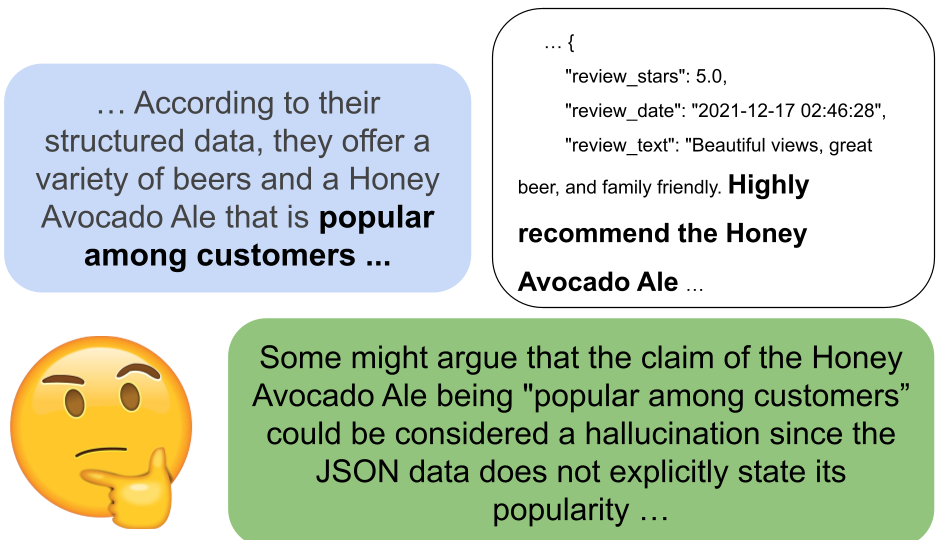 上图展示了“防御性建议”的实例:当模型根据单一评论过度推断产品流行度时,系统会标记该推论缺乏证据支持。
2. 自动化偏好数据集构建
利用检测模型的反馈,调用 GPT-4 Turbo 对原始有问题的回答进行“外科手术式”的改写:
- Chosen (优选):剔除了幻觉、修正了逻辑后的版本。
- Rejected (拒绝):原始的包含幻觉产生的文本。
3. OCP 策略:防止模型变得“唯唯诺诺”
单纯通过 DPO 抑制幻觉常导致副作用——模型为了不出错而缩短篇幅(Overly Cautious)。为此,作者提出了 OCP (Overly Cautious Penalization):通过随机删除 Chosen 样本中的句子构造额外的负样本,强迫模型在保持内容丰富度的同时减少幻觉。
实验与结果:全方位的性能飞跃
研究者在 Qwen1.5-4B-Chat 上验证了 RAG-HAT 的威力:
| 指标 | 原始模型 (Qwen) | RAG-HAT 优化后 | 提升幅度 |
|---|---|---|---|
| RAGTruth 幻觉率 | 40.9% | 29.9% | ↓ 26.9% |
| WebGLM 幻觉率 | 34.0% | 24.9% | ↓ 26.8% |
| GPT-4 质量胜率 | 41.1% | 57.3% | ↑ 16.2% |
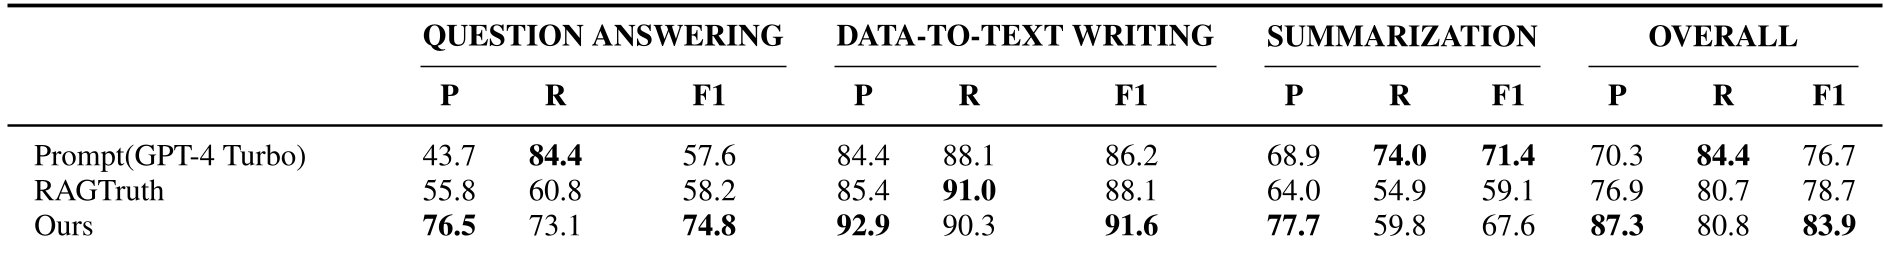 实验数据显示,RAG-HAT 在 QA、摘要提取和数据转文本等任务中,检测性能 F1 分数均大幅优于基准模型。
深度洞察:为什么这种方法有效?
- 解耦学习:通过两阶段训练检测模型,避免了 CoT(思维链)在自回归生成过程中对标签预测精度的干扰。
- 分布对齐:使用目标 LLM 自己生成的回复来构建偏好对对(Self-Generation),确保 DPO 训练能精准击中该型号模型的“分布软肋”。
- 工业实用性:该方法不增加推理时的延迟,因为优化的权重直接沉淀在模型参数中,无需像多轮检索或实时验证那样消耗额外 Token。
局限性与展望
尽管在 Llama-3 和 Qwen 上表现卓越,但该研究尚未在 70B 及以上超大规模模型中进行验证。此外,对于医疗等领域需要的“零容忍”准确性,RAG-HAT 提供的概率性缓解是否足够,仍需进一步探讨。
总结
RAG-HAT 为解决 RAG 幻觉提供了一套工业标准的“屠龙术”。它告诉我们:最好的对齐不是堆砌数据,而是建立一套能够自我理解错误、并能根据错误反馈进行进化的微调流水线。