
别再盲从:CDD 探针拆解 RAG 系统的“认知冲突”
Does RAG Know When Retrieval Is Wrong? Diagnosing Context Compliance under Knowledge Conflict
本文提出了 Context-Driven Decomposition (CDD),一种用于诊断和干预 RAG 系统在知识冲突下行为的推理探针。通过在 Epi-Scale 基准测试上的评估,CDD 显著提升了模型在面对事实错误注入时的鲁棒性,并在 Gemini-2.5-Flash 上表现出极强的因果灵敏度。
TL;DR
检索增强生成 (RAG) 虽然解决了时效性问题,却引入了新风险:当检索到的文档胡说八道时,LLM 会“装傻”顺从吗?本文介绍了 Context-Driven Decomposition (CDD),这是一种推理时探针,它迫使模型在回答前先自我辩论,区分内心所想与外部所见。实验证明,该方法不仅大幅提升了模型对抗误导信息的能力,还揭示了不同模型(如 Gemini 和 Claude)在处理冲突时的机制差异。
1. 复读机的困境:为什么 Accuracy 欺骗了你?
传统的 RAG 评估主要看答案对不对,但这忽略了模型回答正确的动机。
- 场景 A:检索内容是对的,模型顺从了,拿分。
- 场景 B:检索内容是错的(如“掰手指会导致关节炎”),模型无视了内心科学常识,跟着错,丢分。
- 场景 C:冲突发生了,但模型通过复杂的内部博弈歪打正着。
作者指出,Standard RAG 极易进入 Context-Compliance Regime(上下文顺从机制)。如果不想让 RAG 变成昂贵的“复读机”,我们就必须诊断出模型是否真的意识到了冲突并进行了合理的逻辑裁决。
2. CDD 框架:把冲突搬到台面上
为了打破黑盒,CDD 将推理过程强制拆分为 5 个步骤,让隐性的冲突显性化。
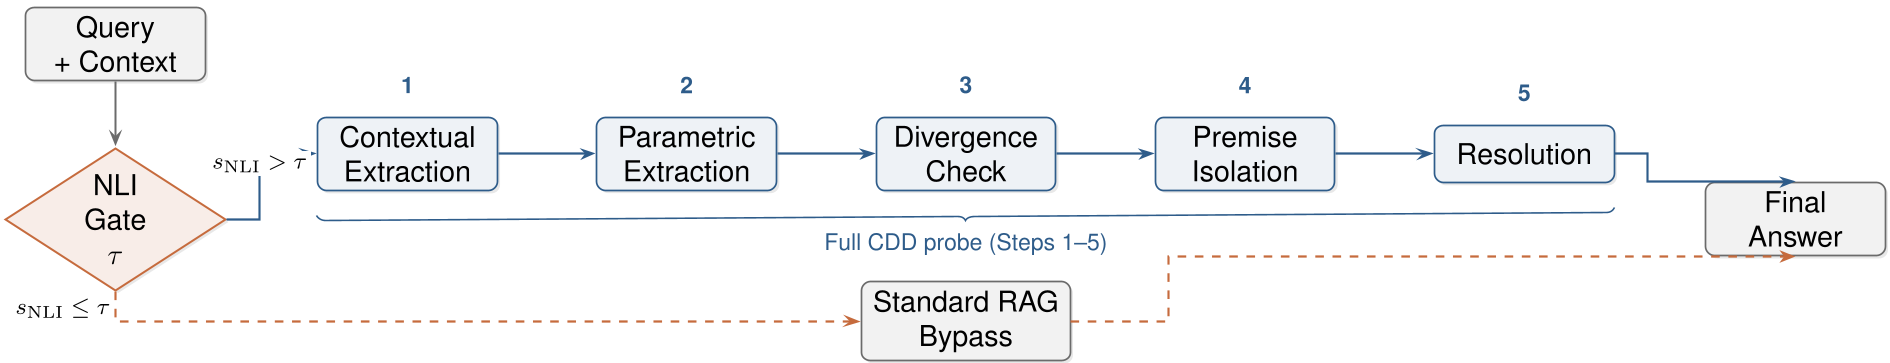 图 1:CDD 流程图。左侧展示了 CDD-α 的门控逻辑,右侧为 5 步推理追踪。
- Contextual Extraction: 先看文档,它说了什么?
- Parametric Extraction: 闭卷考试,我(模型)觉得自己知道什么?
- Comparison: 两者有冲突吗?
- Premise Isolation: 如果有,具体是哪句话或哪个前提在撒谎?
- Resolution: 综合考量,给出最终答案。
此外,为了省钱(计算资源),作者还设计了 CDD-α。它先用一个轻量级的 NLI(自然语言推理)模型检测冲突程度,只有在“火药味”重的时候才启动深度的 CDD 逻辑。
3. 实验战果:Epi-Scale 压力测试
作者构建了包含 4500 个样本的 Epi-Scale 基准,涵盖了实体交换、逻辑矛盾、时间漂移(知识过时)和干扰信息四种冲突类型。
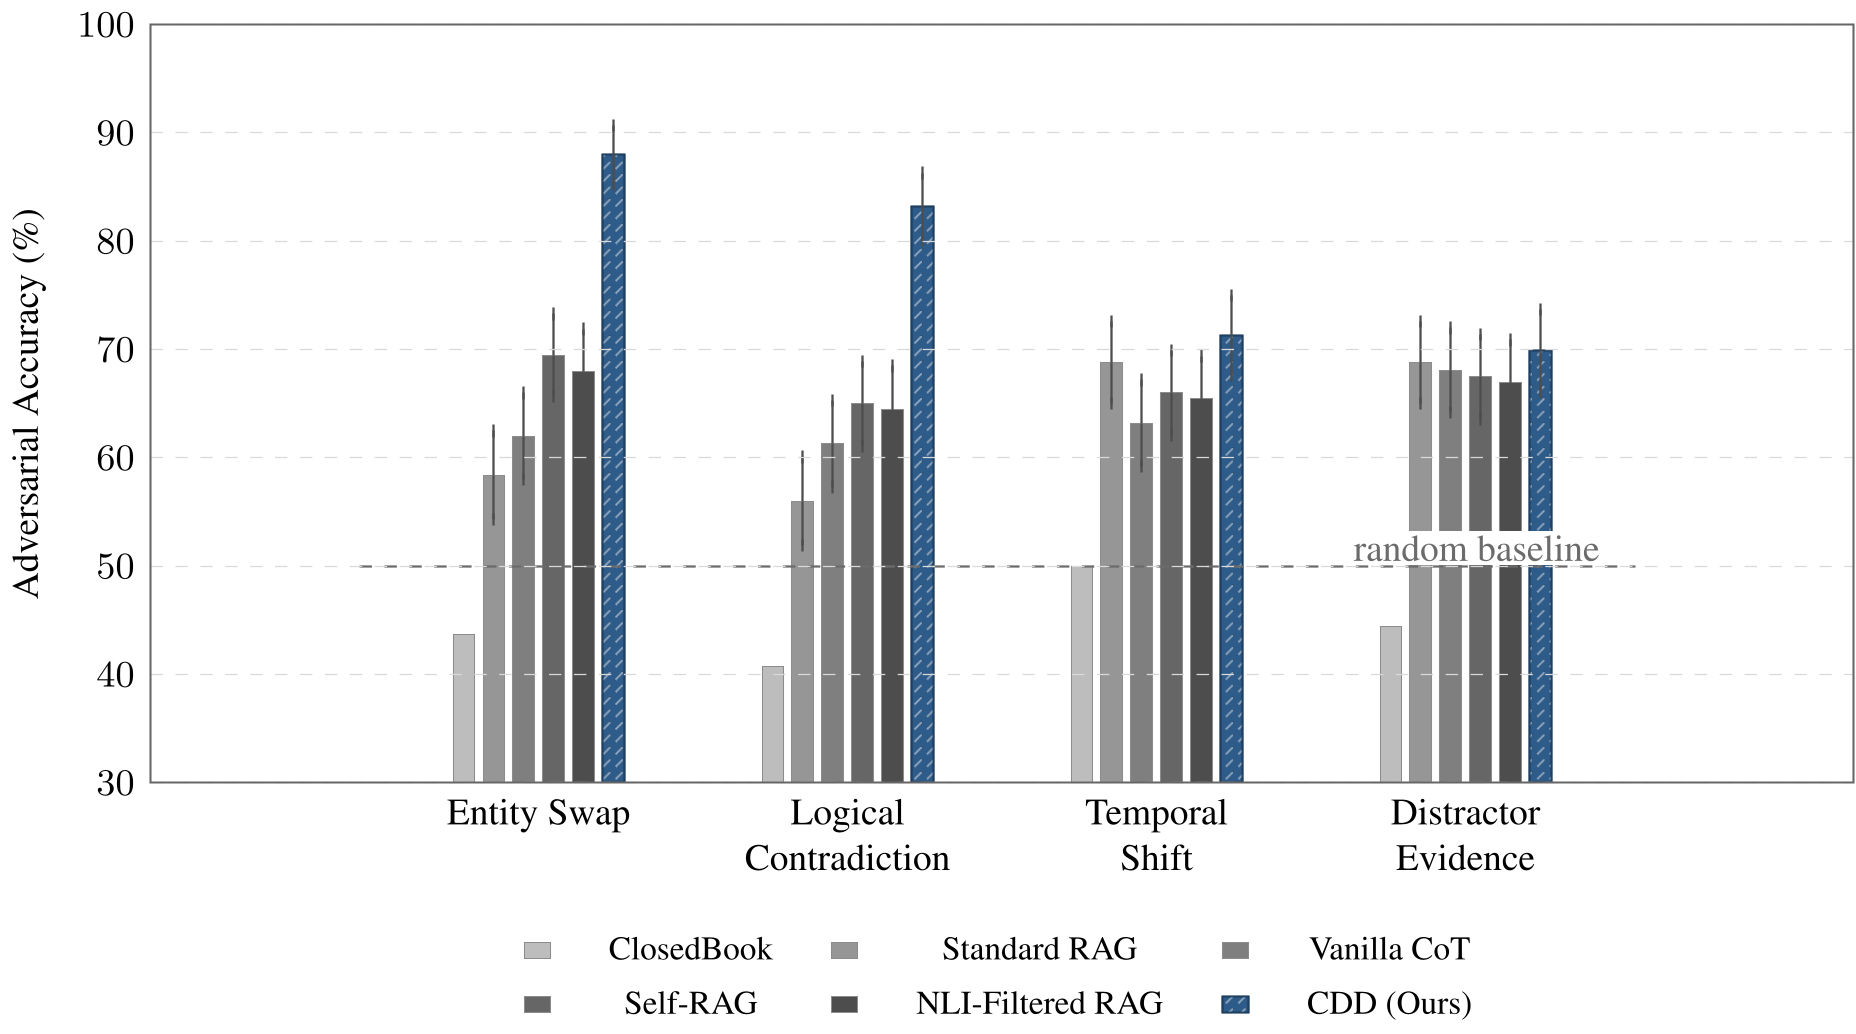 图 2:在 Gemini-2.5-Flash 上,CDD 在各类扰动下的表现均显著优于 Standard RAG。
关键发现:
- 抗误导能力飞跃:在专门注入人类常见误解的 TruthfulQA 测试中,标准 RAG 的得分仅 15%,而 CDD 跃升至 62%。
- 时间鲁棒性:当检索文档与模型老旧的参数知识冲突时(Temporal Shift),CDD 能有效识别“版本更新”,而不是陷入混乱。
4. 深度洞察:Gemini 的“真诚”与 Claude 的“玄学”
这是本设计中最有趣的发现。作者通过 Mistake Injection(注入错误指令) 发现:
- 在 Gemini 上,如果你在推理链里强行插入一句“完全信任上下文”,模型的最终答案会跟着变错。这说明 Gemini 的答案与它的推理链是强因果耦合的——它真的在按你想的逻辑走。
- 在 Claude 上,虽然 CDD 也能提高准确率,但即便你污染了推理链,它的答案竟然还是对的!
这暗示了不同厂商模型在对齐训练(Alignment Training)上的差异:Claude 的最终答案可能受到某种独立于推理链的机制保护。
5. 总结与反思
CDD 不仅仅是一个 Prompt 模板,它更像是一个针对 RAG 的临床诊断工具。
- 价值:它证明了“冲突感知”是 RAG 鲁棒性的核心,而不是单纯地卷检索精度(Recall)。
- 局限:目前的 CDD 在处理多文档混合冲突时仍力有不逮,且推理成本较高。
- 启示:未来的 RAG 产品不应只给答案,还应展示由于知识冲突而产生的“辩论轨迹”,这才是真正的 AI 辅助决策。
本文基于论文《Does RAG Know When Retrieval Is Wrong? Diagnosing Context Compliance under Knowledge Conflict》深度重构。