
RFT 真的能让 LLM Agent 举一反三吗?一项深度泛化性研究
Does Reinforcement Fine-Tuning Improve Generalization of LLM Agents? An Empirical Study
本文对大语言模型(LLM)智能体在强化学习微调(RFT)后的泛化性能进行了系统的经验研究。通过在 WebShop, SearchQA 等五个典型环境下实验,揭示了 RFT 在处理同环境不同难度任务时表现卓越,但在跨环境迁移时受语义先验和接口差异显著影响,并提出了课程学习和混合训练作为提升泛化能力的有效策略。
TL;DR
强化学习微调(Reinforcement Fine-Tuning, RFT)正成为 LLM 智能体进化的“催化剂”。本文通过大规模实验证明:RFT 能让智能体在同一环境下“变聪明”(学会走捷径、提高效率),但跨环境迁移时却容易“水土不服”。研究发现,“自易向难”的课程学习和顺序多环境训练是打造通用智能体的关键。
背景:被忽视的“环境漂移”
目前的 LLM 智能体研究大多在温室里进行:训练和测试都在同一个 WebShop 或同一个游戏里。但在真实世界中,一个在 A 网站学会购物的智能体,面对 B 网站不同的搜索接口和操作反馈,往往会瞬间失效。这种**跨环境泛化(Cross-environment Generalization)**正是 RFT 走向实用的最大门槛。
核心发现 1:同环境下的“轻车熟路”
研究发现,RFT 在同一环境下具有极强的鲁棒性。即使只在简单任务(Easy tasks)上训练,智能体在困难任务上的表现也会大幅提升。
- 效率进化:RFT 后的智能体不再“废话”,其生成的 Token 数量和交互轮数显著下降。
- 直觉解释:智能体学会了环境的固有逻辑(如 WebShop 的搜索-点击模式),这种逻辑是跨任务通用的。
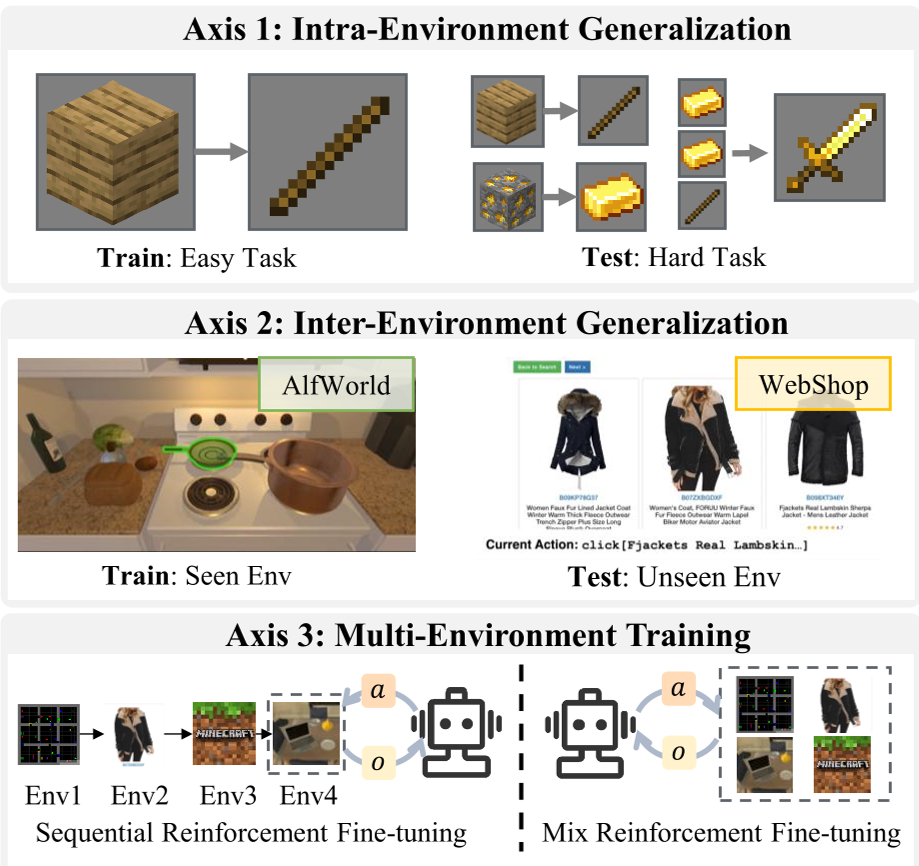 图 1:研究涵盖的三个维度:任务难度、跨环境迁移、顺序训练
核心发现 2:跨环境的“水土不服”
当把 WebShop 训练好的模型直接扔到 SearchQA 或物理模拟环境 BabyAI 时,情况变得复杂:
- 语义近似则迁移强:SearchQA 训练的模型在 WebShop 上依然能打,因为两者都依赖“搜索-提取”的逻辑。
- 接口依赖则迁移弱:在 BabyAI 中过度依赖“可用动作列表”的智能体,换到没有提示的环境后,逻辑推理能力会大幅退化。
- 负迁移现象:在某些情况下,RFT 甚至会让模型变笨。
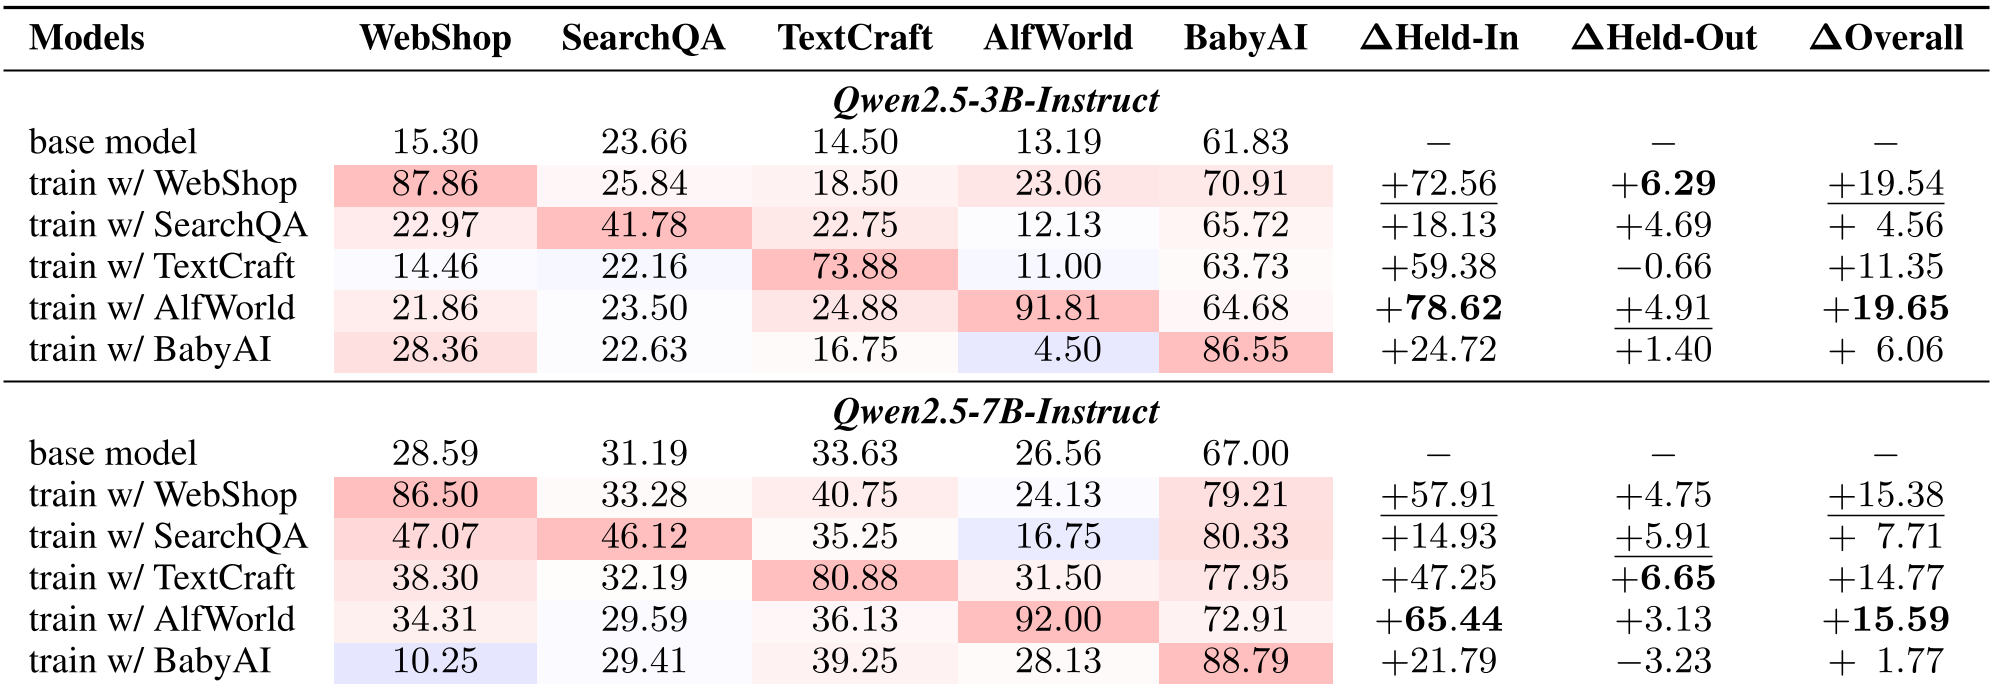 表 1:跨环境实验结果,注意 Held-In 与 Held-Out 之间的巨大差异
核心发现 3:顺序训练是“良方”
令人意外的是,RFT 在多环境顺序训练中表现出了极佳的抗遗忘性。
- 先难后易还是先易后难? 实验证明,“自易向难”的课程学习效果最佳。
- 顺序 vs 混合:顺序学习多个环境后的最终效果,竟然可以媲美将所有环境混合在一起进行的 Joint Training。这意味着我们可以像教学生一样,一个阶段一个阶段地培养智能体的能力。
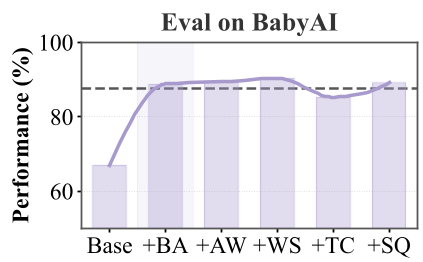 图 2:五阶段顺序训练的性能变化,展示了惊人的能力保留
深度洞察:为什么会失败?
通过对失败案例(Failure Mode)的解剖,作者发现了几个关键痛点:
- 确认偏差(Confirmation Bias):RFT 后的模型往往过于自信,即使环境反馈显示出错了,它也会执拗地认为自己是对的。
- 逻辑缺陷 vs 接口依赖:许多失败并非因为智能体不懂逻辑,而是因为它对特定的操作反馈形成了“路径依赖”。
总结与未来
这项研究为我们敲响了警钟:单纯在单环境上刷榜 SOTA 并没有意义。一个真正的 LLM 智能体应当通过多样化环境的混合训练来打破语义和接口的束缚。未来的研究需要更多关注如何让智能体在面对未知环境时,具备更强的“自省”和“自我修正”能力。
关键词:LLM Agent, RFT, Generalization, Curriculum Learning, GRPO