
强化学习真的教给 LLM 新知识了吗?揭秘 RLVR 训练下的推理陷阱
Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?
本文批判性地评估了基于可验证奖励的强化学习(RLVR)在提升大语言模型(LLM)推理能力方面的真实作用。通过 pass@k 指标,研究发现当前的 RL 研究(如 DeepSeek-R1 相关技术)更多是提升了采样效率,而非拓展了 base model 的推理边界。
TL;DR
清华大学的一项最新研究给当前火热的 "o1/R1 类强化学习" 泼了一盆冷水。研究指出:目前的 Reinforcement Learning with Verifiable Rewards (RLVR) 并没有让大模型产生“顿悟”,它只是把 base model 原本就有的推理路径挑出来,提高了个别路径的出现频率。简单来说,RL 优化了抽奖效率,但缩小了奖池范围。
背景定位:身处“R1 式”狂热中的冷思考
自从 DeepSeek-R1 和 OpenAI o1 证明了 RL 在数学和编程上的奇效,学术界普遍认为 LLM 进入了“自我进化”时代。但本文通过严谨的实验证明:在当前的算法框架下,RL 模型推理能力的上限完全由 base model 决定。
痛点深挖:被 pass@1 掩盖的真相
传统测试习惯看平均分(pass@1),这让大家觉得 RL 简直是神药。但作者提出了一个尖锐的视角:如果让模型多猜几次(加大 k 值),base model 能做出来的题,RL 后的模型反而做不出来了。
这意味着:RL 训练像是一种“思想钢印”,它强化了一组特定的正确答案,随之代价是抹杀了模型在这个问题之外的其他可能性。
核心方法演练:pass@k 作为“真实上限”的探测器
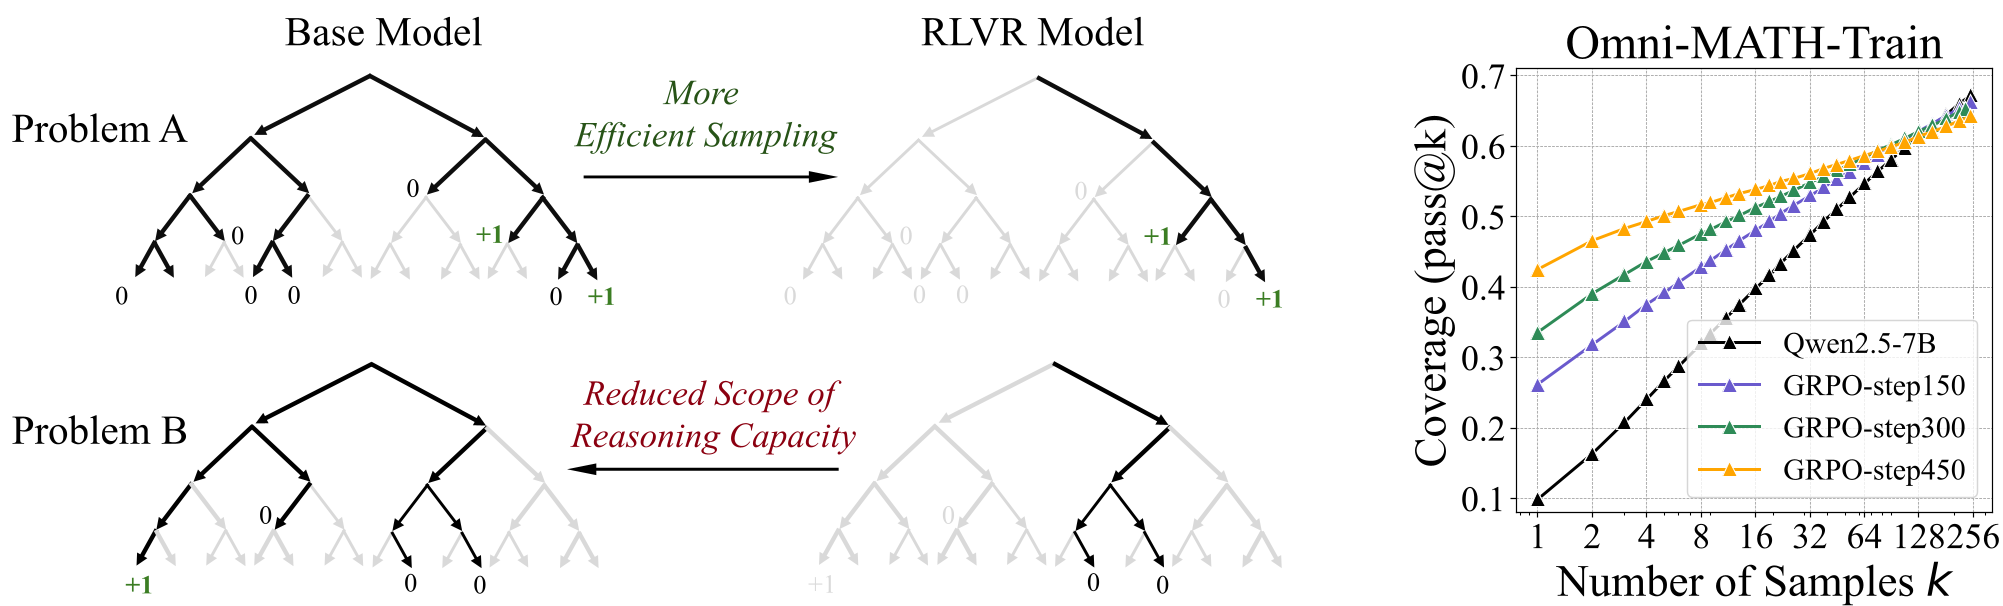
左图深刻展示了论文的核心结论:
- 问题 A:Base model 概率低,RL 把它提上来了(采样效率提升)。
- 问题 B:Base model 概率低但有解,RL 训练后,这个解彻底消失了(边界缩小)。
作者还利用 Perplexity (困惑度) 分析 证明了:RL 模型产生的推理步骤,其分布完全落在 base model 的原本分布之内。换句话说,模型并没有发明任何新的思考逻辑(如自我反思、步步重检),这些能力原本就沉睡在 base model 庞大的预训练参数里。
实验战绩:Base Model 的“逆袭”
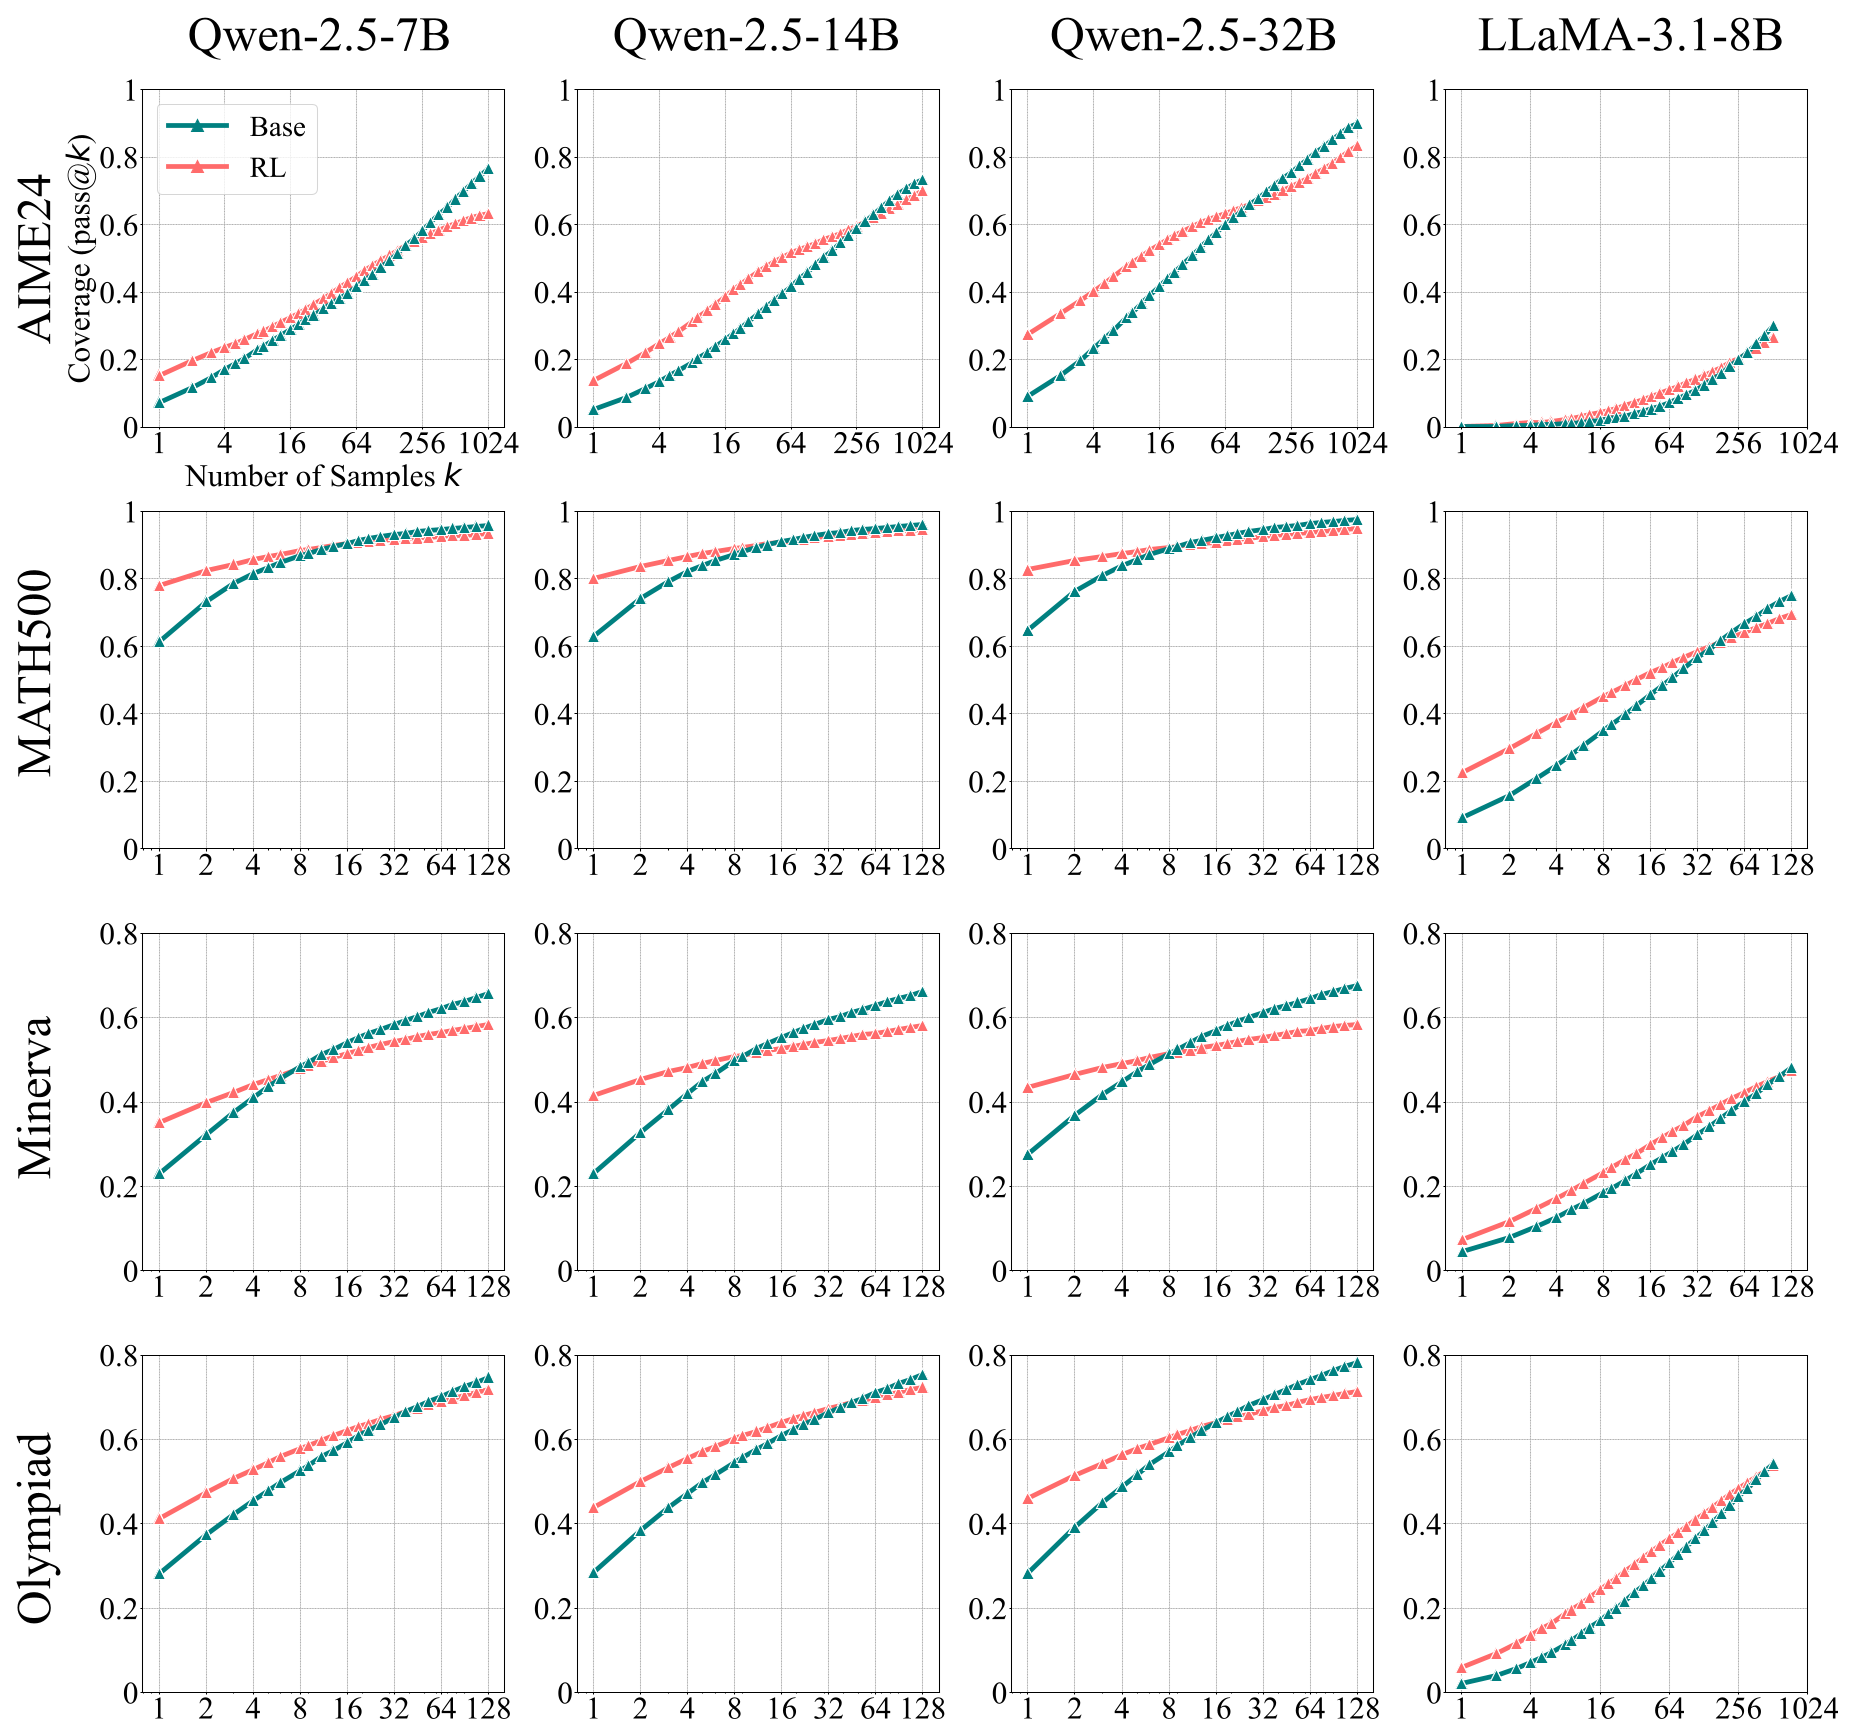
在数学(GSM8K, MATH)、代码(HumanEval)和视觉推理(MathVista)的多重测试中,曲线呈现了惊人的一致性:
- 在 k < 10 时,RLVR 模型遥遥领先。
- 随着 k 增大,Base model 的曲线斜率更高,最终反超。
- 结论:Base model 拥有更广的“解空间”,只是平时不爱说正确答案。
深度洞察:为什么 RL 没能超越原主?
论文指出两个关键差异:
- 巨大的动作空间:语言的组合是指数级的,目前的 RL 很难在没见过的情况下“盲猜”出复杂的推理路径。
- 预训练先验的诅咒:为了保证生成不乱码,RL 必须依赖 Base model 的先验知识。这成了一个“回音壁”,让模型只在已知领域内打转。
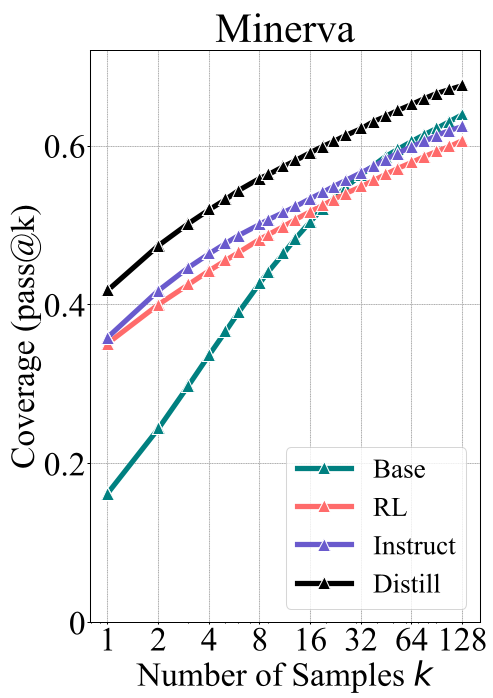
相对而言,模型蒸馏(Distillation) 表现出了不同的特性。如下图所示,蒸馏模型(如 R1-Distill)能显著提升 pass@k 曲线的全段,因为它真正从强大的 Teacher 模型那里吸取了新的推理模式。
总结与启示
目前的 RLVR 训练更像是一种“对齐(Alignment)”而非“学习(Learning)”。
未来的路在哪?
- 高效探索策略:不再满足于 Token 级别的采样。
- 细粒度过程奖励 (PRM):不仅告诉模型“结果对不对”,更要告诉它“哪一步想得妙”。
- 多轮 Agent 交互:让模型在与环境的真实反馈中获得 Base model 之外的“经验”。
这篇文章提醒我们:不要低估 Base model 的潜力,也不要高估现有 RL 算法的“智力发现”能力。