
重新思考 WS-VTG:基于博弈论视角的细粒度视频时刻定位
Rethinking Weakly-Supervised Video Temporal Grounding From a Game Perspective
本文提出了一种基于博弈论视角的新型弱监督视频时刻定位(WS-VTG)框架。该方法抛弃了传统的候选框(Moment Proposal)预测范式,通过将视频帧和查询词建模为协作博弈中的参与者,利用交互指数(Banzhaf/Shapley Interaction Index)学习细粒度的跨模态对齐,在 Charades-STA 和 ActivityNet Caption 数据集上均取得了 SOTA 性能。
TL;DR
在弱监督视频时刻定位(WS-VTG)领域,传统的“生成候选框并打分”的方法(Proposal-based)正面临瓶颈。本文提出了一种全新的博弈论视角,将视频帧与查询词视为博弈中的“玩家”。通过计算博弈交互指数,模型能够量化每一帧对最终对齐得分的贡献,并在不使用任何候选框的情况下,实现了更精准、更高效的边界定位。
背景定位:为何 Proposal 限制了想象力?
视频时刻定位任务要求根据一段文字(Query)从长视频中截取对应的片段。在弱监督场景下(只知道视频和文字匹配,不知道具体起止点),现有方法通常采用滑动窗口生成候选框,然后进行对比学习。
这种模式存在两个本质缺陷:
- 对齐太“粗”:它只看一整个片段和一整句话是否匹配,忽略了“哪个词对应哪一帧”的底层逻辑。
- 效率太“低”:候选框的设计与评估既死板又耗费计算资源,且难以跨数据集迁移。
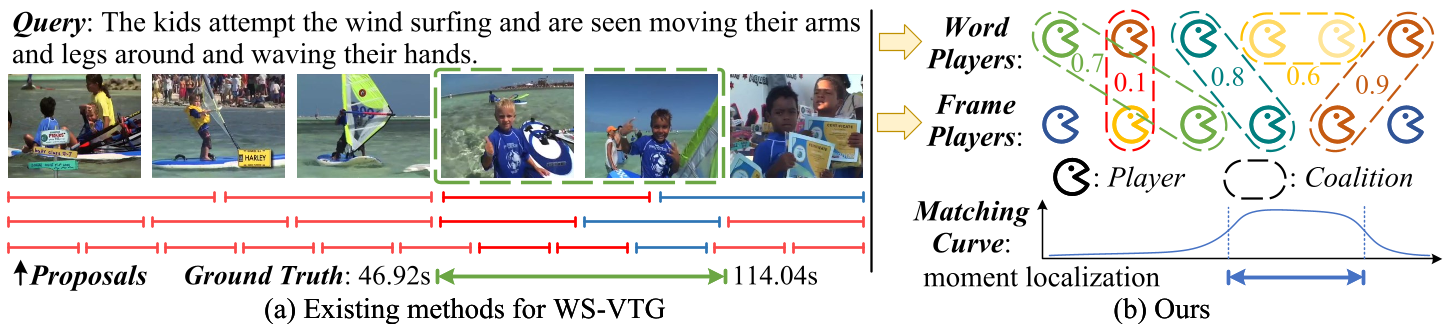
核心直觉:帧与词的协作博弈
作者提出:如果某一帧和某个词具有强语义相关性,它们就会倾向于“结盟”(Coalition),并在博弈中共同产生更高的收益(即对齐分数)。
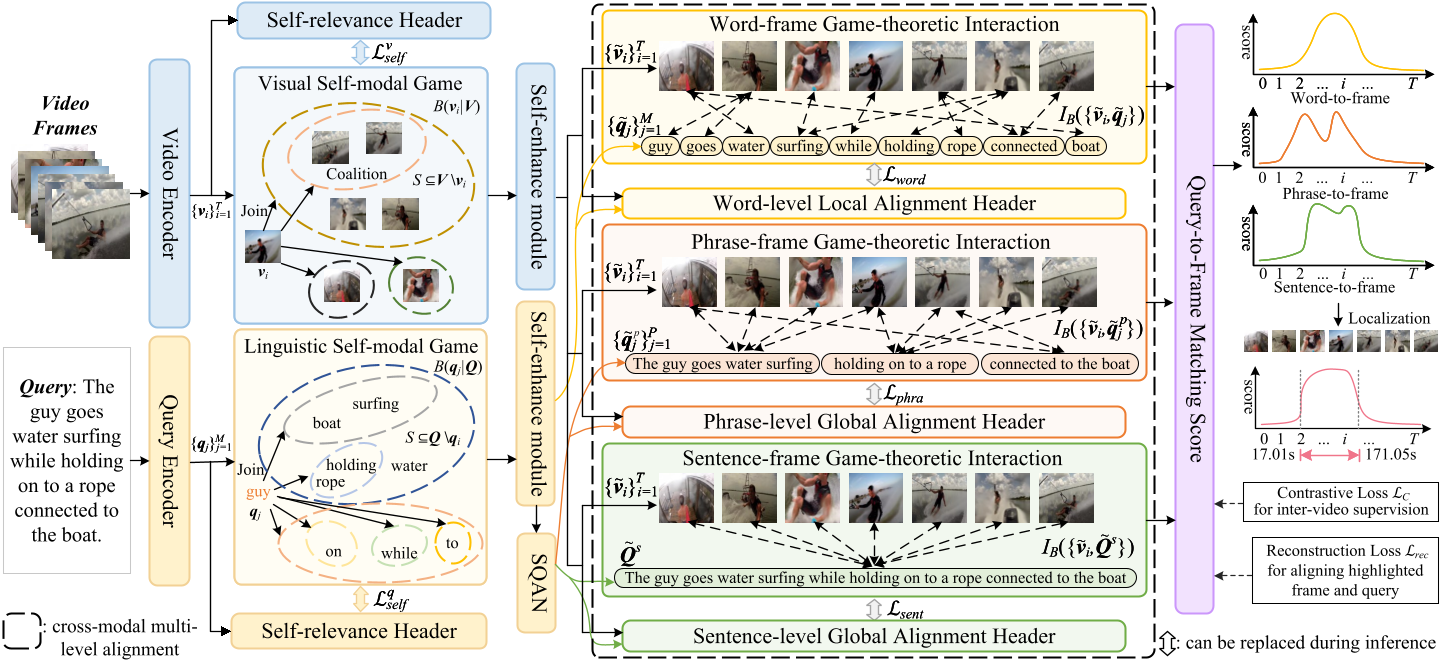
1. 自模态增强 (Self-modal Enhancement)
在进行跨模态匹配前,模型先进行“内部会议”。通过 Banzhaf Value 计算每个帧(或词)对整个视频(或句子)语义的边际贡献。这种方法能自动捕捉到时间序列中的上下文权重,增强特征的表达能力。
2. 多级跨模态对齐 (Multi-level Interaction)
这是本文的核心。作者定义了跨模态交互指数 ,用于衡量帧 和词 结盟后带来的“额外收益”。
- 词级、短语级、句子级:博弈不仅发生在词与帧之间,还扩展到了短语和整句。
- 软监督机制:由于直接计算博弈指数属于 NP-Hard 问题,作者设计了可学习的 Header 并使用 KL 散度进行软监督,使模型在推理时无需进行耗时的博弈采样。
实验结果:全方位的领先
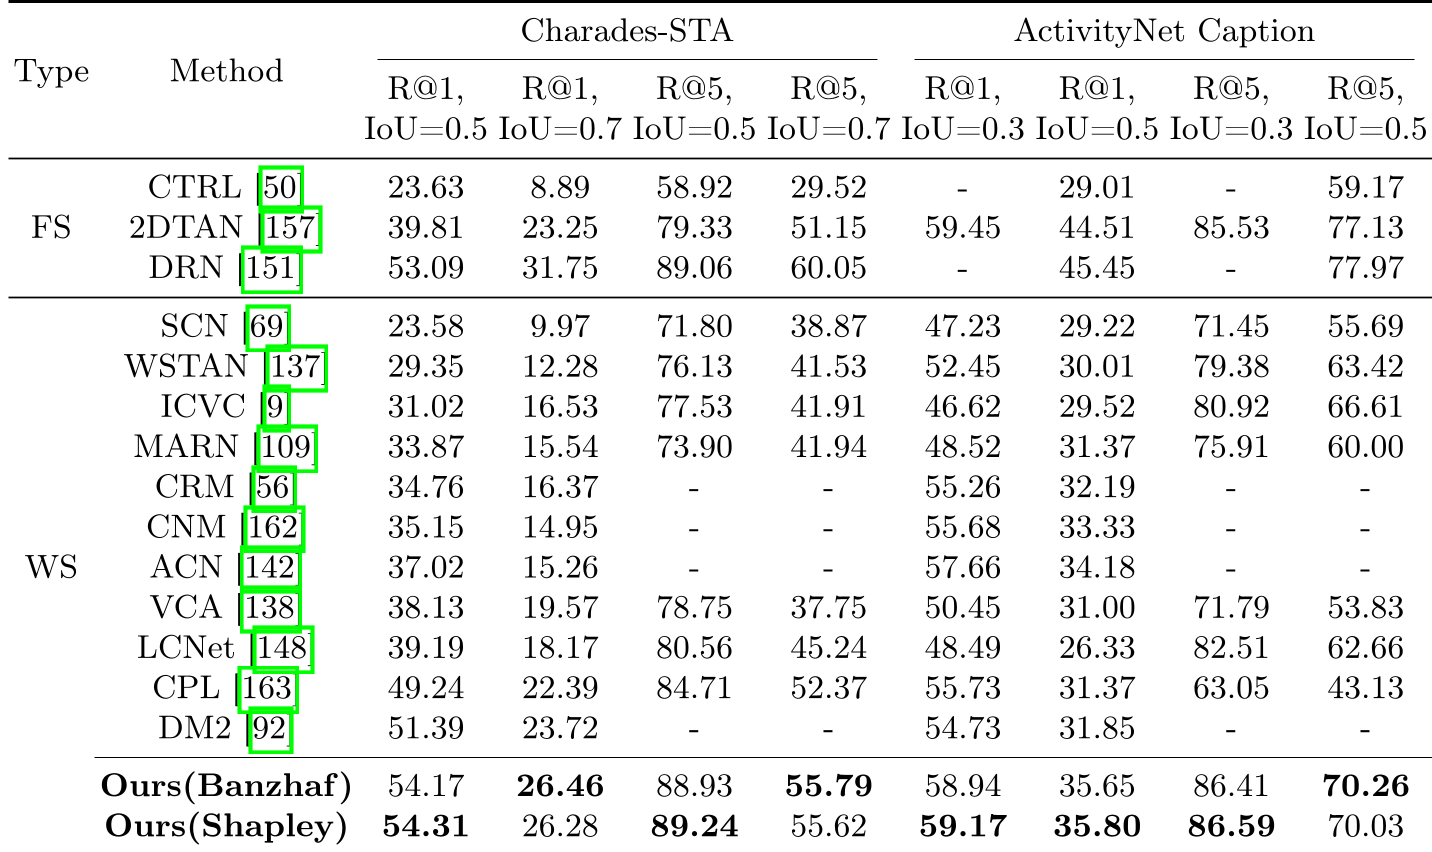
实验在 Charades-STA 和 ActivityNet Caption 两个主流数据集上展开。
- 性能起飞:在关键指标 R@5 (IoU=0.5) 下,相比于之前的 SOTA 方法 CPL,性能提升了约 4.5%。
- 泛化性极强:在跨数据集测试(A C,C A)中,由于摒弃了数据集敏感的预设候选框,该方法显著优于 LCNet 等传统方法。
深度洞察:博弈论带来了什么?
- 可解释性:博弈价值直观地展示了模型为什么判定某一帧是关键帧——因为它在结盟中贡献了更高的交互分数。
- 不确定性建模:弱监督环境下的跨模态对应关系是模糊的。博弈论通过考虑所有可能的联盟(Coalition)组合,优雅地处理了这种不确定性。
- 推理效率:虽然训练过程涉及复杂的采样计算,但推理阶段仅利用预测好的 Header 即可,其在推理速度和 GPU 显存占用上甚至优于部分常规方法。
总结与局限
本文通过引入协作博弈论,为弱监督视频理解提供了一个高维度的视角。局限性在于:对于极长视频,玩家集合(Player Set)规模激增,采样效率可能成为训练瓶颈。未来的研究方向可以探索如何更高效地近似这种博弈空间,或将其扩展至包含音频的多模态博弈。