
SANA-WM:打破长视频瓶颈,单 GPU 驱动的一分钟 720p 世界模型
SANA-WM: Efficient Minute-Scale World Modeling with Hybrid Linear Diffusion Transformer
NVIDIA 团队提出了 SANA-WM,一个拥有 2.6B 参数的开源 6-DoF 相位可控世界模型。该模型原生支持一分钟长度、720p 分辨率的高保真视频生成,在保持与顶级工业模型(如 LingBot-World)相当的视觉质量的同时,显著提升了推理与训练效率。
TL;DR
NVIDIA 推出的 SANA-WM 是世界模型领域的一个重要里程碑。它不仅实现了高质量的 720p/一分钟 视频生成,更重要的是它极其高效:仅需 2.6B 参数,支持在单张消费级绘图卡(如 RTX 5090)上实时推理。通过混合线性注意力机制与精确的 6-DoF 相位控制,SANA-WM 为具身智能和物理模拟提供了一个触手可及的开源基础模型。
痛点深挖:为什么一分钟世界模型这么难?
在 SANA-WM 之前,开源界的世界模型往往面临三座大山:
- 计算鸿沟:标准的 Transformer 依赖 Softmax Attention,其计算量随视频长度呈平方级增长。生成一分钟(约 960 帧)的 720p 视频,显存占用会瞬间击穿 H100 的极限。
- 动作坍塌:随着生成时间增长,模型往往会“忘记”物体的初始位置或发生剧烈的几何畸变(Drift),导致动作控制(如转弯、倒车)变得模糊。
- 数据稀缺:虽然互联网视频很多,但带有精确度量级相机位姿的长视频极少,这让原生训练一个可控模型变得异常困难。
核心架构:Hybrid Linear Attention 的物理直觉
SANA-WM 的核心创新在于其混合骨干网(Backbone)。作者意识到:视频的帧间演变本质上是一种带有“遗忘”和“更新”的递归过程。
- Gated DeltaNet (GDN):模型的大部分层采用 GDN,这是一种线性注意力变体。它类似于 RNN,拥有一个常数大小的 状态矩阵。每处理一帧,它会利用“增量规则(Delta Rule)”更新状态,确保信息能以极低功耗流动。
- 周期性 Softmax:每 4 层 GDN 插入一层标准的 Softmax Attention。这一设计的精妙之处在于:GDN 负责高效的帧间演化,而 Softmax 负责“锚定”长程记忆,防止场景随时间推移而崩坏。
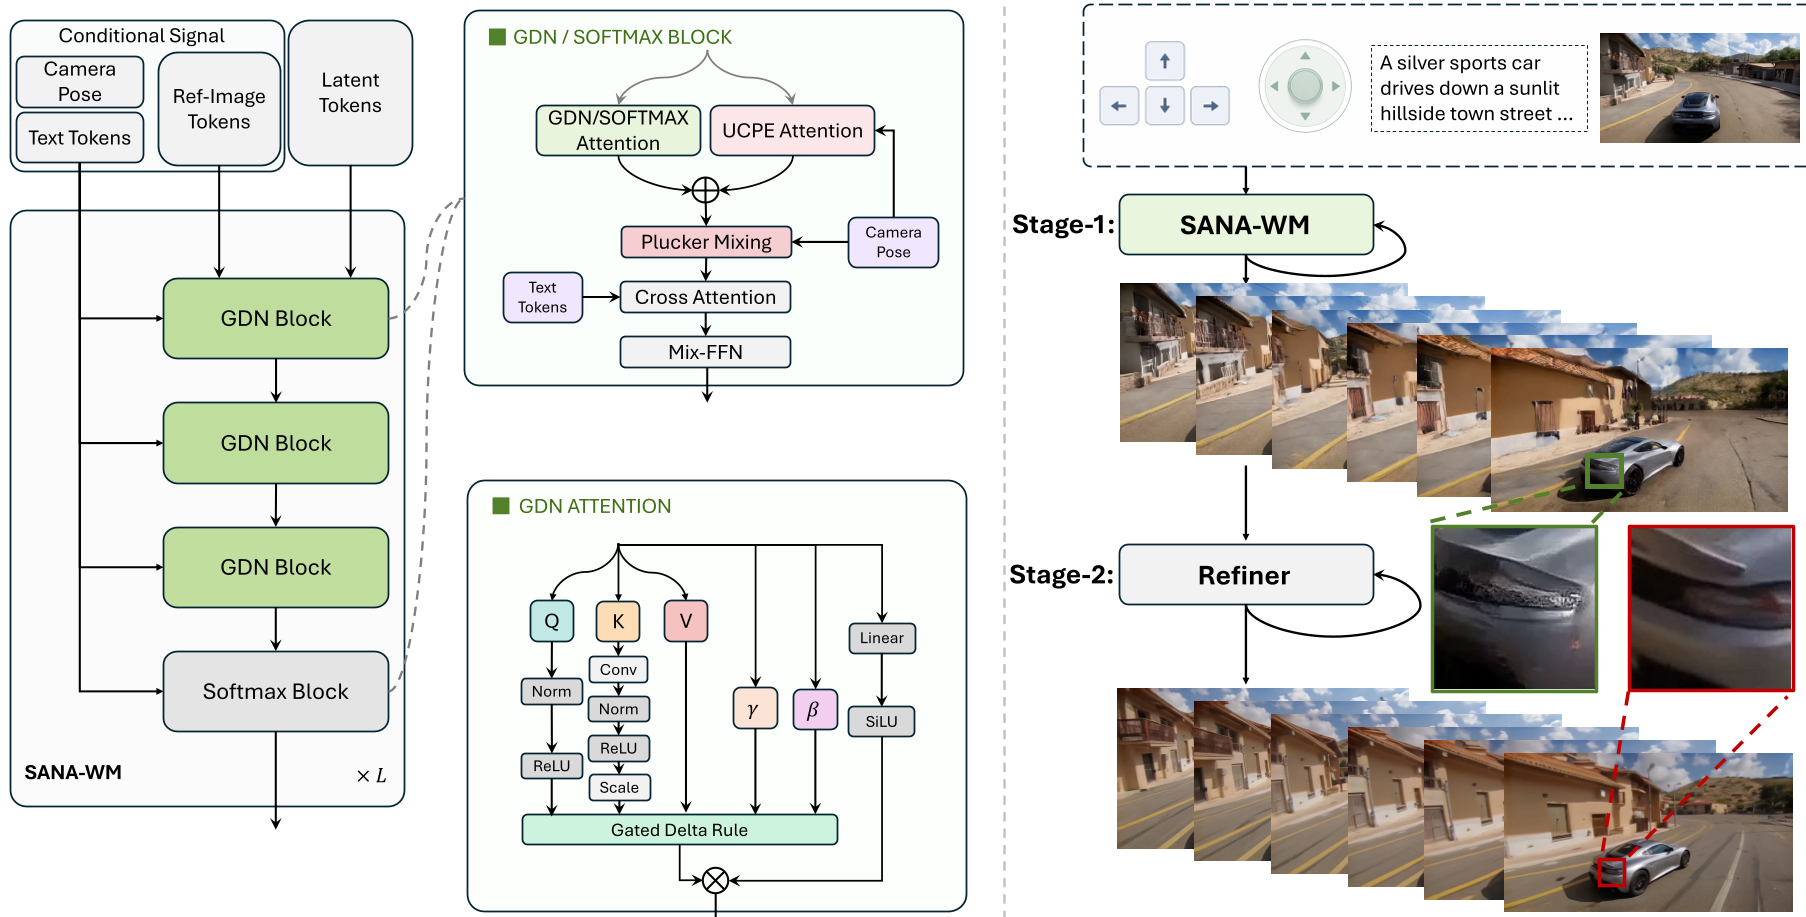 图 1:SANA-WM 架构,展示了 GDN 与 Softmax 块的交替使用以及双分支相机控制模块。
相机控制:从粗到细的“双轨制”
为了让生成的视频严格遵循 6-DoF(六自由度)轨迹,SANA-WM 引入了双分支相机控制:
- UCPE 分支(Coarse):在 Latent 层级捕捉相机的全局轨迹。它类似于给每一帧的位置编码打上几何标签。
- Plücker Mixing 分支(Fine):在 VAE 的时间跨度内补偿微小的相机偏移。这种“粗细结合”的方式,使得模型即使在大幅度移动(如 Hard-Trajectory 压力测试)时,也能保持惊人的几何一致性。
性能对决:36 倍的效率跃迁
SANA-WM 的实验结果非常亮眼。在与 LingBot-World、Matrix-Game 3.0 等知名模型的对比中:
- 精度:在 Simple 和 Hard 轨迹测试中,其旋转误差(RotErr)和位移误差(TransErr)均显著低于基线。
- 效率:当其他模型需要 8 张 H100 进行并行推理时,SANA-WM 仅需 1 张 即可完成 1 分钟生成,且吞吐量大幅领先。
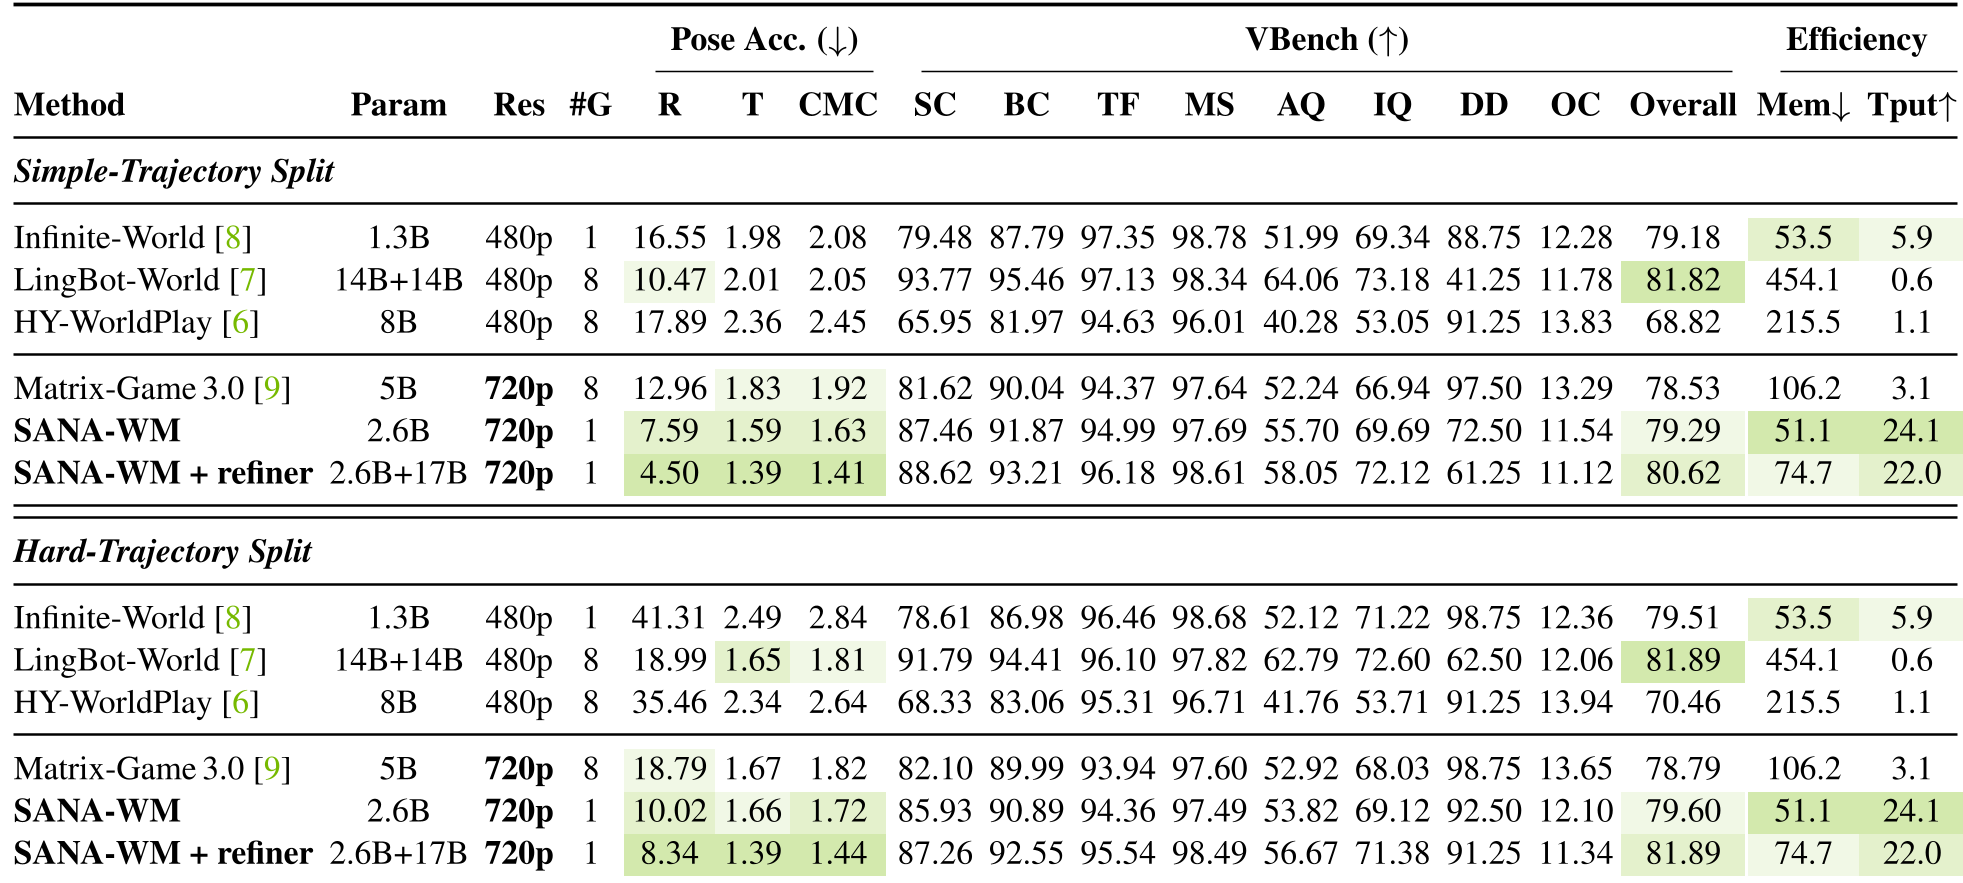 表 1:SANA-WM 在位姿精度和 VBench 视觉评分上位居前列,且推理资源需求极低。
二阶段精炼:让模糊彻底消失
为了进一步压榨画质,SANA-WM 包含一个二阶段精炼器(Refiner)。它采用“阶段性 Flow Matching”,在一阶段生成的低保真 Latent 基础上,通过 LoRA 适配的长视频精炼器修正结构性伪影,确保一分钟后的画面依然锐利、一致。
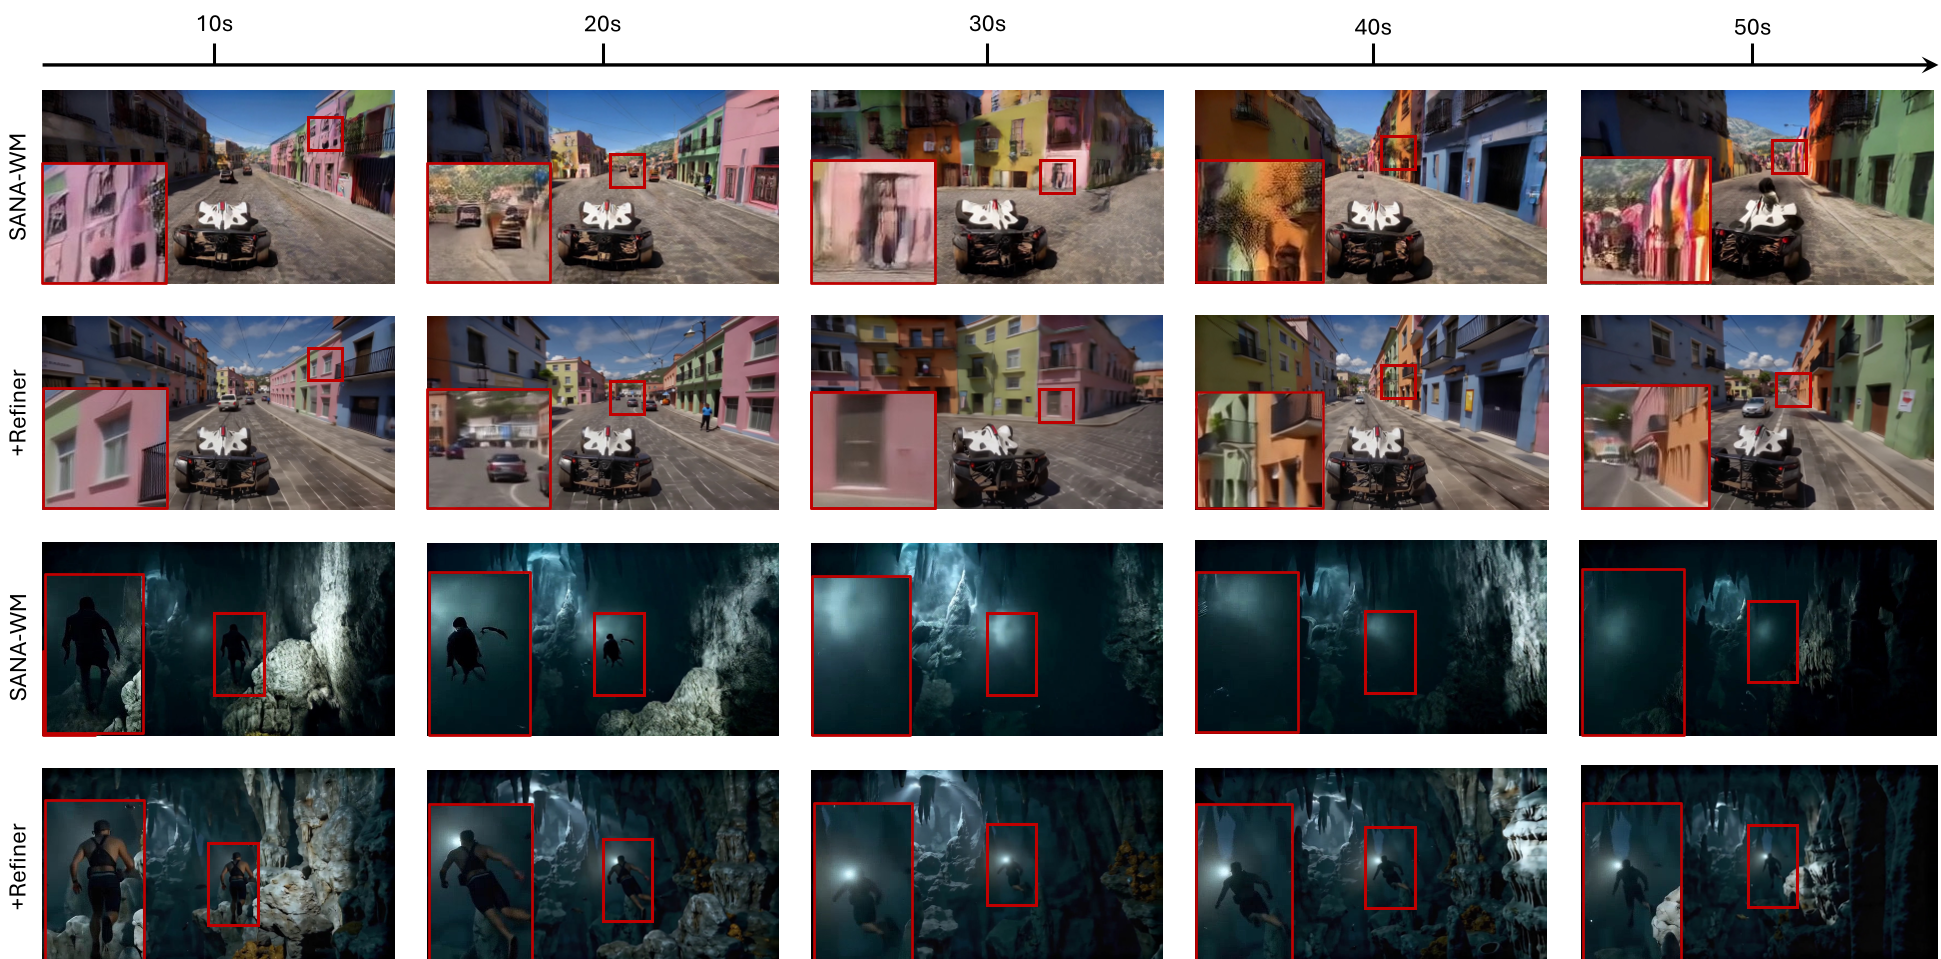 图 2:Refiner 对长程视频细节的显著提升(如红框所示的物体结构保持)。
总结与洞察
SANA-WM 的真正价值不在于它“大”,而在于它“精”。它向学术界展示了:高效架构(线性注意力)+ 鲁棒标注管线(Pi3X/MoGe-2)+ 两阶段流水线 能够跑赢堆算力的工业大模型。
局限性:尽管目前在 60 秒内表现优异,但在极长程(如 5 分钟以上)或剧烈动态场景下,模型仍可能存在累计误差引起的漂移。
展望:随着单卡 1 分钟生成的实现,未来的具身智能研究可以大规模地在虚拟世界中进行策略演练,这对于自动驾驶、家居机器人等领域将是巨大的推动。