
揭秘重排序器的缩放密码:Cross-Encoder Reranking 也有 Scaling Laws 了!
Scaling Laws for Cross-Encoder Reranking
本文提出了针对 Cross-Encoder 重排序(Reranking)模型的第一套 Scaling Laws,系统研究了模型规模、训练数据量与重排序质量(NDCG@10)之间的幂律关系。通过在 17M 到 1B 参数规模上的实验,证明了利用 150M 以下的小规模模型可以精准预测 1B 规模大模型的性能。
TL;DR
在神经网络搜索架构中,重排序(Reranking)是提升精度的“最后一步”。然而,我们是否能像预训练 LLM 那样,通过小规模实验精准预测 1B 参数重排序器的表现?UMass Amherst 的这项研究给出了肯定答案:重排序性能严格遵循幂律缩放。研究发现,Pairwise(成对)训练目标在规模化后表现最强,且在算力分配上,重排序任务往往展现出**“数据饥渴型”**特征。
背景定位:检索流水线的最后一道防线
现代搜索引擎通常采用“初级检索+精细重排序”的多阶段流水线。过去几年,Scaling Laws 在 LLM 预训练和密集向量检索(Dense Retrieval)领域大放异彩,但在重排序领域却迟迟没有系统性的论证。这主要是因为重排序器处理的是由初级检索器送来的“候选子集”,其数据分布和评价指标(NDCG)具有极强的非连续性。
痛点深挖:为什么之前的预测失灵了?
以往的研究往往依赖**对比熵(Contrastive Entropy, CE)**作为代理指标,但本文研究发现:
- CE 与排序指标(NDCG)并非完全同步:在模型增大过程中,CE 的波动往往较大,甚至在 Pairwise 训练下出现性能恶化,而同期的 NDCG 指标却依然稳步提升。
- 不同损失函数的缩放效率不同:Pointwise、Pairwise 和 Listwise 模型在面对更多数据和更大容量时,收益速度完全不同,导致开发者无法照搬预训练模型的算力分配权重。
方法论:捕捉重排序的频率
作者使用了 Ettin 系列 Cross-Encoder 模型(17M 至 1B 参数),在 MSMARCO 100K 过滤后的查询集上进行微调。核心公式采用了经典的饱和幂律形式:
这里 代表模型大小, 代表训练步数。通过在小型模型(最高 150M)上拟合参数,作者试图推算出 400M 和 1B 参数模型的最终 NDCG 表现。
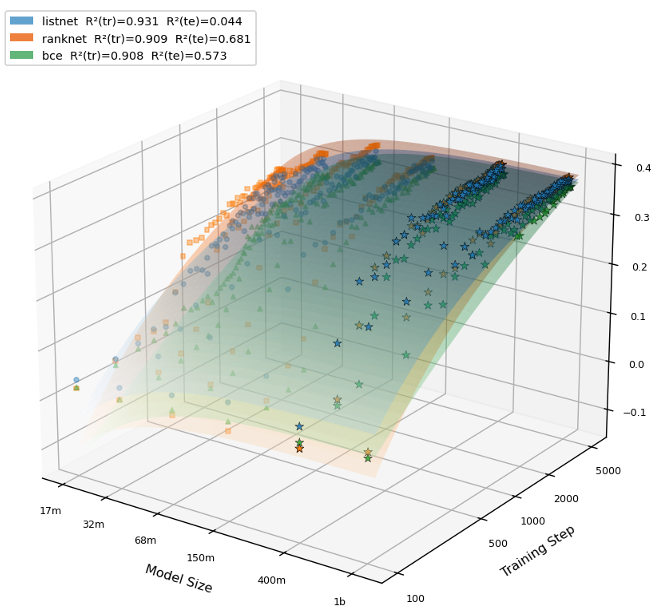 图 1:NDCG@10 随模型规模(Model Scaling)和数据暴露量(Data Scaling)的变化曲线,可见拟合出的幂律曲线与实验点高度一致。
实验战果: Pairwise 的统治力
实验表明,Pairwise 目标是规模化后的“性能之王”:
- 在 1B 规模下,Pairwise 的 NDCG@10 达到 0.378,比 Listwise 高出约 2 个百分点,比 Pointwise 高出 4-5 个百分点。
- 预测精度:拟合 150M 以下模型得到的预测曲线,预测 1B 模型时的误差 RMSE 仅为 0.012 左右,具有极高的工程参考价值。
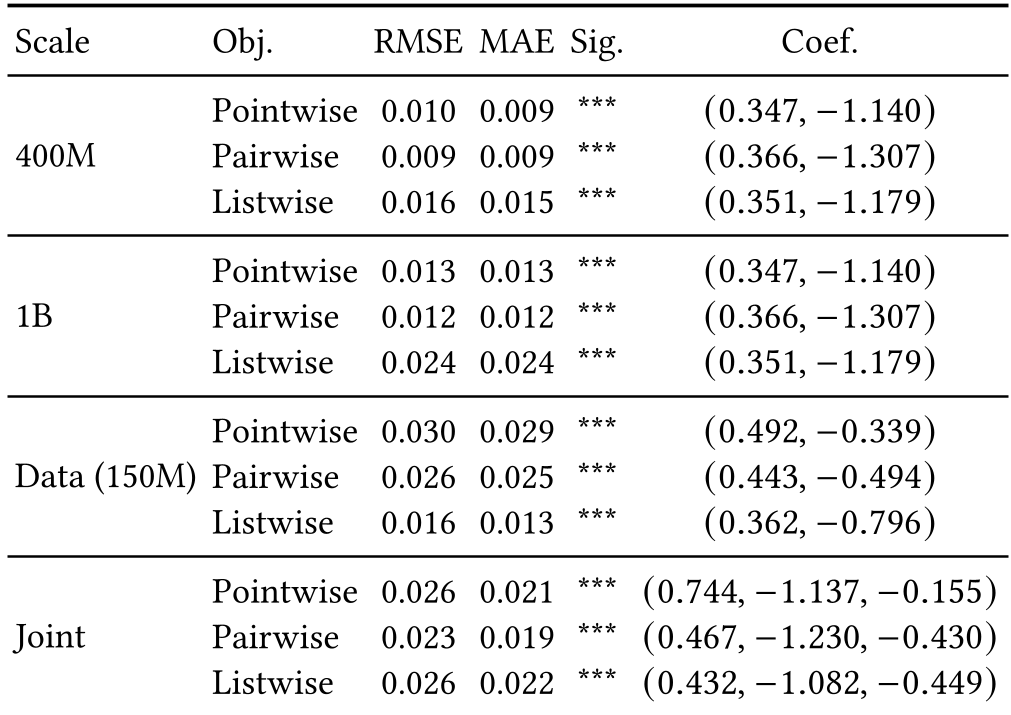 表 1:各尺度下拟合误差统计,可见在大部分情况下,Scaling Law 的预测(Pred.)都能完美覆盖实验观察到的区间(Obs.)。
深度洞察:算力该怎么分?
这是本文最具实战意义的发现。通过对联合缩放公式求偏导,作者导出了最优分配比例 :
- Pointwise 目标:最为“数据贪婪”(),这意味着你应该把 88% 的新增算力分配给数据量,而非模型大小。
- Pairwise/Listwise 目标:相对平衡,但依然偏向于增加数据量( 约在 0.25-0.37 之间)。
- 一个反直觉的结论:如果你用的是 Pairwise 目标,在固定算力预算下,用更多的训练步数训练较小的模型(如 68M),其效果往往优于训练数据量不足的 400M 大模型。
总结与展望
这项工作填补了搜索架构中重排序 Scaling Law 的空白。它告诉我们,重排序器的性能不仅是可预测的,而且存在明确的“性价比”最优解。
局限性:
- 仅研究了单编码器(Encoder-only)架构,对于基于 Decoder 或 T5 架构的生成式重排序是否适用尚待验证。
- 实验主要基于 MSMARCO 语料,跨域(Zero-shot)性能的缩放规律仍是未来的研究课题。
总的来说,这篇论文为工业界构建超大规模重排序模型指明了道路:先用小模型摸透曲线,再砸算力加数据,千万别盲目做大模型。