
深度学习力学:告别炼金术,迎接人工智能的“牛顿时代”
There Will Be a Scientific Theory of Deep Learning
本文提出了“学习力学”(Learning Mechanics)这一新学科范式,旨在构建深度学习的科学理论。通过整合解析实例、极限分析、经验定律、超参数解耦和通用行为五大研究支柱,该理论力求从第一性原理精准预测神经网络的训练动力学、表示演化及泛化性能。
TL;DR
伯克利等机构的研究者正式提议创立一个名为 学习力学 (Learning Mechanics) 的新学科。他们认为,深度学习不应再是无法解释的黑盒,而应像经典物理学研究物体运动一样,通过第一性原理(First-principles)来刻画模型在参数空间中的“运动轨迹”。
背景定位:从工具到科学
长期以来,深度学习理论落后于实践。当工程师们在通过调参让 LLM 获得惊人能力时,理论家们还在纠结泛化边界是否收敛。本文指出,深度学习理论正处于从“纯数学论证”向“实证科学”转化的拐点。作者认为,与其试图给模型找一个 worst-case 的界限,不如去研究它的 平均轨迹 和 宏观统计量。
五大核心支柱:如何解构这个黑盒?
1. 寻找“氢原子”:可解模型 (Solvable Settings)
物理学通过氢原子理解量子力学。在深度学习中,深度线性网络 (Deep Linear Networks) 和 核方法 (Kernel Methods) 就是这样的“原型”。尽管它们简单,却能展示出深度学习的关键特征,如 贪婪低秩偏置 (Greedy Low-rank Bias)——模型会优先学习数据中信号最强的分量。
2. 无限大的魅力:简化限制 (Tractable Limits)
当神经元数量趋于无穷大时,复杂的非线性相互作用会进入“平均场”状态。论文详细对比了两种制度:
- Lazy/Kernel Regime:权重几乎不动,特征不演化。
- Rich/Feature-learning Regime:特征随训练动态调整,这是通向智能的必经之路。
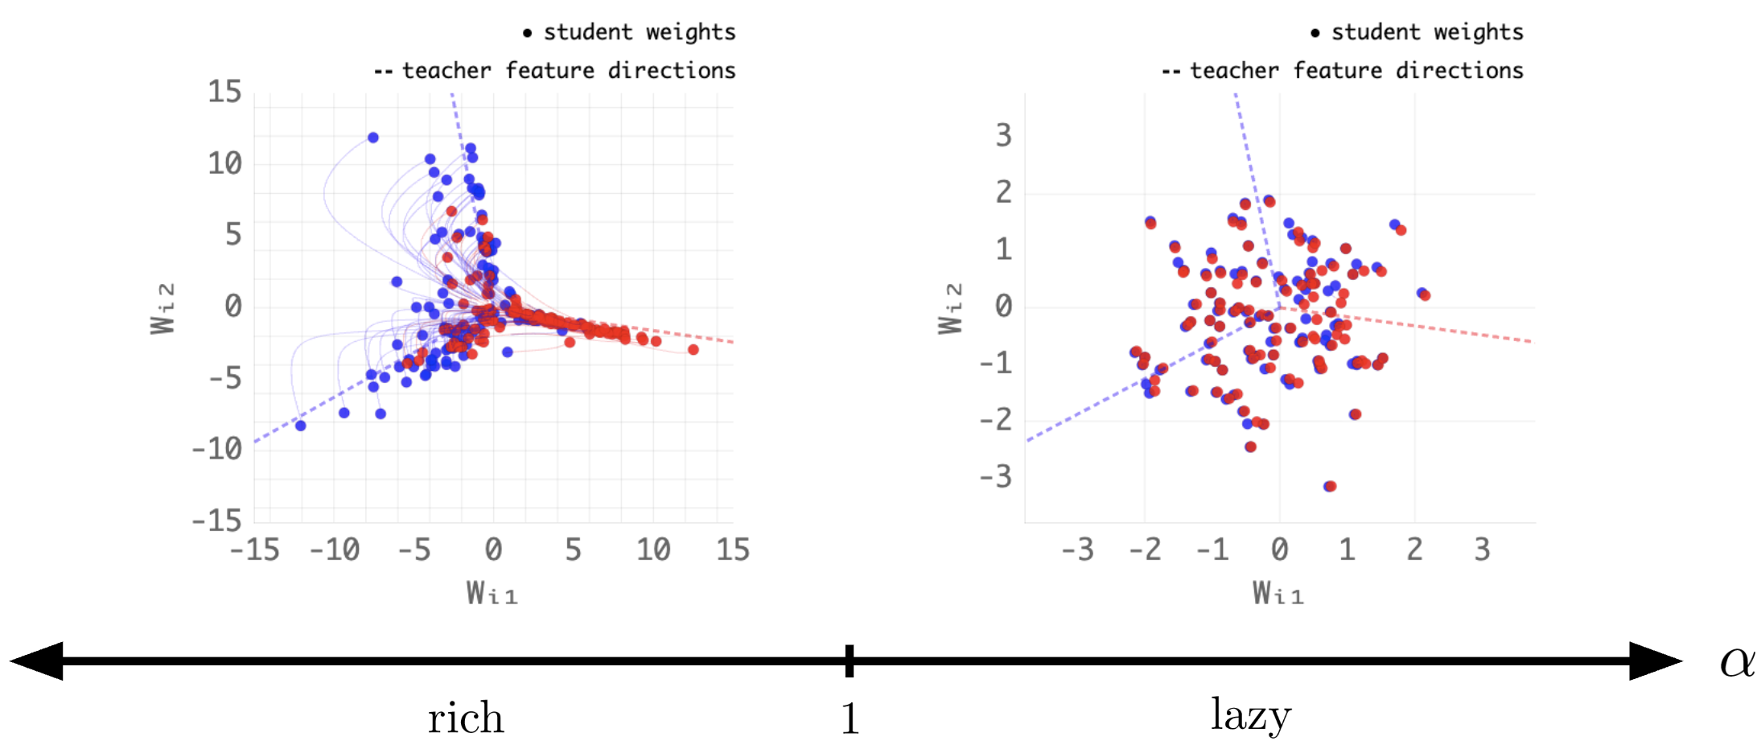 图 1:α 参数的微调决定了模型是“偷懒”地拟合还是“勤奋”地学习特征。
3. 宏观规律:神经缩放法则 (Scaling Laws)
就像波义耳定律描述气体宏观状态一样,Scaling Laws 证明了测试损失仅仅取决于计算量、数据量和模型大小这三个变量。这暗示了在混乱的随机梯度下降背后,存在极度简洁的决定性力量。
4. 超参数的解耦 (Disentangling Hyperparameters)
通过 P (Maximal Update Parameterization) 理论,研究者发现学习率等超参数可以独立于模型宽度。
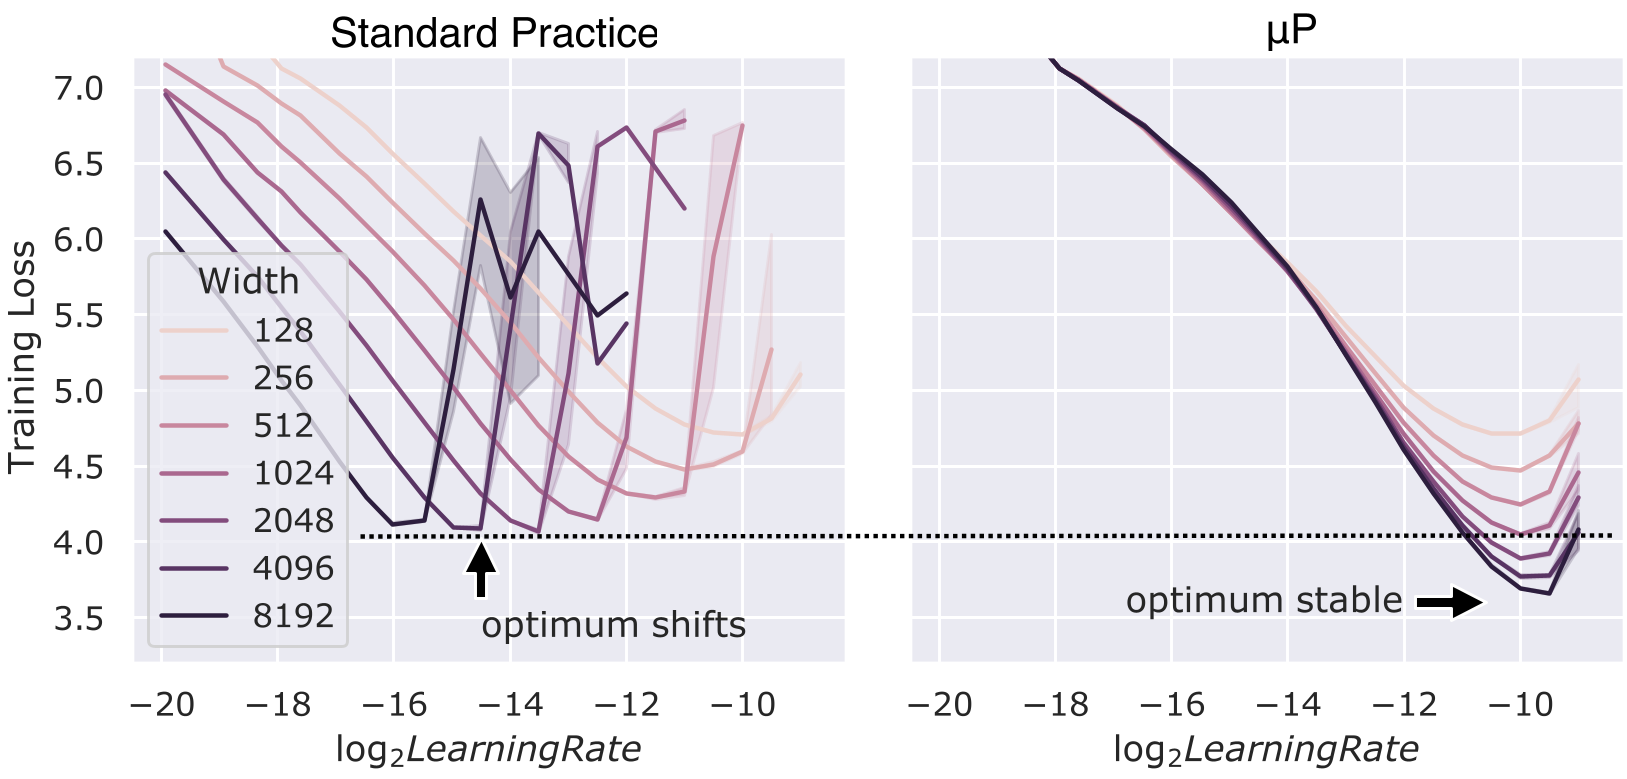 图 2:在 P 下,小模型的最佳学习率可以直接应用到大模型上,大大节省了算力成本。
5. 普遍性 (Universality)
无论架构是 Transformer 还是 CNN,大型模型最终往往学习到相似的内部表示,这被称为 Platonic Representation Hypothesis。这说明模型不再是盲目拟合,而是在通过不同的路径“捕获”客观世界的统计结构。
深度洞察:物理与生物的共生
作者提出了一个极具启发性的类比:
- 机械可解释性 (Mechanistic Interpretability) 是深度学习的“生物学”,研究具体的电路和特征。
- 学习力学 (Learning Mechanics) 则是深度学习的“物理学”,研究驱动这些电路形成的动力学和能量景观。
“没有进化的生物学是没有意义的”,同理,如果不理解模型在训练过程中如何“运动”,我们也无法真正理解最终生成的静态黑盒。
总结与未来
《学习力学》的提出标志着领域的一次范式转移。它不仅仅是关于数学证明,更是关于 定量预测。
局限性:目前该理论在处理“自然数据”的复杂结构上仍显不足,且尚未能完美预测 Scaling Laws 的具体指数。
未来工作:如何定义什么是“特征”?能否实现零调参训练?这些不仅是学术难题,更是迈向 AGI 通用工程化的关键一步。通过跨学科的协作,我们或许真的能迎来深度学习的“牛顿时代”。