
SilverSpeak:视觉欺骗如何让 SOTA AI 文本检测器全线溃败?
SilverSpeak: Evading AI-Generated Text Detectors using Homoglyphs
本文提出了 SilverSpeak,一种基于同形文字(Homoglyphs)的对抗性攻击方法。通过将文本中视觉相似但编码不同的字符(如拉丁字母 'A' 替换为西里尔字母 'А')进行替换,该方法成功使包括 Binoculars 和 Fast-DetectGPT 在内的 7 种 SOTA AI 文本检测器失效,将平均 MCC 分数从 0.64 降低至近乎零相关的 -0.01。
TL;DR
如果将论文中的拉丁字母 "a" 换成肉眼无法分辨的西里尔字母 "а",AI 文本检测器还能识别它吗?答案是:完全不能。最新论文 SilverSpeak 揭示了一种极其简单却致命的攻击手段——同形文字攻击(Homoglyph-based Attacks)。通过极低比例的字符替换,研究者成功让目前最顶尖的 7 种检测器(如 Binoculars, Fast-DetectGPT 等)在 5 大数据集上彻底失效,平均检测效能 (MCC) 直接归零。
痛点深挖:检测器的“视觉盲区”
目前市面上的 AI 检测器主要分为三类:基于概率统计的(如检测困惑度 Perplexity 的变化)、基于深度学习分类器的(如 RoBERTa 变体)以及数字水印(Watermarking)。
这些方法的共同弱点在于:它们极度依赖 Tokenization(分词) 的一致性。作者敏锐地察觉到,同形文字(Homoglyphs,即长得一模一样但 Unicode 编码不同的字符)可以在不改变人类阅读体验的前提下,从底层二进制层面彻底颠覆 NLP 模型的理解逻辑。
方法论:四两拨千斤的“降维打击”
SilverSpeak 的攻击逻辑非常直观:
- 随机攻击 (Random Attack):随机选择文本中 5%、10%、15% 或 20% 的可替换字符。
- 贪婪攻击 (Greedy Attack):替换所有可能被替换的同形字符。
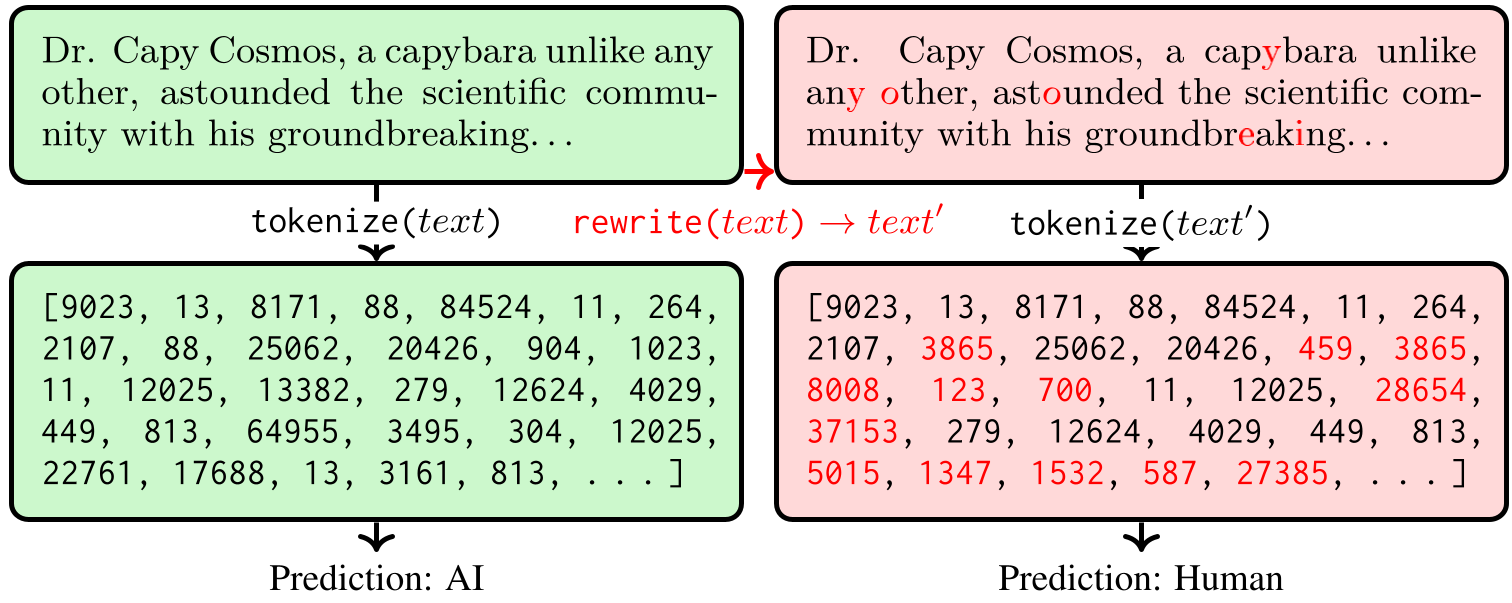 图 1:左侧为原始文本,右侧为攻击后文本。人类肉眼无法分辨,但分词结果(红字部分)已面目全非。
为什么这招这么灵?(技术直觉分析)
- 对于困惑度模型 (Perplexity-based):由于训练语料库极少混合不同语言的字符,攻击会导致分词器将一个词切碎成无意义的小块。这不仅增加了 Token 数量 ( 增大),还让每个 Token 的对数似然值 () 降到极低。最终结果是 Perplexity 飙升,检测器误以为这是“逻辑混乱”的人类作品。
- 对于分类模型 (Classification Models):通过 UMAP 降维可以发现,攻击后的文本 Embeddings 被挤压到了一个与 AI 训练分布完全不重叠的“盲区”。
- 对于水印技术 (Watermarking):水印依赖前一个 Token 推导当前 Token 的伪随机序列。攻击直接切断了 Token 序列的连续性,导致水印规则链条崩断。
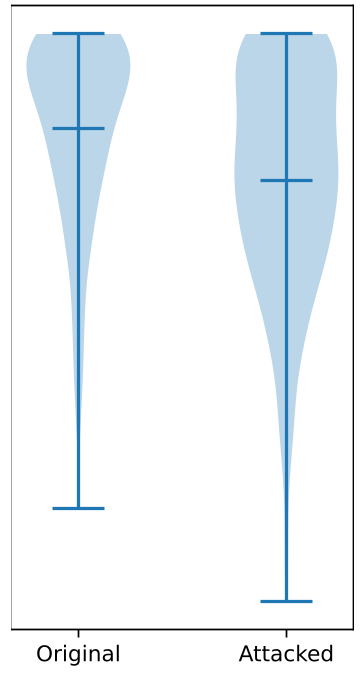 图 2:攻击导致 Loglikelihood 分布发生显著负向偏移(向左平移),使文本看起来“非常人类”。
实验战绩:一场不对称的战争
在 CHEAT、Reuters 等五个权威数据集上,作者测试了包括 OpenAI detector、Binoculars 在内的 7 个知名检测器。
- 惨烈的 MCC 表现:在 15%-20% 的微小替换下,原本表现优秀的检测器 MCC 从 0.64 附近狂跌至接近 0(甚至出现负相关)。
- 顽固的失败:即使是针对单一模型优化的“水印”技术,在 10% 的攻击下精度也无法维持。
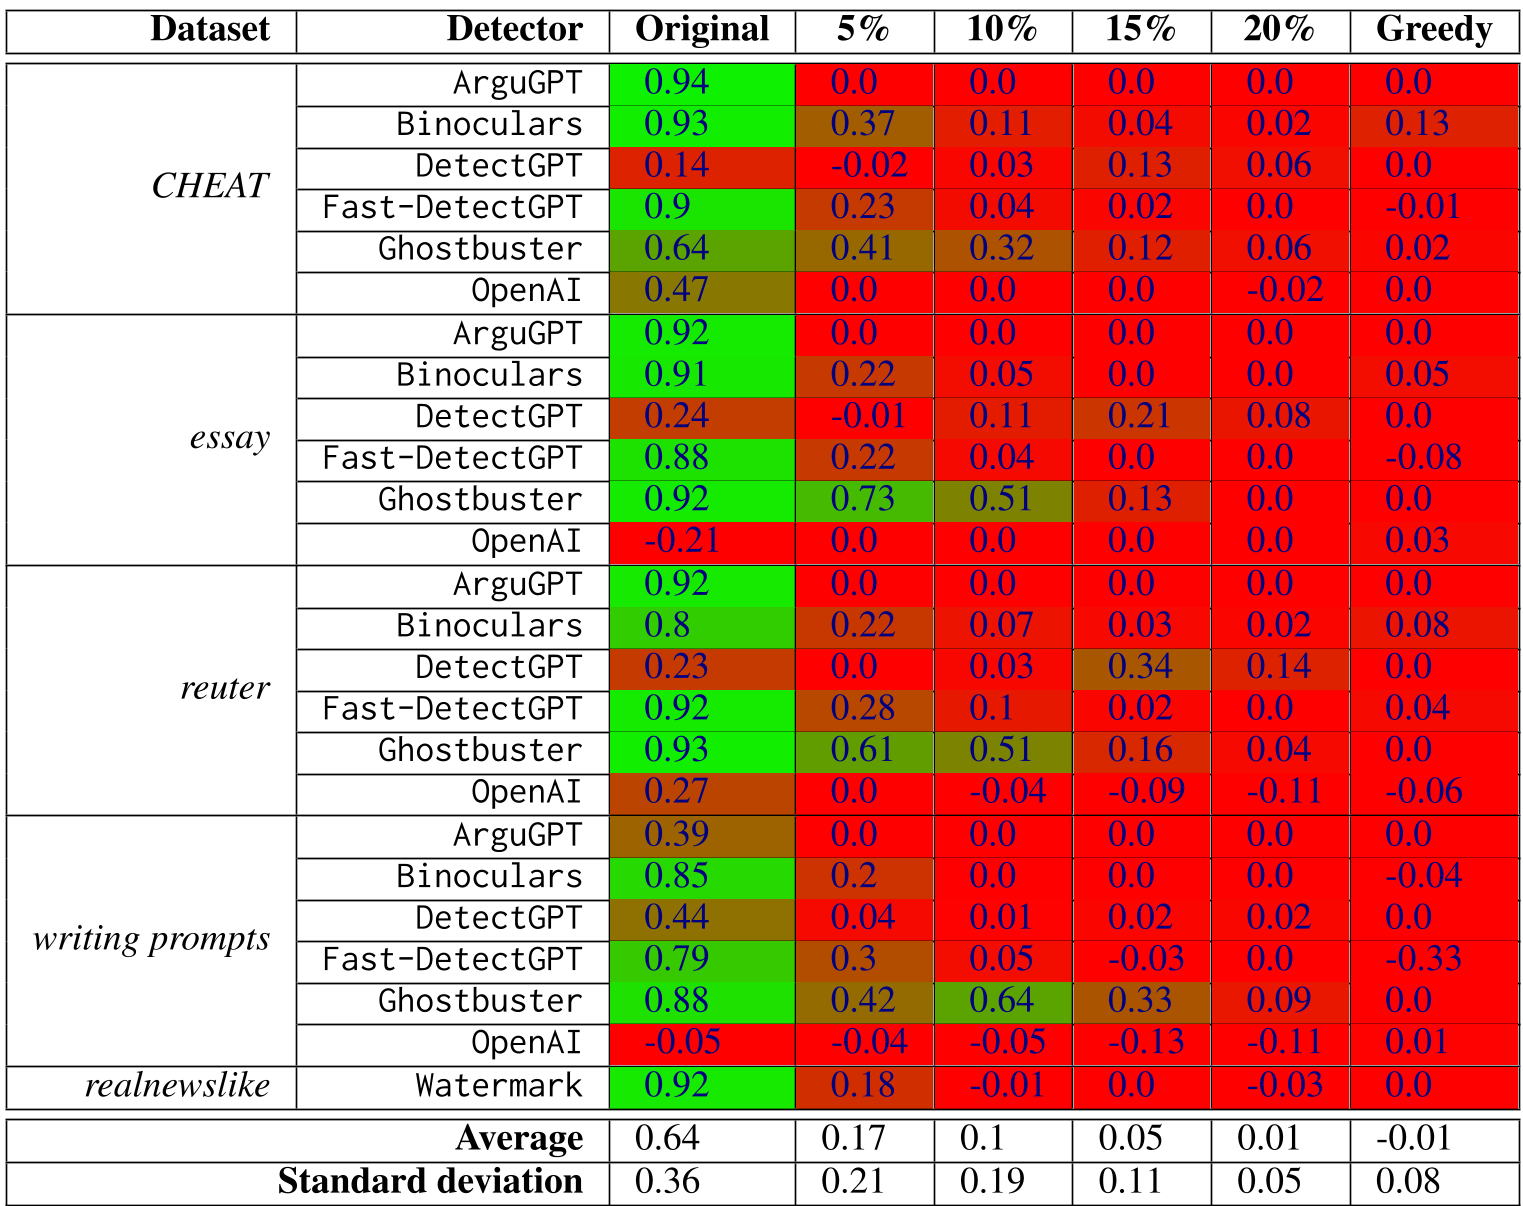 表 1:随着替换比例增加,所有检测器的平均 MCC 从 0.64 稳步下降到 -0.01(完全失效)。
深度洞察与总结
SilverSpeak 的研究再次印证了 "AI 安全的木桶效应":无论算法多么复杂,如果底层分词和字符处理逻辑存在漏洞,整套防御系统都会像海市蜃楼一样脆弱。
启示与未来防御建议:
- 输入约束 (Input Constraints):最简单的防御是加入一层“字符映射”,将所有 Unicode 扩展字符强制转换回其标准拉丁形式。
- 视觉检测:引入 OCR 或类似于人眼视觉的特征提取模型,忽略编码层面的干扰。
- 困惑度分析:利用特定的 Loglikelihood 偏移特征来检测此类字符混淆攻击。
结论:在 AI 文本检测器真正解决鲁棒性问题之前,我们不应过度依赖它们来维持学术诚信或新闻真实。