
SilverSpeak:只需改几个字母,就能让所有 AI 文本检测器彻底失灵
SilverSpeak: Evading AI-Generated Text Detectors using Homoglyphs
本文提出了 SilverSpeak,一种基于同形文字(Homoglyphs,如将拉丁字母 'A' 替换为西里尔字母 'А')的对抗性攻击方法。该方法旨在规避现有的 AI 生成文本检测器,并在 ArguGPT, Binoculars, DetectGPT 等七种主流检测器上实现了全面绕过。
TL;DR
随着 ChatGPT 等 LLM 的普及,各类 AI 检测器(Detectors)应运而生。然而,来自爱尔兰和尼泊尔的研究团队最近发表的一项研究(SilverSpeak)给了这个领域沉重一击:通过使用 同形文字(Homoglyphs)——即那些看起来一模一样但编码不同的字符(比如把英文 'a' 换成西里尔文 'а')——可以轻易让 SOTA 检测器全线崩溃。实验表明,这种攻击能将检测器的核心性能指标 MCC 从 0.64 直接拉低到接近 0(完全失去相关性)。
痛点深挖:为何检测器如此脆弱?
目前的 AI 文本检测器主要分为三类:
- 基于困惑度(Perplexity-based):认为 AI 生成的文本更“平滑”,逻辑概率更高。
- 分类模型(Classifier-based):如基于 RoBERTa 微调的分类器,通过学习 AI 和人类文本的特征差异来判断。
- 水印技术(Watermarking):在生成时通过算法操纵特定 Token 的出现频率。
作者发现,这些模型的共同弱点在于对 Tokenization(分词) 和 分布空间 的过度依赖。只要微小地改变字符编码,就能在不改变语义(人类视觉无感知)的前提下,完全破坏统计特征。
方法论:同形攻击的隐蔽与高效
这项研究并没有采用复杂的强化学习来重写文本,而是回归了最原始的“视觉欺骗”。
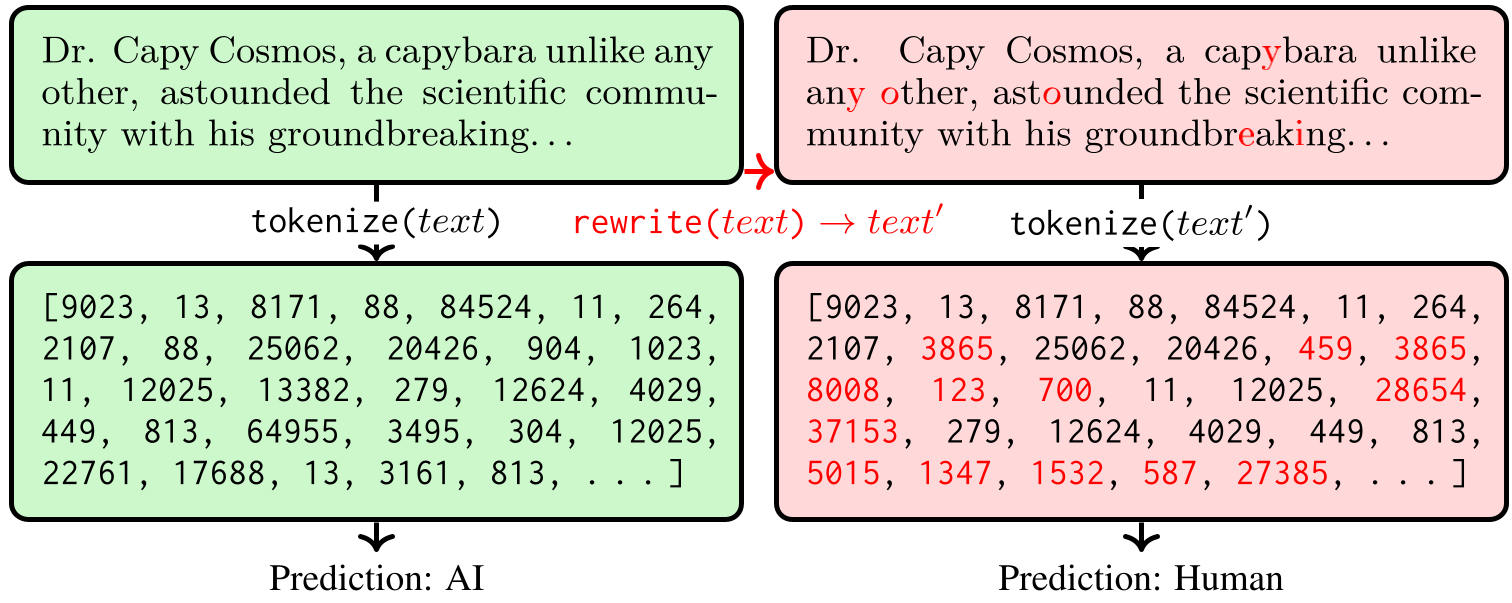 图 1:左侧为原始文本,右侧为同形替换后的文本。人类肉眼几乎看不出区别,但底层 Token 编码已发生巨变。
为什么这能打败 AI?
- 对于困惑度模型:由于 BPE(字节对编码)分词器在训练时很少见到混合字母表的 Token,一旦插入同形文字,原本的一个单词会被切碎成多个碎片,导致序列长度 增加,且每个碎片的对数似然值 骤降。这使得 AI 文本在检测器眼中瞬间变得“像人类一样乱七八糟”。
- 对于分类模型:通过 UMAP 降维可以发现,攻击后的文本嵌入(Embeddings)直接逃逸到了模型未曾训练过的“未知领域(Hidden Space)”。
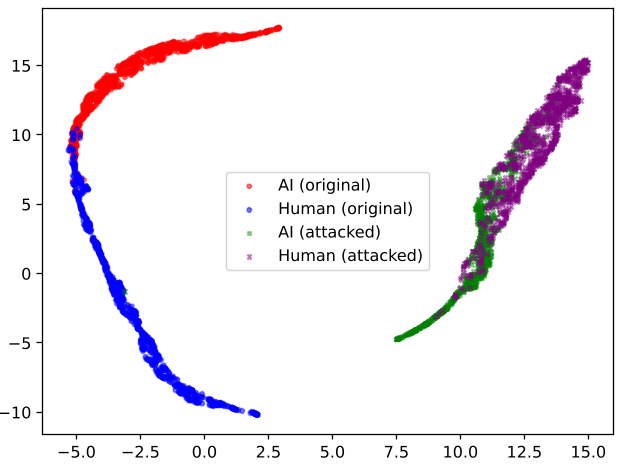 图 2:ArguGPT 的嵌入空间。可以看到,原始的 AI(紫色)和人类(绿色)文本界限分明,但攻击后的文本(灰色区域)纠缠在一起,完全失去了判别性。
实验战绩:全线崩溃
研究人员在 5 个数据集和 7 个主流检测器(包括 OpenAI 的官方检测器和著名的 Binoculars)上进行了测试。结果令人震惊:
- 无差别杀伤:无论是随机替换 5% 或是贪婪替换(Greedy),原本表现优异的 Binoculars 和 Fast-DetectGPT 性能均出现断崖式下跌。
- 水印失效:基于
lefthash的水印算法对分词极其敏感,攻击改变了前序 Token 的 Hash 值,导致原本被标记的“绿词”列表完全错位。
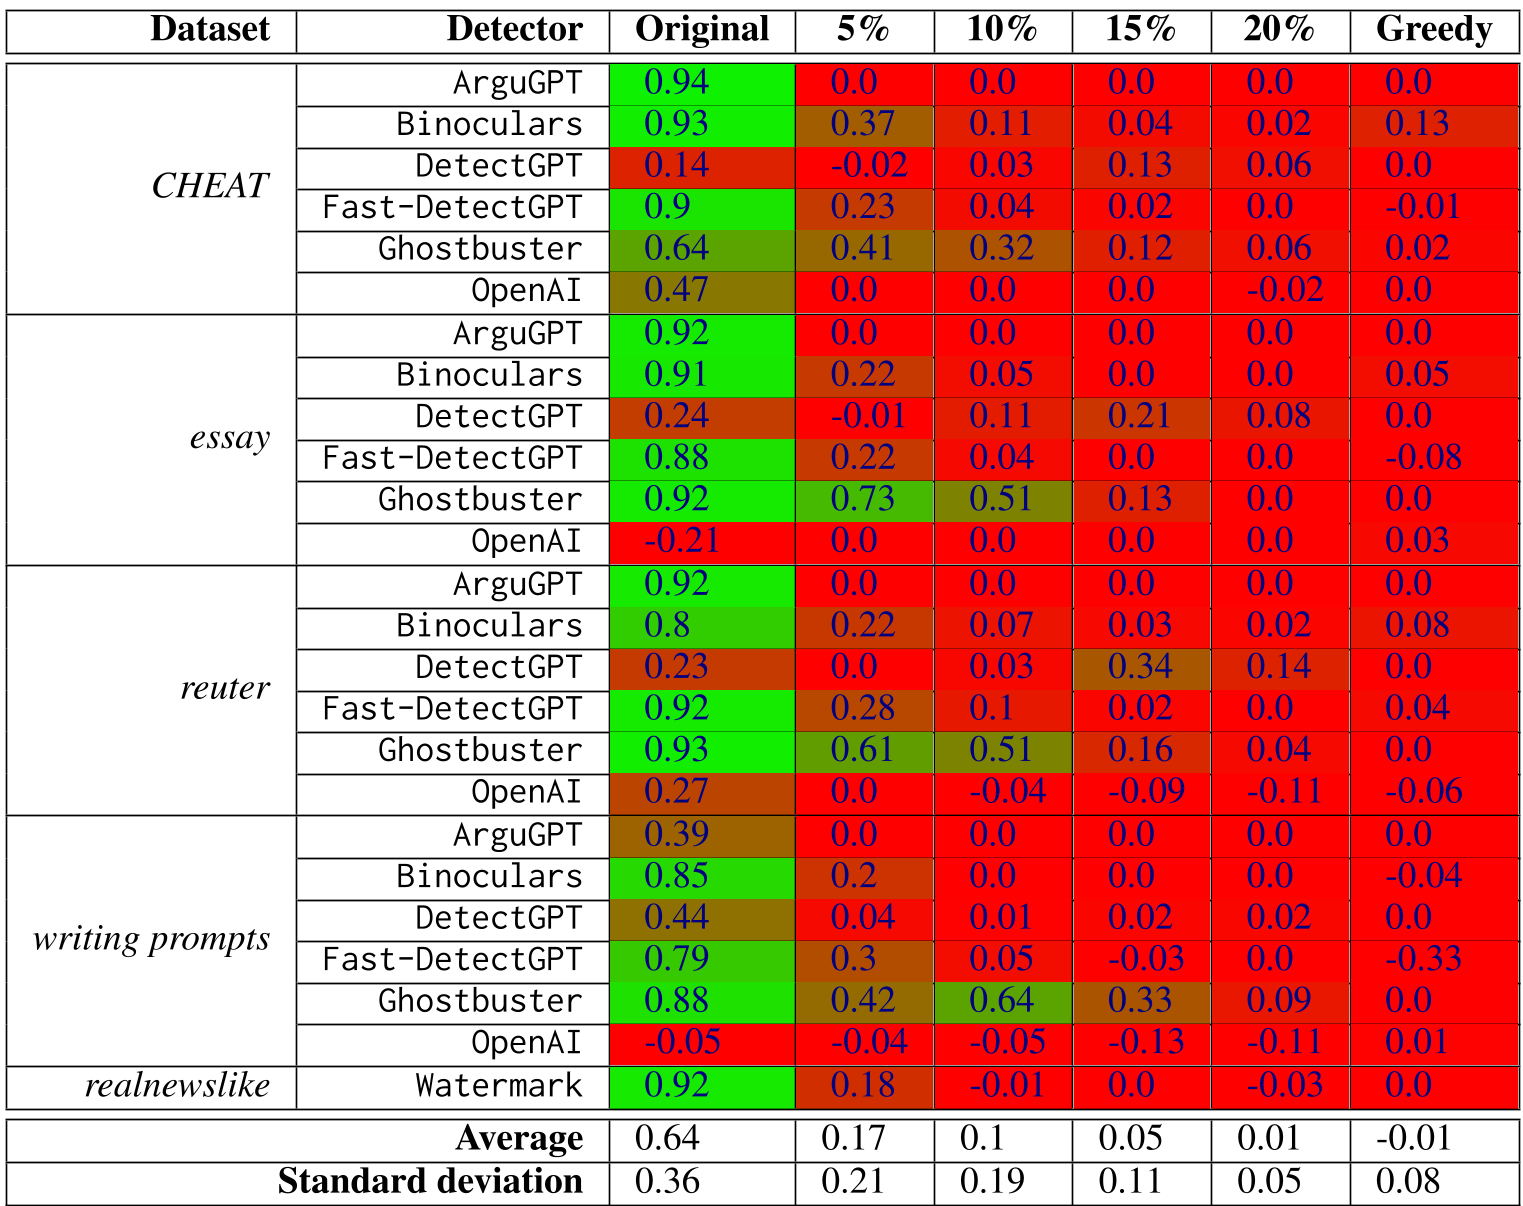 表 1:各检测器在不同攻击比例下的 MCC 表现。可以看到在 Greedy 设置下,平均 MCC 仅为 -0.01。
深度洞察与总结
SilverSpeak 的成功并非因为它的算法更先进,而是因为它暴露了当前 NLP 安全研究中的一个基本假设漏洞:即输入的字符流是符合规范的 Unicode 语义。
未来的防御启示:
- 输入归一化(Normalization):在检测前,强行将所有字符映射到标准字符集。
- 鲁棒性训练:在检测器的训练集中加入对抗性的 Unicode 扰动数据。
- 视觉检测(OCR-based):既然这种攻击是基于视觉相似性的,那么“所见即所得”的 OCR 架构检测器或许是终极解决方案。
总结:如果你还在依赖市面上的 AI 检测工具来判定学术不端或虚假信息,请务必保持警惕。在 SilverSpeak 这种低成本攻击手段面前,目前的防线几乎形同虚设。