
[Perspective] 蛋白质组学与 AI 的大模型时代:从原始质谱到 AI 虚拟细胞的演进路线
Strategic priorities for transformative progress in advancing biology with proteomics and artificial intelligence
本文由西湖大学郭天南、马普研究所 Matthias Mann 等全球顶级专家联合撰写,探讨了蛋白质组学(Proteomics)与人工智能(AI)融合的战略路线图。文章提出了构建“AI 友好蛋白质组学态势”的核心框架,涵盖了从数据生成到 AI 虚拟细胞(AIVC)实现的七大关键价值领域。
TL;DR
蛋白质组学正处于从“测序完成”向“深度理解”跨越的关键节点。本篇由全球蛋白质组学领军人物共同发表的综述,系统性地揭示了 AI 如何重塑生物学。其核心逻辑在于:通过建立 AI 友好型数据生态,解决蛋白质鉴定、空间分布、药物扰动及多组学整合等七大挑战,最终目标是构造出能够模拟生命动态周期的 AI 虚拟细胞 (AI Virtual Cell, AIVC)。
1. 痛点:为什么蛋白质组学的 ImageNet 还没出现?
在 CV 领域有 ImageNet,在 NLP 领域有 Common Crawl,但在蛋白质组学领域,虽然公共仓库如 PRIDE 已经堆满了 PB 级的数据,却依然面临“数据孤岛”:
- 异质性强:不同仪器的分辨率、进样量(LC)和碎片化模式(HCD/CID)导致同一蛋白质的光谱千差万别。
- 批次效应 (Batch Effects):实验室间的环境波动和污染累积使得大数据集难以直接合练。
- 语义断层:复杂的 mzML 原始文件对于计算机科学家而言如同“天书”,急需像 Parquet 或 Tensor 这样更符合 AI 胃口的数据格式。
2. 核心架构:构建 AI 友好的生态系统
作者提出,进步的第一步不是算法,而是数据基建 (Infrastructure)。
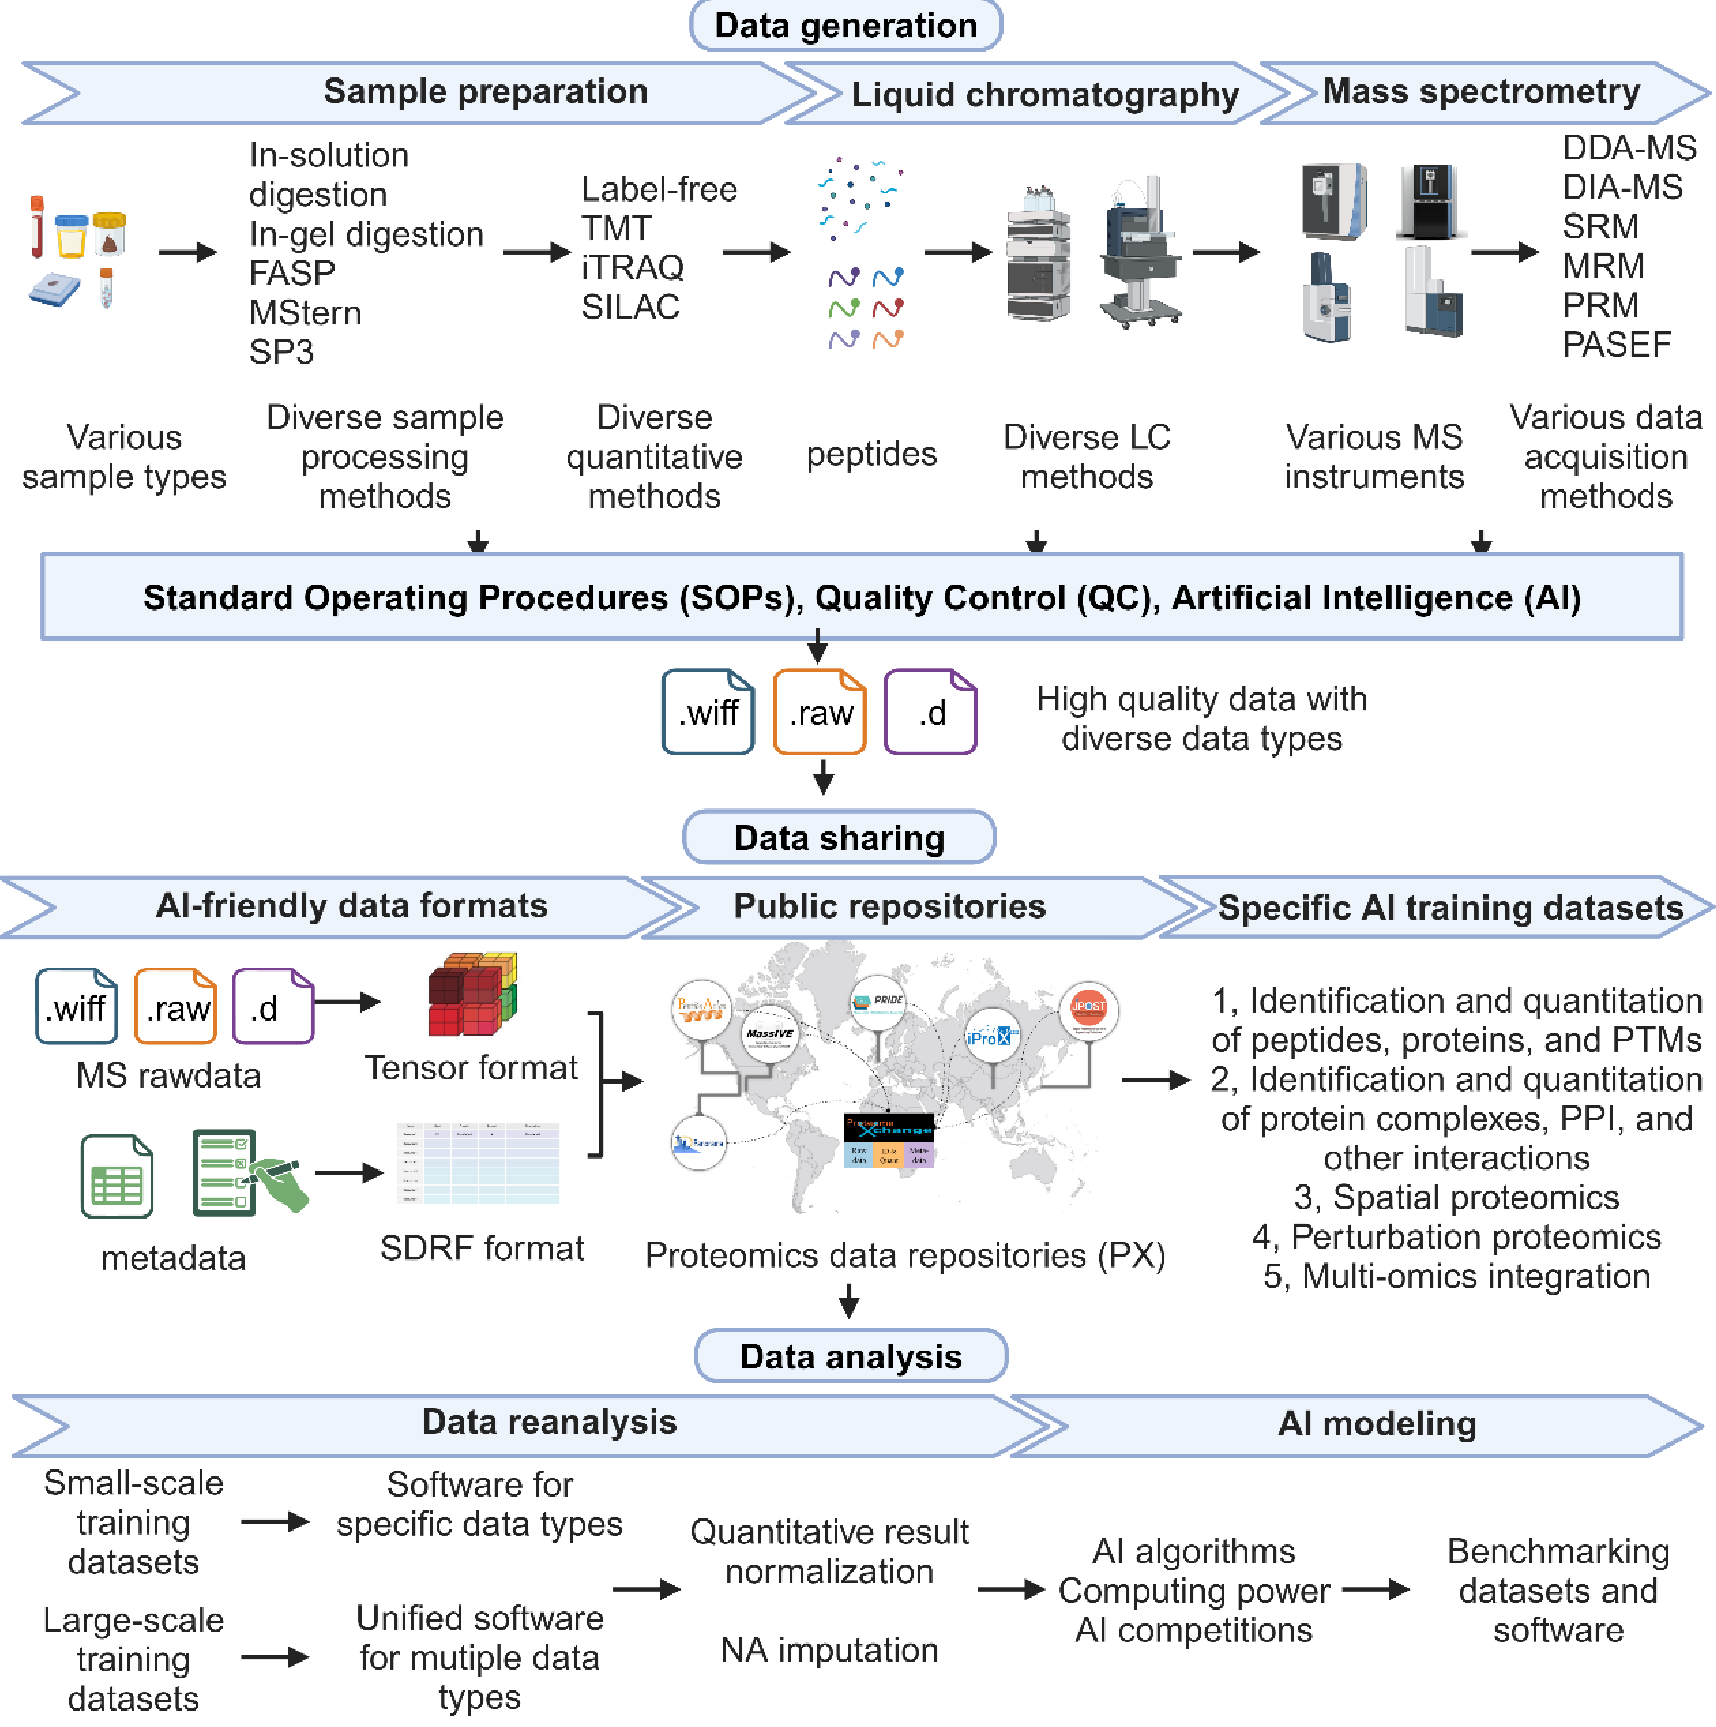 图 1:蛋白质组学 AI 友好生态系统的三阶段建设:生成、共享与分析。
- 标准化 (SOPs):通过像 π-HuB 或 CPTAC 这样的中心化设施,使用受控的仪器群生成“黄金标准”训练集。
- 合成数据 (Synthetic Data):在真实数据不足时,利用 AI 生成模拟光谱(如 AlphaPeptDeep),为算法评估提供无限的负样本和基准。
- 元数据关联:利用 SDRF 颗粒化存储临床表型,通过联邦学习 (Federated Learning) 解决医疗数据的伦理与共享难题。
3. 六大技术战场的 AI 攻坚
AI 正在蛋白质组学的每一个毛细血管中发生作用:
- 肽段鉴定 (Peptide ID): 从基于传统的得分匹配转向 Transformer 预测。例如 DIA-BERT 已经开始利用预训练大模型理解复杂的混合光谱 (Chimeric Spectra)。
- De novo 测序: AI 开始尝试在没有参考基因组的情况下,像翻译外语一样直接“读出”未知肽段序列。
- 蛋白质相互作用 (PPI): AlphaFold 3 的出现让静态结构预测走向巅峰,而 MS 数据则提供了动态、上下文相关的相互作用证据。
- 空间蛋白质组学 (Spatial Proteomics): 通过 深视觉蛋白质组学 (DVP),AI 能够自动识别组织切片中的特定细胞,指挥激光截取并进行超灵敏质谱分析。
- 扰动蛋白质组学 (Perturbation): 研究药物作用后蛋白质水平的动态波动,AI 能够通过已有的转录组预测蛋白质组的“合成扰动应答”。
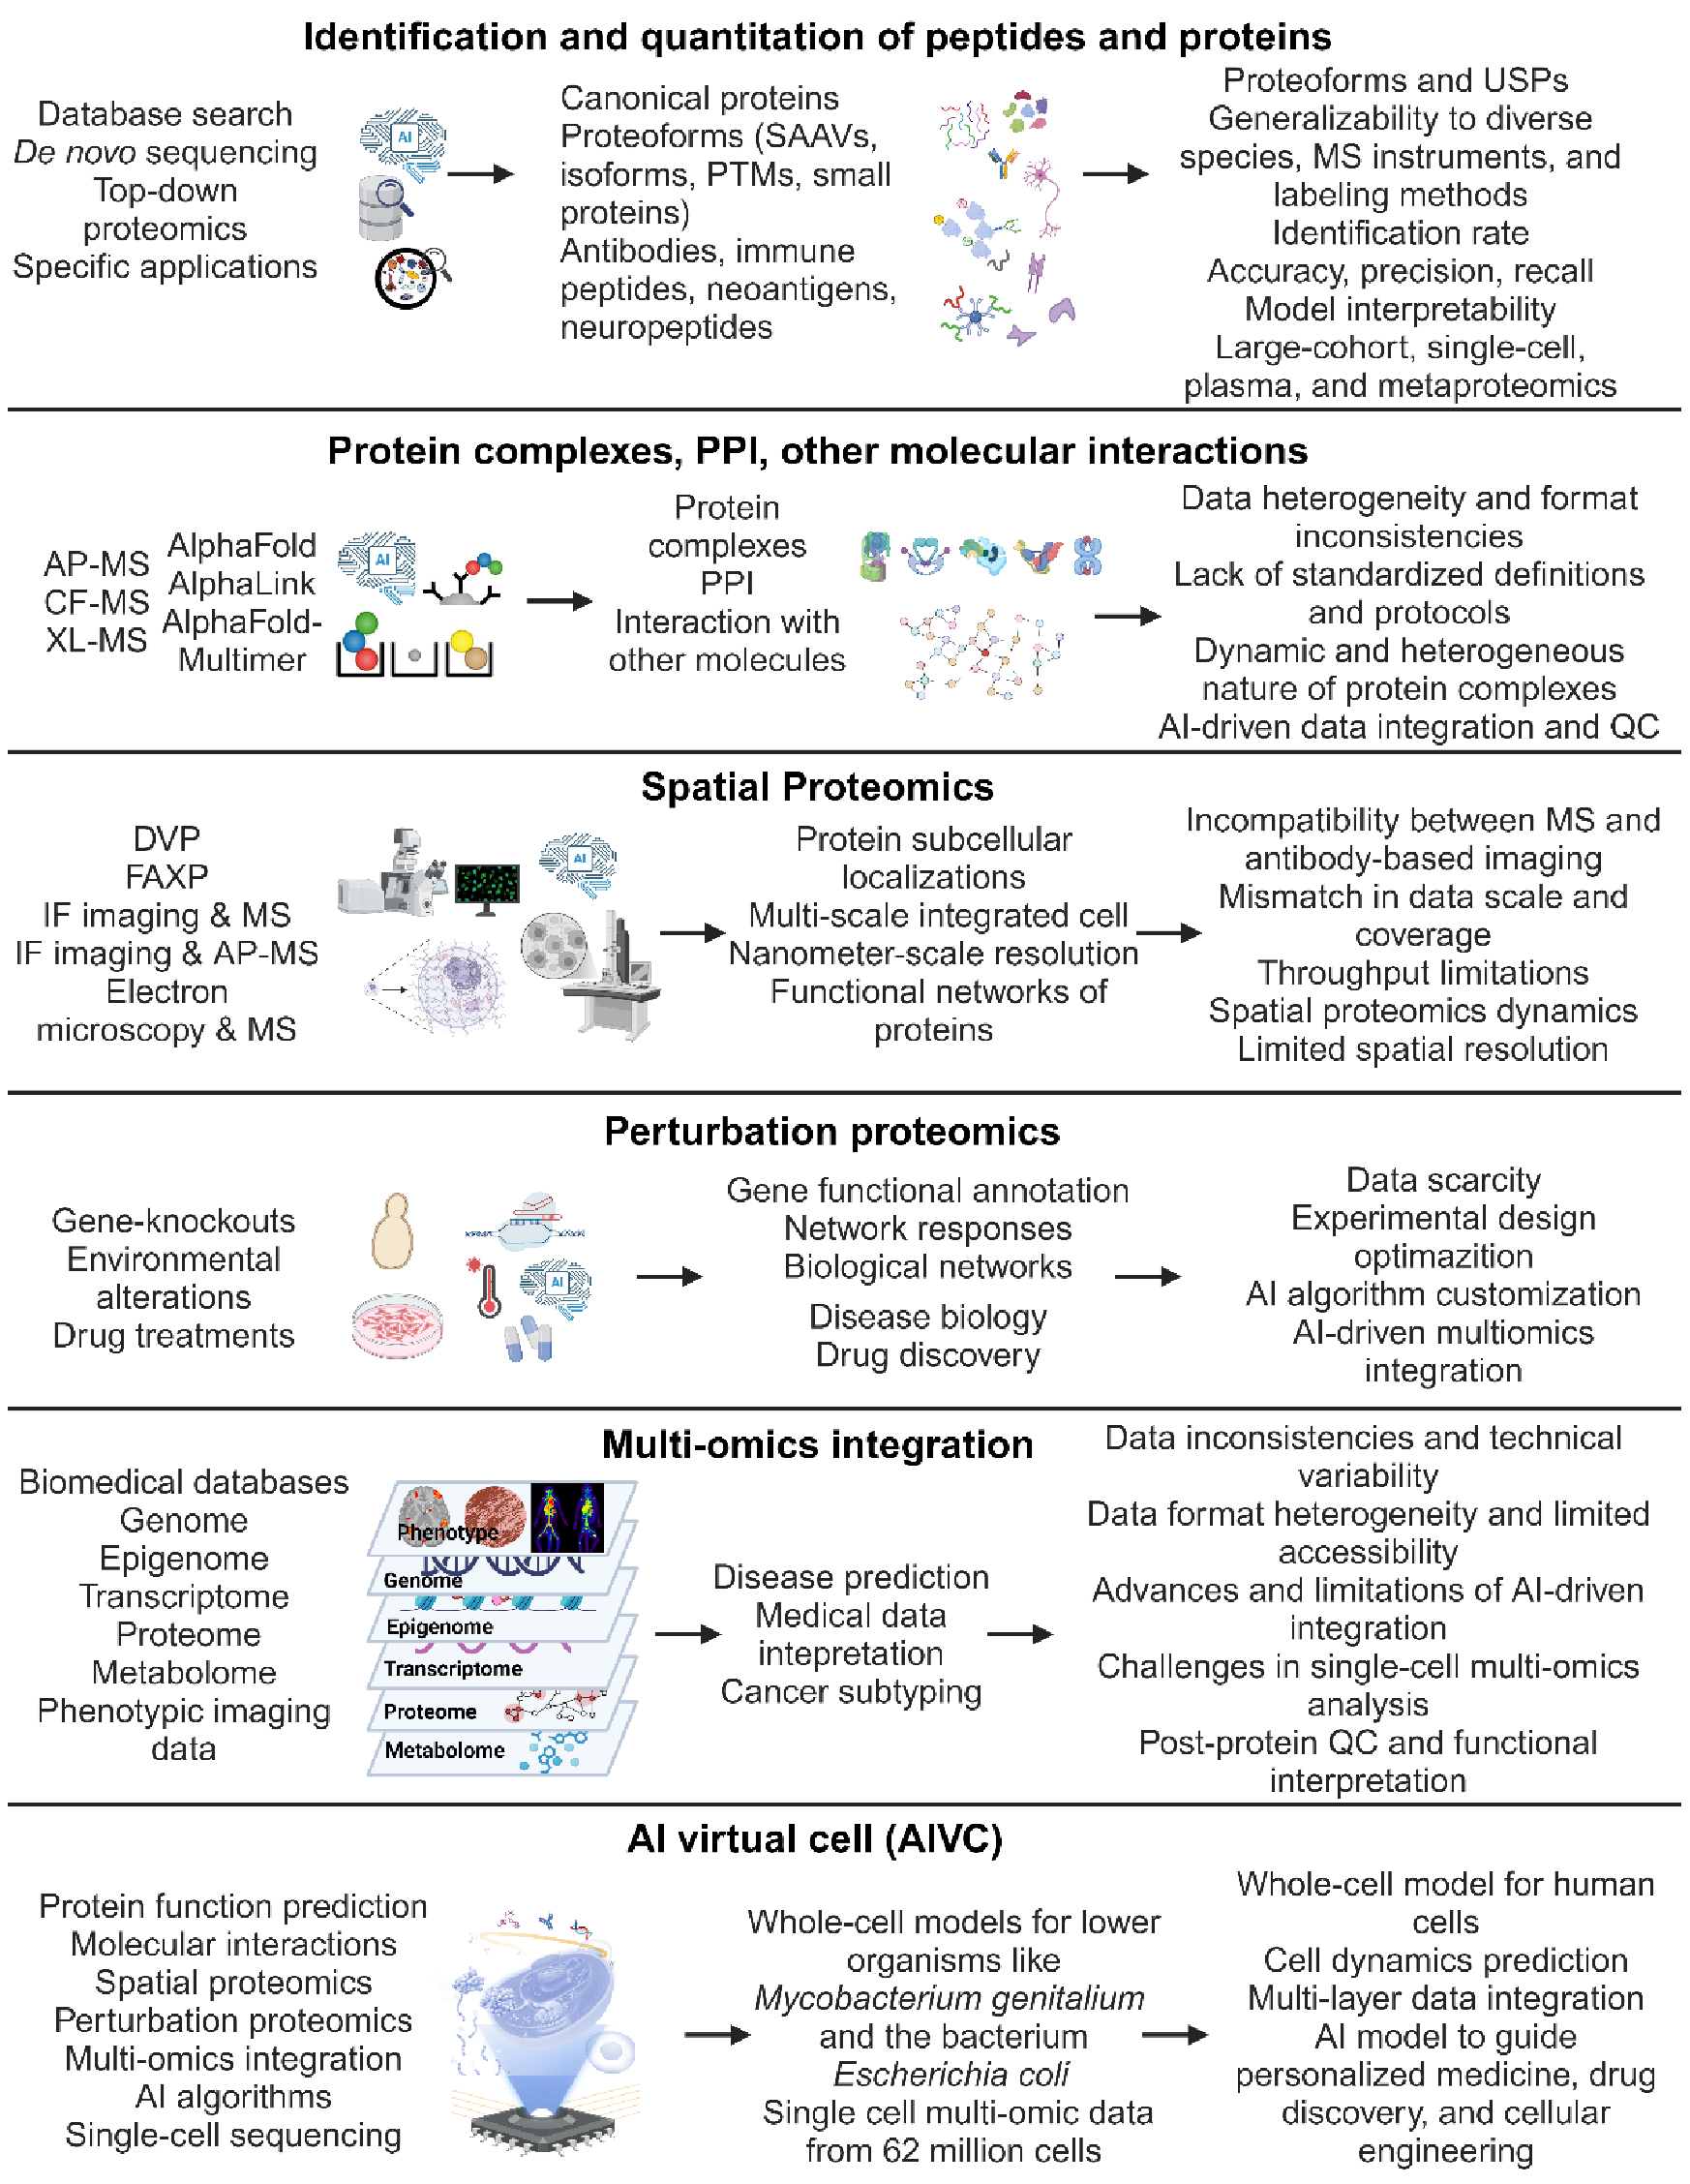 图 2:AI 蛋白质组学各领域的进展与挑战概览。
4. 深度洞察:终极愿景——AI 虚拟细胞 (AIVC)
虚拟细胞不再是一个静态的数据库,而是一个能够对环境变化做出逻辑推理的动力学模型。
- 功能预测:AI 不仅要识别蛋白质(What),还要通过学习 PTM(翻译后修饰)的功能分值预测蛋白质在干什么(How)。
- 生命网络建模:结合超分辨率成像和单细胞多组学,AIVC 将能够实现在计算机上进行的药物毒性测试和疾病机理推演。
5. 局限性与未来展望
尽管前景诱人,但作者坦言:模型的可解释性 (Interpretability) 和 跨物种泛化 (OOD Generalization) 仍是硬伤。此外,AI 算力基础设施的昂贵与蛋白质实验室的需求之间存在鸿沟。
总结 (Takeaway): 蛋白质组学正在经历它的“GPT-2 时刻”。通过跨学科协作,将千万量级的、带有明确元数据标注的光谱数据喂给大规模模型,我们即将迎来解析生命复杂系统的爆发点。
本文基于《Strategic priorities for transformative progress in advancing biology with proteomics and artificial intelligence》重构。