
深度综述:LLM 智能体评估的范式转移——从静态文本到动态决策
A Survey on Evaluation of LLM-based Agents
本文是学术界首份关于基于 LLM 的智能体(LLM-based Agents)评估方法的全面综述。文章系统梳理了从基础能力(规划、工具使用、反思、记忆)到特定领域应用(Web、软件工程、科学研发、对话系统)的评估矩阵,并分析了 GAIA、SWE-bench 等核心 Benchmark 的演进趋势。
TL;DR
随着生成式 AI 从“聊天机器人”向“自主智能体(Autonomous Agents)”进化,评估的标准正在发生根本性变革。本文通过对最新综述《A Survey on Evaluation of LLM-based Agents》的深度解析,揭示了当前科研界如何定义、测量并挑战智能体的极限。
背景定位:这是该领域第一篇全景观式的综述,它不仅是 Benchmark 的索引,更是对“如何构建一个可信智能体”的哲学反思。
痛点深挖:为什么 MMLU 救不了智能体?
传统的 LLM 评估(如 MMLU, GSM8K)本质上是静态判卷。然而,一个真正的智能体需要在动态环境中:
- 感知:解析复杂的 HTML 或代码库。
- 规划:将用户模糊的需求拆解为子任务。
- 行动:通过 API 或 GUI 进行交互。
- 反思:根据环境报错(Error Message)修正路径。
现有评估最大的痛点在于环境退化。如果在静态的网页快照上测试 Web Agent,它永远无法学会处理“点击后页面未响应”这种真实的工程异常。
方法论详解:评估的五大支柱
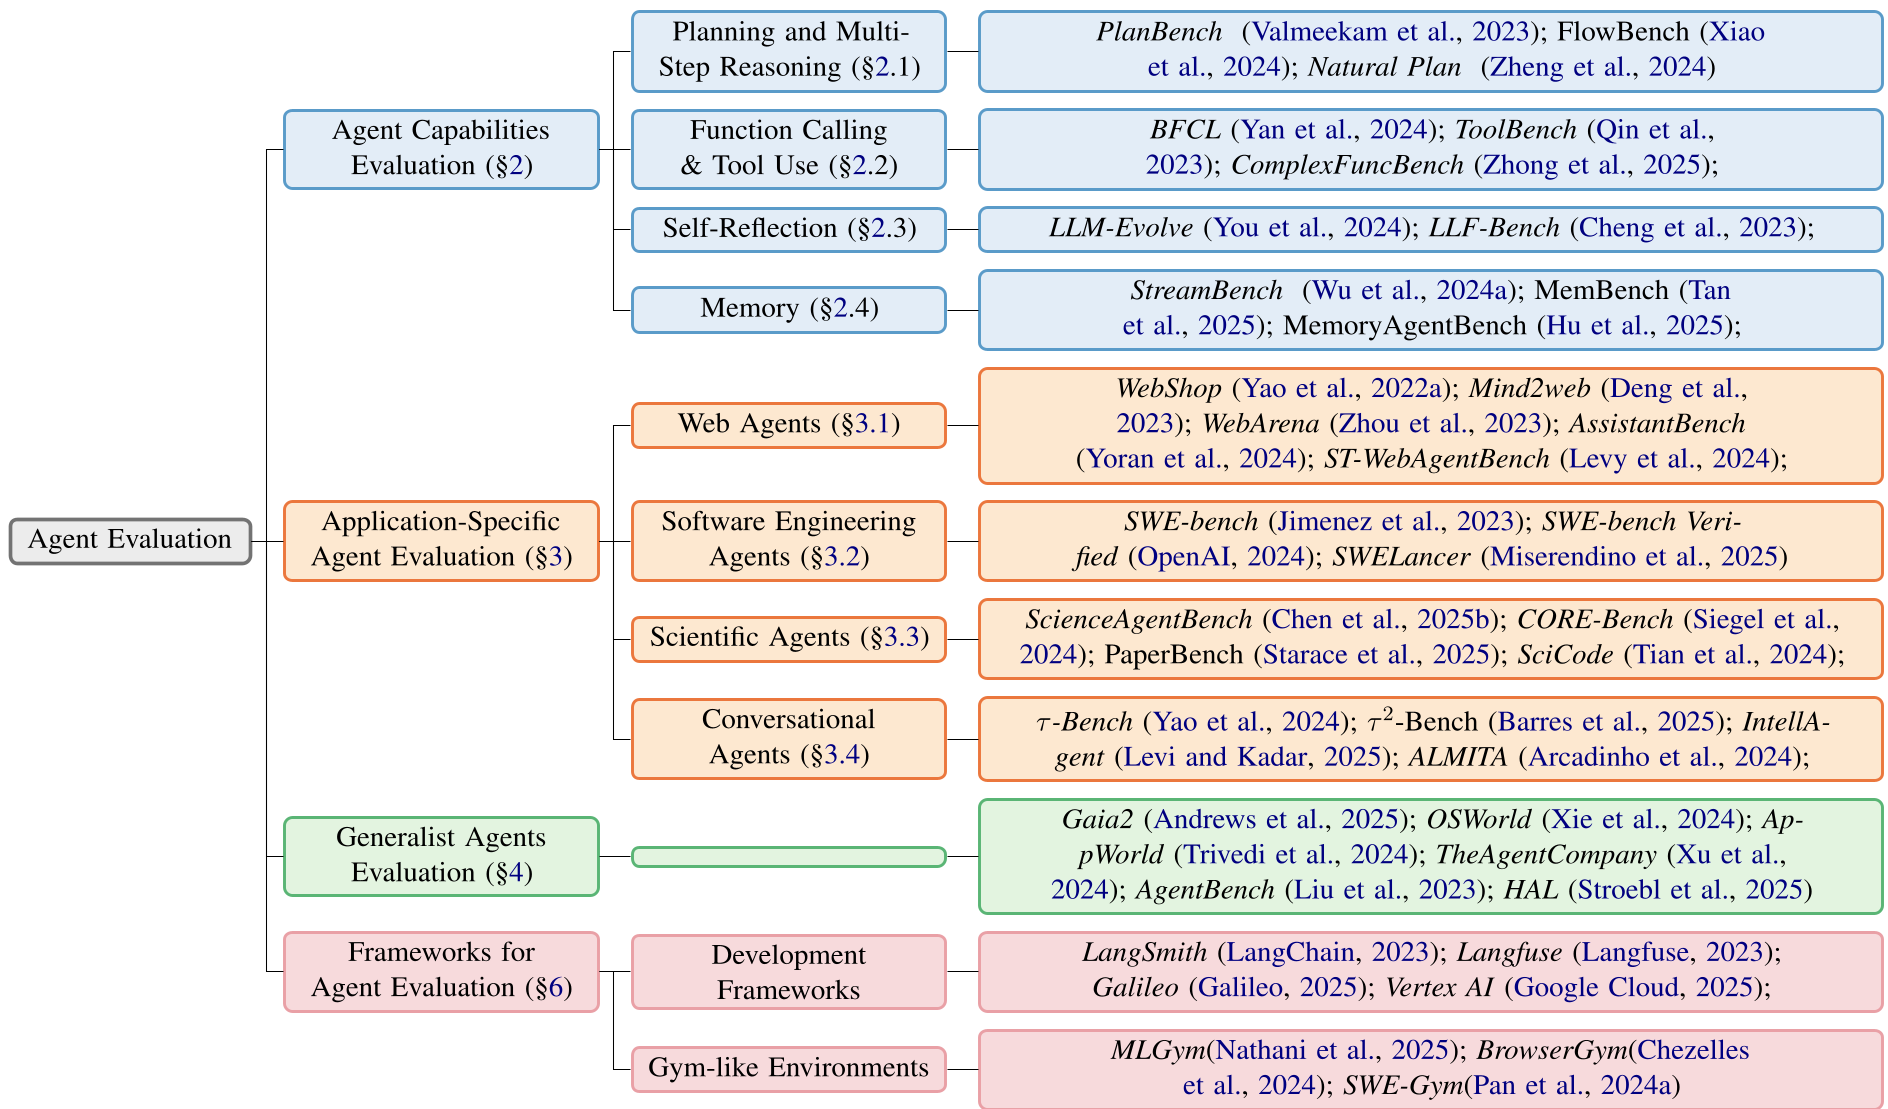
论文将评估体系拆解为层层递进的结构:
1. 原子能力 (Core Capabilities)
- Planning: 论文指出,即使是顶尖模型在处理验证约束较多的长程规划(Long-horizon planning)时依然力不从心。
- Tool Use: 从简单的单步函数调用进化到复杂的嵌套调用(Nested API calls)。
- Memory: 区分情节记忆(过去交互)与语义记忆(事实知识)。
2. 环境与接口 (Environment & Interface)
智能体与世界的交互方式决定了评估的难度。
- Code/Terminal: 如 SWE-bench,强调逻辑严密性。
- GUI/Visual: 如 WebVoyager,强调多模态理解与定位。
实验与结果:SOTA 的真实战力
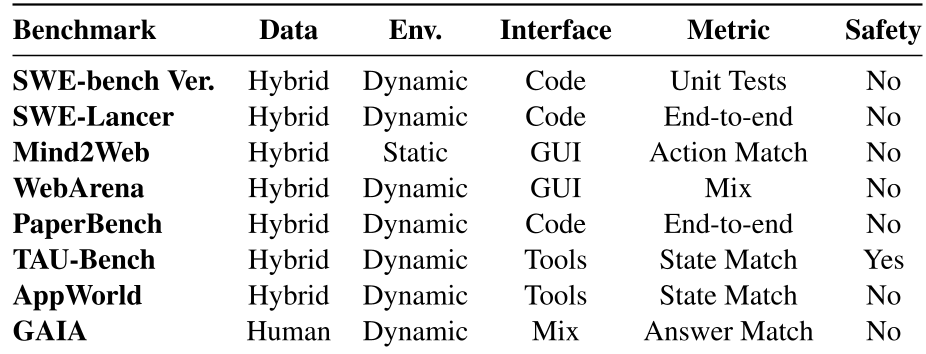
综述汇总了多个主流 Benchmark 的现状:
- 软件工程 (SWE):SWE-bench Verified 的成功率已攀升至 80% 左右,导致该榜单开始饱和。但更难的 SWE-bench Pro 成功率仍不及 25%。
- Web 探索:WebArena 仍是金标准,但研究发现部分模型在某些 Benchmark 上存在“过度乐观”的表现预测,需要更严苛的测试。
深度洞察:未来评估的三个战场
1. 解耦 LLM 与支架 (Scaffold)
目前的评估往往混淆了“模型行不行”和“框架设计得好不好”。未来的趋势是如 Harbor 这种框架,通过固定支架设计来公平对比底层模型的“智能体潜力”。
2. 细粒度轨迹分析 (Granular Trajectory)
仅看“任务是否完成(Pass/Fail)”已经不够了。如果你转了 100 圈才完成任务,即便成功也是低效的。我们需要对推理路径(Reasoning Traces)进行阶梯式评估。
3. 安全与合规 (Safety Guardrails)
这是企业级部署的“最后公里”。智能体是否会因为一条指令就删库跑路?目前的 Benchmark 极度缺乏对这种“破坏性行动”的惩罚机制。
总结
智能体评估正在进行一场从“答题”到“生存测试”的突变。对于开发者而言,选择正确的测试沙盒(如 Docker 化的环境)并关注执行轨迹的成本与安全,将是 2026 年后智能体竞赛的关键胜负手。
注:本文基于 2026 年最新综述整理。