
LLM-as-a-Judge:从自动化评估到 AI 自演进的逻辑支点
A survey on llm-as-a-judge
本文对 "LLM-as-a-Judge"(LLM 作为评委)领域进行了全面的综述,正式定义了该范式并提出了构建可靠评价系统的框架。研究涵盖了从 Prompt 设计、模型微调到后处理的完整流水线,并推出了针对模型、数据、智能体及推理能力的 meta-evaluation(元评价)基准。
TL;DR
在 AI 开发的军备竞赛中,如何衡量一个模型“比另一个好”正成为核心瓶颈。本文系统性地整理了 LLM-as-a-Judge 这一新兴范式——即利用强大的 LLM(如 GPT-4, Qwen 等)作为评委,去评价、打分或选择其他模型的输出。它解决了传统指标(BLEU/ROUGE)“懂词不懂义”的尴尬,同时通过多轮投票、Prompt 链等策略大幅逼近人类专家的判断水平。
痛点深挖:评测的规模化困境
长期以来,NLP 领域被困在两难境地:
- Expert Human Evaluation (昂贵的金标):虽然准确,但在处理百万级数据集或实时反馈时,成本和速度完全无法接受。
- Traditional Metrics (肤浅的刻度):过于依赖表面词法重叠。一个逻辑混乱的回答可能因为堆砌关键词而在 ROUGE 上拿高分,而一个精简准确的回答却可能得分极低。
LLM-as-a-Judge 的出现,实质上是利用 LLM 的 Inductive Bias(归纳偏置) 和指令遵循能力,为自动化评价注入了“逻辑常识”。
核心架构:如何构建一个可靠的“裁判”?
论文提出,一个基本的 LLM 裁判系统由四部分组成:输入设计 (Input)、Prompt 策略、模型筛选、后处理逻辑。
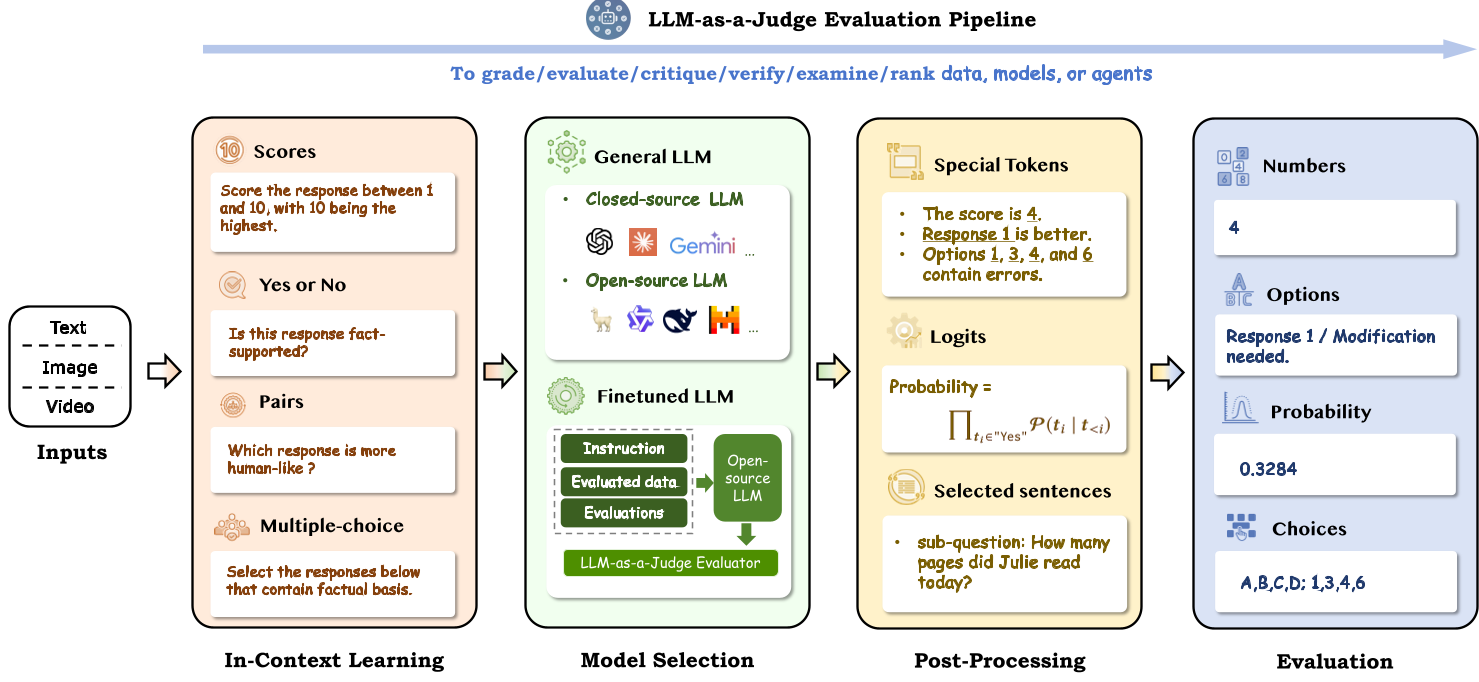
驱动裁判的三大策略:
- 评分分解 (Criteria Decomposition):不再让 LLM 盲目打 1-10 分,而是强制其从“事实性、连贯性、细节度”等多个维度分别评分。
- 两两对决 (Pairwise Comparison):相比给绝对分数,LLM 在做“A 是否比 B 好”的选择题时表现更稳定,与人类的一致性更高。
- 约束解码 (Constrained Decoding):通过强制输出 JSON 或特定 Token(如 \boxed{Yes}),降低解析错误。
实验与偏见:裁判也会“心存偏见”?
论文通过 Meta-evaluation(元评价,即评价裁判的水平)发现,LLM 裁判并不是完美的。最常见的偏见包括:
- Position Bias:LLM 倾向于给排在前面的答案或排在最后的答案更高分。
- Verbosity Bias:LLM 像某些评委一样,容易被更长的回复迷惑,认为“写得长就是写得好”。
- Self-Enhancement Bias:模型会有意无意地偏向自己生成的风格。
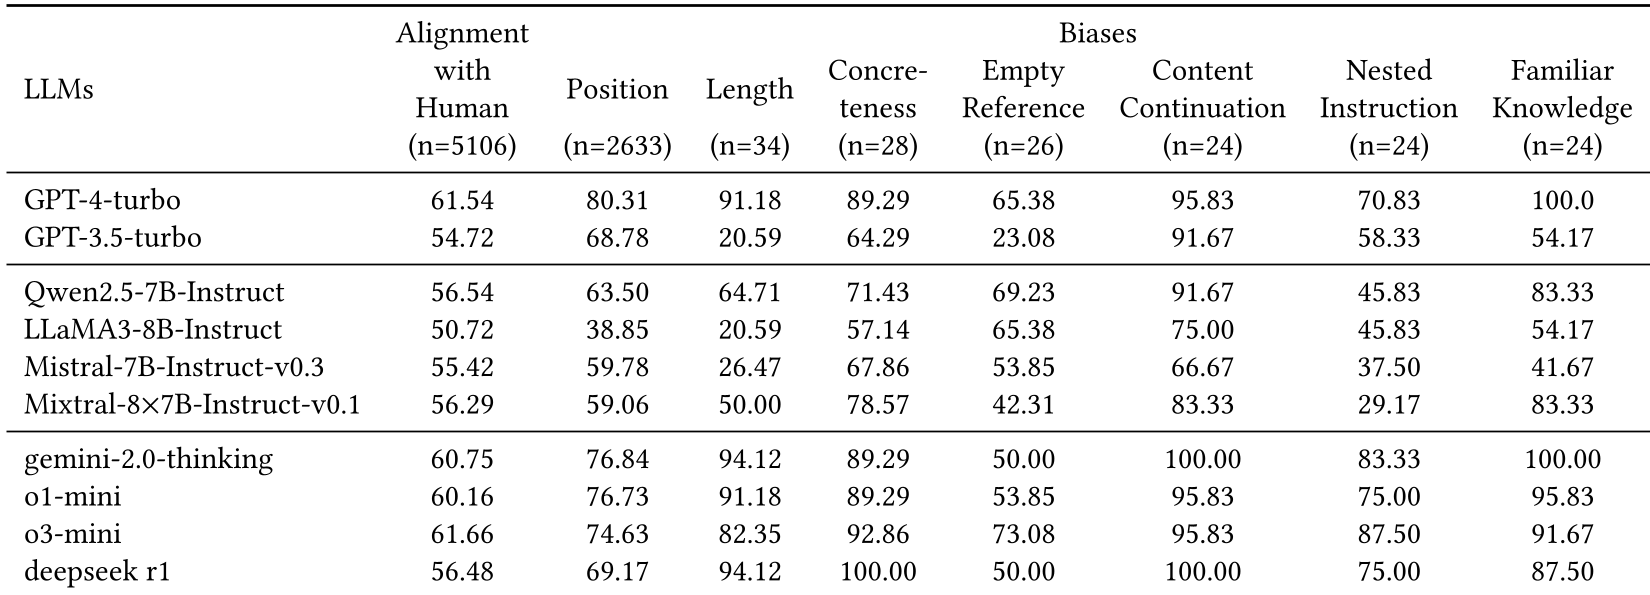 上图显示:通过 Majority Voting(多数投票)可以显著抵消随机性带来的偏见,尤其是在位置偏见方面。
深度洞察:从“评价者”到“思考者”
本工作的突破性意义在于揭示了 Judgment(判断) 与 Reasoning(推理) 的共生关系。
- 在 o1 模型 等现代推理架构中,LLM-as-a-Judge 不仅仅在最后评分,而是在推理的每一步(State Transition)都充当“检查点”。
- 这种 Reasoning-Centric Judgment(以推理为中心的判断)允许模型通过自我反馈纠偏,这就是 OpenAI o1 和 DeepSeek R1 能够进行长时思考的技术根源。
局限与展望
尽管 LLM 裁判极大提升了效率,但其 Robustness(鲁棒性) 依然脆弱。论文指出,一些无关痛痒的词(如在开头加上“Thought process:”)就能让评委给出虚高分数。未来,如何构建防御对抗性攻击的评价模型,并将该范式推向 MLLM-as-a-Judge(视频/多模态裁判),将是学术界与工业界的下一个角逐场。
总结
LLM-as-a-Judge 是 AI 闭环体系中的关键一环。它让“AI 训练 AI,AI 评价 AI”成为可能。对于开发者而言,选择性能更强的模型(如 GPT-4 或专门微调的评价模型)并结合 majority@5 的后处理策略,是目前在生产环境中使用 LLM 裁判的最靠谱路径。