
深度解析:信息检索架构的演进与 LLM 时代的新范式
A Survey of Model Architectures in Information Retrieval
本文系统性地综述了信息检索(IR)模型架构的演进,复盘了从传统布尔/向量空间模型到 Transformer 和大语言模型(LLM)驱动的深度神经检索技术的转变,强调了骨干网络(Backbone)与相关性估计机制的创新。
在信息爆炸的今天,信息检索 (IR) 已不再仅仅是搜索引擎的代名词。随着大语言模型 (LLM) 的崛起,IR 成为了 RAG (检索增强生成) 架构的基石。最近,来自犹他大学、滑铁卢大学等机构的研究者发布了一篇深度综述,从底层架构视角梳理了 IR 过去几十年的变迁。
1. TL;DR:IR 的三次进化
- 1.0 时代(统计驱动):基于词频匹配,如 BM25 和布尔模型,其特点是简单高效,但饱受“词汇不匹配”之苦。
- 2.0 时代(神经表征):利用 BERT 等 Transformer 模型,将查询与文档映射到稠密向量空间,实现了语义维度的匹配(Dense Retrieval)。
- 3.0 时代(LLM 与生成式):利用超大规模预训练模型作为骨干网络,甚至直接生成文档 ID(Generative Retrieval),搜索系统正变得越来越像一个“会思考”的代理。
2. 核心架构之争:双编码器 vs. 交互式模型
在神经检索领域,设计者始终在 精度 (Effectiveness) 与 效率 (Efficiency) 之间做平衡。
A. 表示型模型 (Representation-based)
这种架构通常被称为“双塔 (Two-tower)”或 Bi-encoder。
- 原理:查询和文档分别通过编码器映射为定长向量,检索时计算余弦相似度。
- 优点:文档向量可以预先索引,支持毫秒级的向量检索(ANN)。
- 局限:由于查询和文档在计算相似度前没有深度交互,可能会丢失细粒度的语义匹配。
B. 交互型模型 (Interaction-based)
即 Cross-encoder 架构。
- 原理:将查询和文档拼接后一起输入模型(如 BERT),让每个 Token 之间通过 Attention 机制进行全交互。
- 现状:精度极高,常用作 Reranker (重排序阶段),但无法预计算,推理成本巨大。
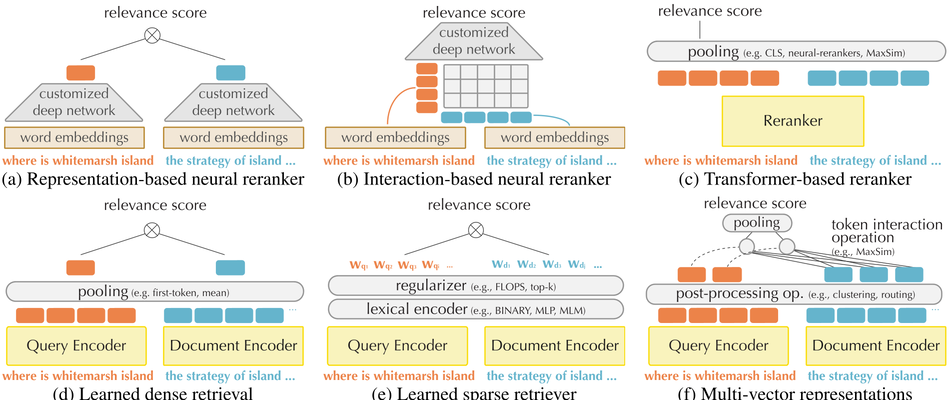 上图展示了从低成本的双塔架构到高精度的重排序架构的演变。
3. 突破瓶颈:多向量与延迟交互 (Late Interaction)
为了解决双塔模型的信息损失,ColBERT 系列提出了一种迷人的中间路线:延迟交互。 它不将整个文档压缩成一个平面向量,而是保留文档中每个词的特征向量。在匹配阶段,利用 MaxSim 算子计算最大的相似度总和。这种方法既保留了离线索引的能力,又实现了接近 Cross-encoder 的细粒度匹配。
4. LLM 对检索系统的重构
LLM 的出现不仅提升了特征提取的上限,还催生了全新的检索范式:
- 生成式检索 (Generative Retrieval):不再使用向量检索索引,而是训练模型直接“背下”文档 ID。输入问题,模型直接输出相关文档的 ID。
- 列表重排序 (Listwise Reranking):利用 LLM 的长上下文能力,一次性给出一组文档,让 LLM 直接输出最优排序列表,这模拟了人类阅读理解的过程。
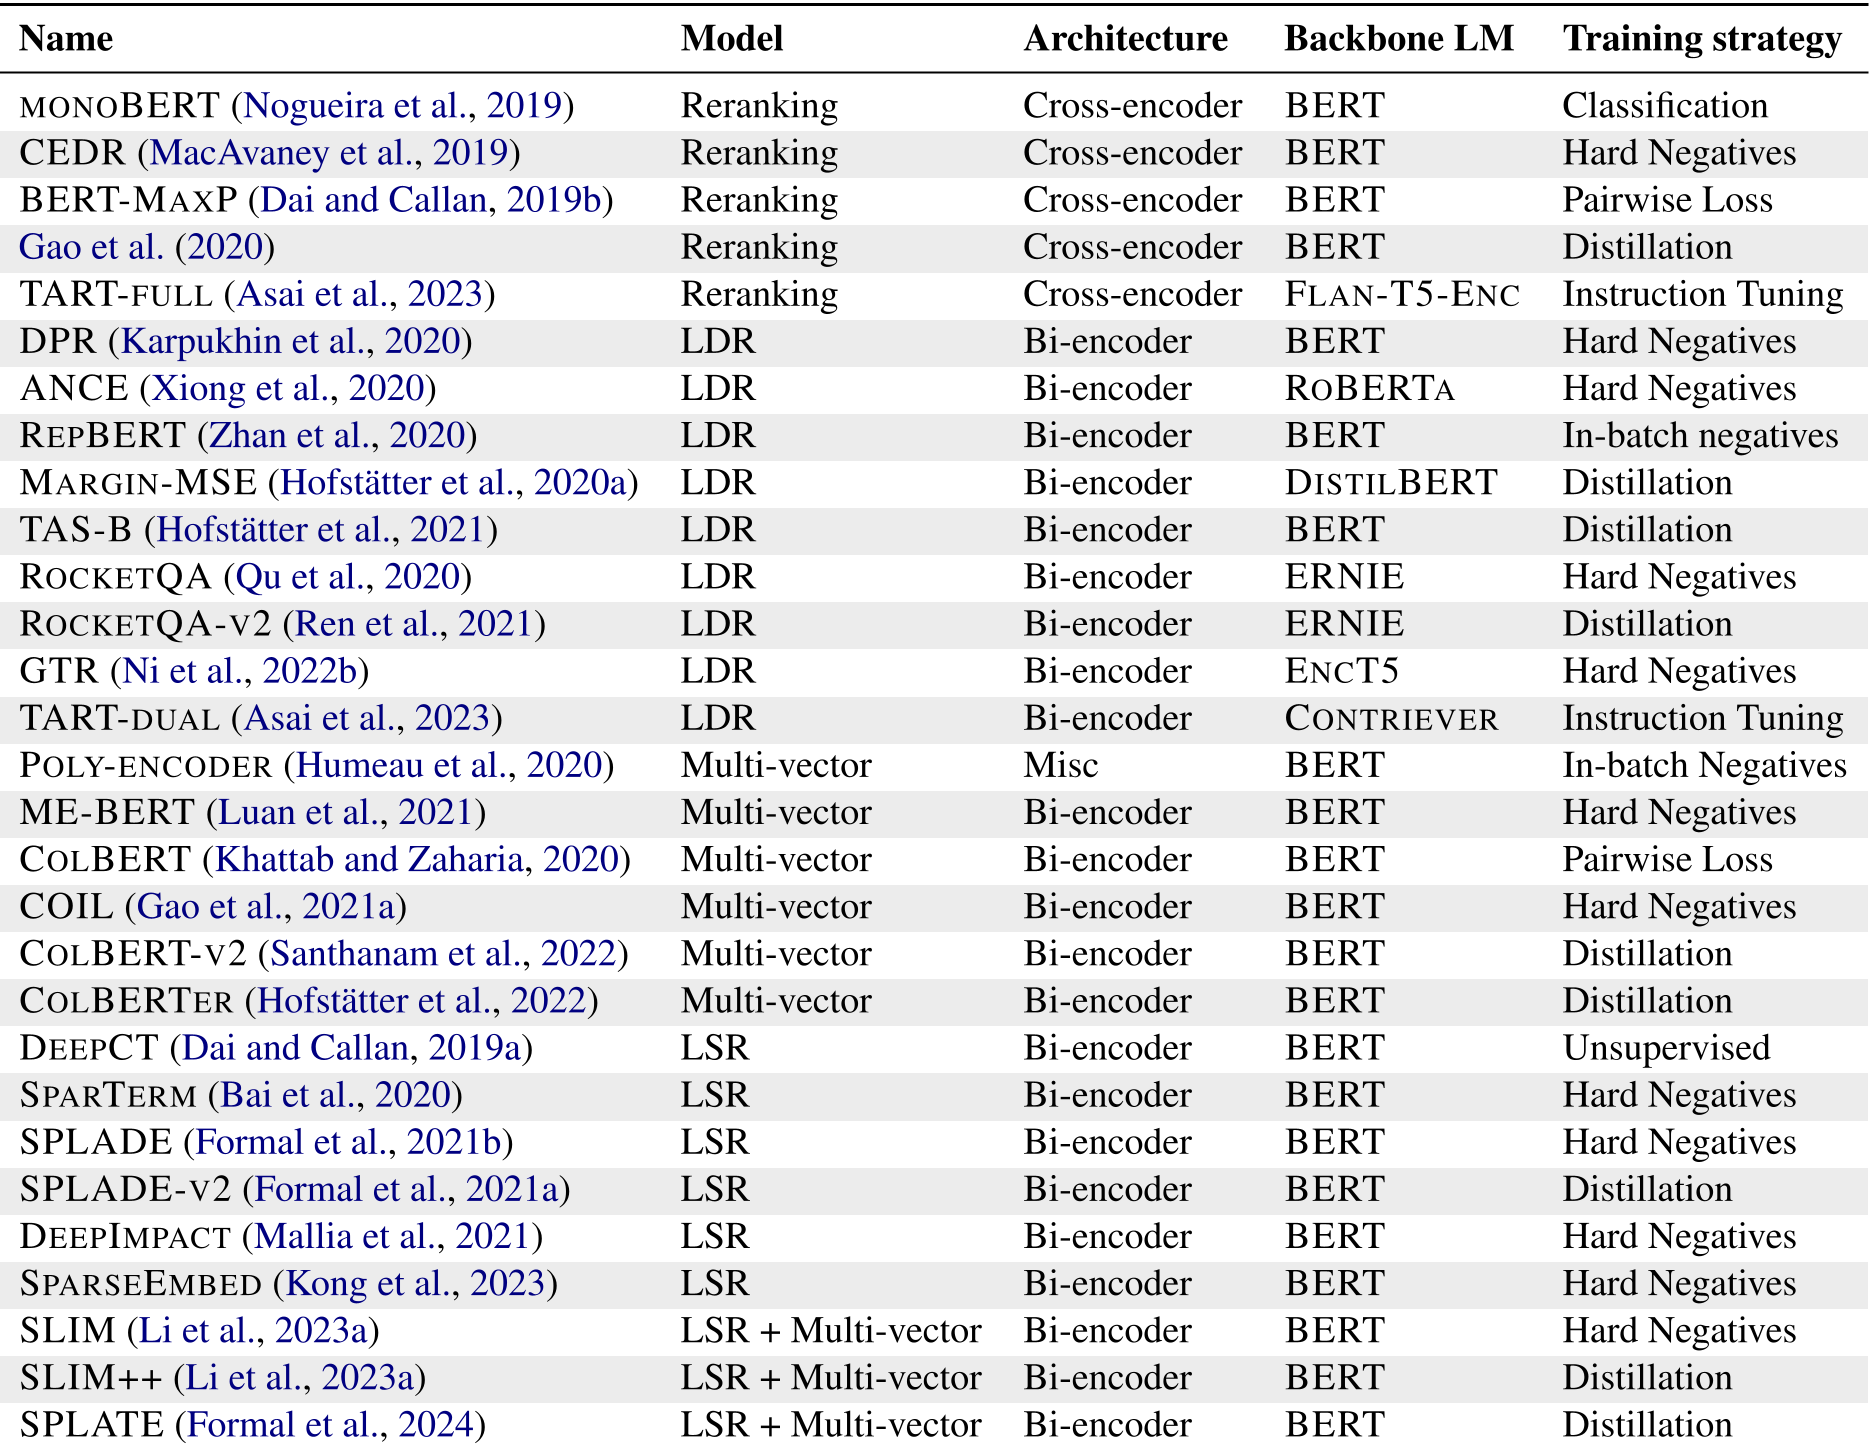 表 3 汇总了主流神经检索模型的骨干网络与训练策略,可见 BERT 仍是主力,但 LLM 渗透率正迅速提升。
5. 未来趋势:谁是下一个 SOTA?
作者在文末提出了四个值得关注的方向:
- Transformer 的挑战者:随着长文本需求增加,线性 RNN (如 RWKV) 或状态空间模型 (SSM, 如 Mamba) 是否能打破 Transformer 的复杂度桎梏?
- 作为“用户”的 AI 模型:以前检索是为了给人看,现在的重排序目标可能是为了让下游的 LLM 生成更准确。
- 自进化代理 (Agentic IR):检索系统不再是被动的工具,而是一个能自动拆解复杂问题、反复重写查询并整合结果的智能代理。
6. 总结
信息检索的本质正在经历从“文本匹配”到“知识理解”的蜕变。对于开发者而言,理解不同架构在 RAG 链路中的位置比单纯追求 SOTA 更为重要。你是需要极致响应的双塔模型,还是追求精准的延迟交互?答案取决于你的算力底牌。
参考文献:
- arXiv:2502.14822v1, A Survey of Model Architectures in Information Retrieval.