
[综述] 揭秘 OCR 技术演进:从机械阅读器到深度学习的数字化之路
A survey on optical character recognition system
本文是一篇关于光学字符识别 (OCR) 系统的全面综述。文章系统性地梳理了从图像获取、预处理、字符分割到特征提取、分类及后处理的完整技术流水线,并总结了 OCR 在银行支票识别、车牌识别及视障辅助等领域的应用现状。
TL;DR
光学字符识别 (OCR) 是将文档图像转化为机器可理解文本的关键技术。本文全面剖析了 OCR 系统的六大核心阶段,探讨了从手写识别到机器打印文本处理的技术难点,并前瞻性地指出复杂语言及非受限环境下的识别仍是当前学术界的“硬骨头”。
背景定位
在 AI 领域,OCR 是计算机视觉与自然语言处理的交汇点。本文作为一篇综述,在学术坐标系中扮演了“知识地图”的角色,它不只是简单罗列算法,而是构建了一个完整的系统论模型,帮助研究者理解 OCR 如何从简单的模式匹配进化为复杂的统计决策系统。
核心痛点:为什么机器还不如人类“识字”?
尽管我们每天都在使用 OCR(如扫码付款、文档扫描),但该领域仍面临三大挑战:
- 多样性瓶颈:字体、字号、倾斜度及书写风格的无限组合。
- 分割难题:在手写体中,字符往往互相重叠或粘连(Cursive Script),传统的“切割”方法极易失效。
- 语义缺失:早期 OCR 仅靠视觉特征,缺乏对语言逻辑的理解,导致如 "rn" 被识别为 "m" 的低级错误。
OCR 系统架构详解 (Methodology)
一个现代 OCR 系统并非原子过程,而是由以下精密的流水线组成:
1. 预处理 (Preprocessing):打好地基
预处理的直觉在于“去伪存真”。通过二值化 (Binarization) 将图像简化为黑白两色,利用形态学操作(膨胀与腐蚀)去除噪点。关键步骤是倾斜校正 (Skew Correction),利用 Hough 变换检测基线,确保字符横平竖直。
2. 字符分割 (Segmentation):分而治之
这是系统中最脆弱的一环。对于简单文档,可采用投影特征(Projection Profiles);对于复杂情况,则需采用隐式分割,即在分类过程中动态确定边界。
3. 特征提取与分类 (Feature Extraction & Classification)
这是机器的“眼睛”。作者对比了两种主流路径:
- 统计特征:利用图像矩(Moments)捕捉形状分布,具有旋转不变性。
- 结构特征:识别闭环、端点和笔画交叉等几何属性。
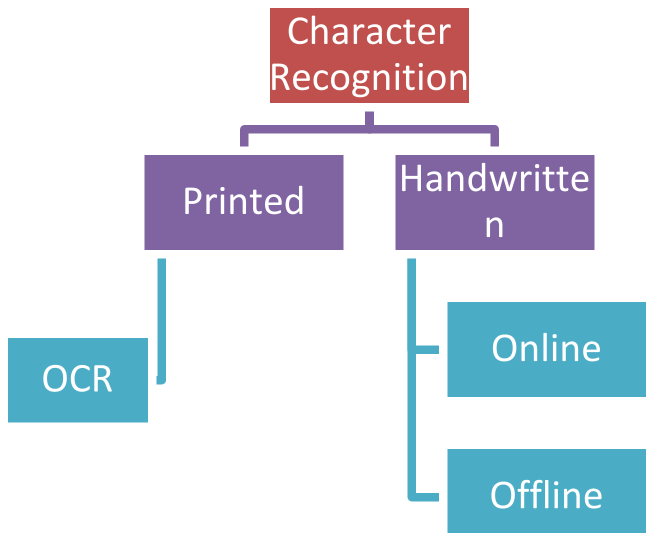 图 1:OCR 系统的详细分类:从输入模式到识别维度的全景展现
实验洞察:从概率到语境
文章强调,分类后的后处理 (Post-processing) 是提升准确率的神来之笔。通过引入 N-gram 模型或拼写检查词典,系统可以利用上下文进行纠错。例如,如果识别出的单词是 "acc0unt",后处理模块会基于词典将其修正为 "account"。
下表总结了 OCR 各阶段的核心方法:
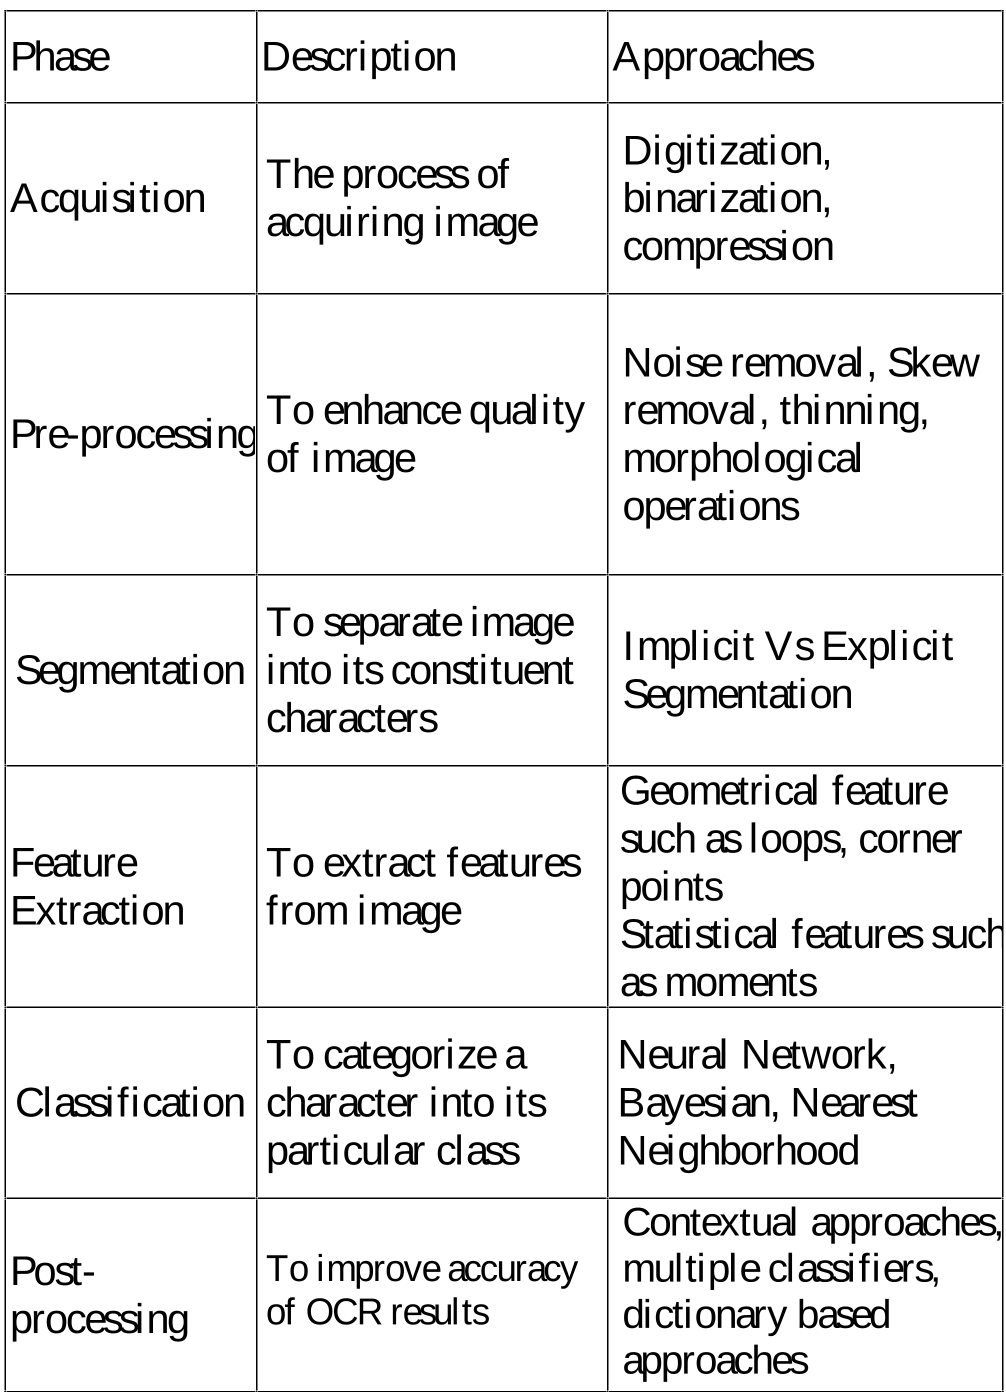 表 1:从获取到后处理的技术栈概览
深度洞察与总结
关键贡献 (Takeaway)
OCR 的真正价值在于它打通了物理世界与数字世界的桥梁。本文明确了多分类器集成 (Classifier Committees) 和上下文感知是达到人类级别识别精度的必经之路。
局限性与未来展望
- 低资源语言的鸿沟:对于乌尔都语(Urdu)或信德语(Sindhi)等复杂语言,现有的开源工具几乎为空白。
- 端到端趋势:虽然本文强调了分阶段处理,但随着深度学习的发展,直接从图像预测序列的 End-to-End 架构(如 CRNN, Transformer)正逐渐取代繁琐的预处理和分割步骤。
结论:OCR 远未“被解决”。虽然在标准化文档上已近完美,但在自然场景(Scene Text)和艺术书法面前,我们仍需更强大的归纳偏置 (Inductive Bias) 和海量数据的支撑。