
走出学术诚信的“军备竞赛”:LLM 时代的剽窃检测全景综述
SURVEY ON PLAGIARISM DETECTION IN LARGE LANGUAGE MODELS: THE IMPACT OF CHATGPT AND GEMINI ON ACADEMIC INTEGRITY
本文是一篇关于大语言模型(LLM)背景下学术剽窃检测的综述研究。文章系统分析了 ChatGPT 和 Gemini 等模型对学术诚信的影响,评估了现有的 AIGC 检测算法(如 DetectGPT, Ghostbuster)和工具,并探讨了通过提示词工程、同义词替换等手段规避检测的策略。
TL;DR
随着 ChatGPT 和 Gemini 的普及,传统的剽窃检测手段正面临降维打击。本文深入探讨了 LLM 如何改变学术舞弊的形态,详尽对比了当前主流的 AIGC 检测技术(水印、零样本、分类器),并揭示了一个残酷的现实:通过简单的“生成+改写”组合,现有的技术防线几乎全线崩溃。
背景定位
本文是一篇及时的学术综述,它不仅在技术坐标系中定位了各种 AIGC 检测器的效能,更跳出技术圈层,反思了教育评估模式在 AI 时代的必然转型。
痛点深挖:为何 AI 剽窃如此难防?
在预训练模型时代之前,剽窃主要表现为“复制粘贴”。但 LLM 时代催生了 AI-generated plagiarism。
- 低度重合:AI 生成的文本在统计学上是“原创”的,查重软件找不到来源。
- 语义模拟:LLM 能够模拟人类的语法错误和个人经验,使机器痕迹被掩盖。
- 规避生态链:学生不再只用 ChatGPT,而是形成“提示词工程 -> AI 生成 -> 改写工具消痕”的完整链条。
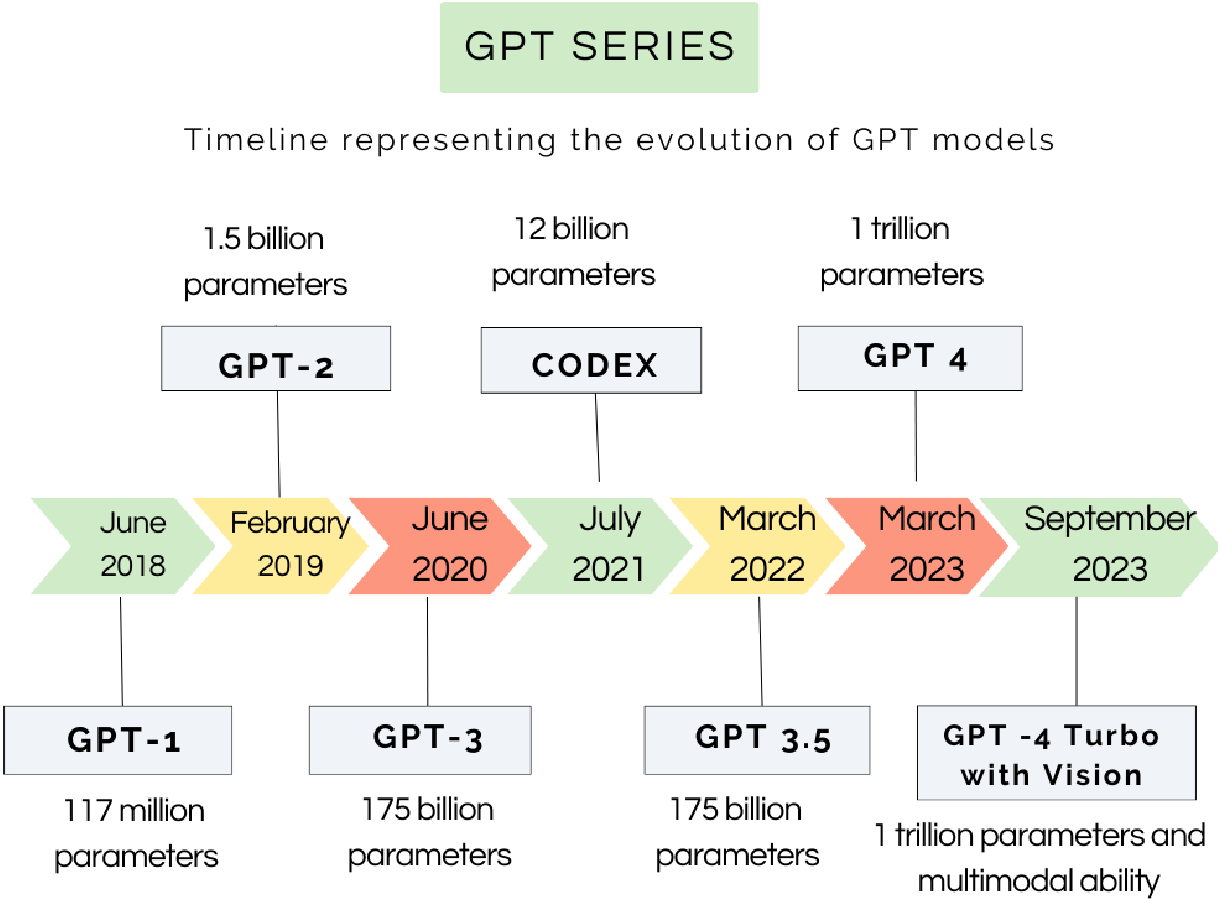 上图展示了从 GPT-1 到 GPT-4 的指数级增长,参数量的提升直接导致了生成文本的“拟人性”质变。
方法论详解:三道防线及其软肋
1. 水印技术 (Watermarking-based)
- 原理:在生成时的 Token 概率分布中嵌入特定的伪随机签名(Green List)。
- 局限:对“黑盒”模型无效,且极易被翻译攻击或简单的同义词替换(Lexical Substitution)抹除。
2. 零样本检测 (Zero-shot Detection)
- 核心直觉:人类写作具有很高的 Perplexity (困惑度),而 AI 倾向于停留在负曲率区域。
- 代表作:DetectGPT 利用对文本施加细微扰动后的对数概率变化来判断“机器属性”。
- 现状:Fast-DetectGPT 提速 340 倍,但在面对改写后的文本时,检测力断崖式下降。
3. 训练分类器 (Classifiers)
- 方法:使用 RoBERTa 等模型作为 Backbones,在“人写体 vs 机器体”的大规模数据集上进行监督学习。
- 软肋:严重依赖数据集质量。一旦模型遇到未见过的新版 LLM,表现就会急剧退化。
实验与结果:脆弱的技术防线
作者展示了一个令人不安的实验:一篇关于量子计算的文章,在经过“ChatGPT 生成 + QuillBot 改写”后,Turnitin 和 GPTZero 的识别率均降为 0%,被判定为 100% 原创。
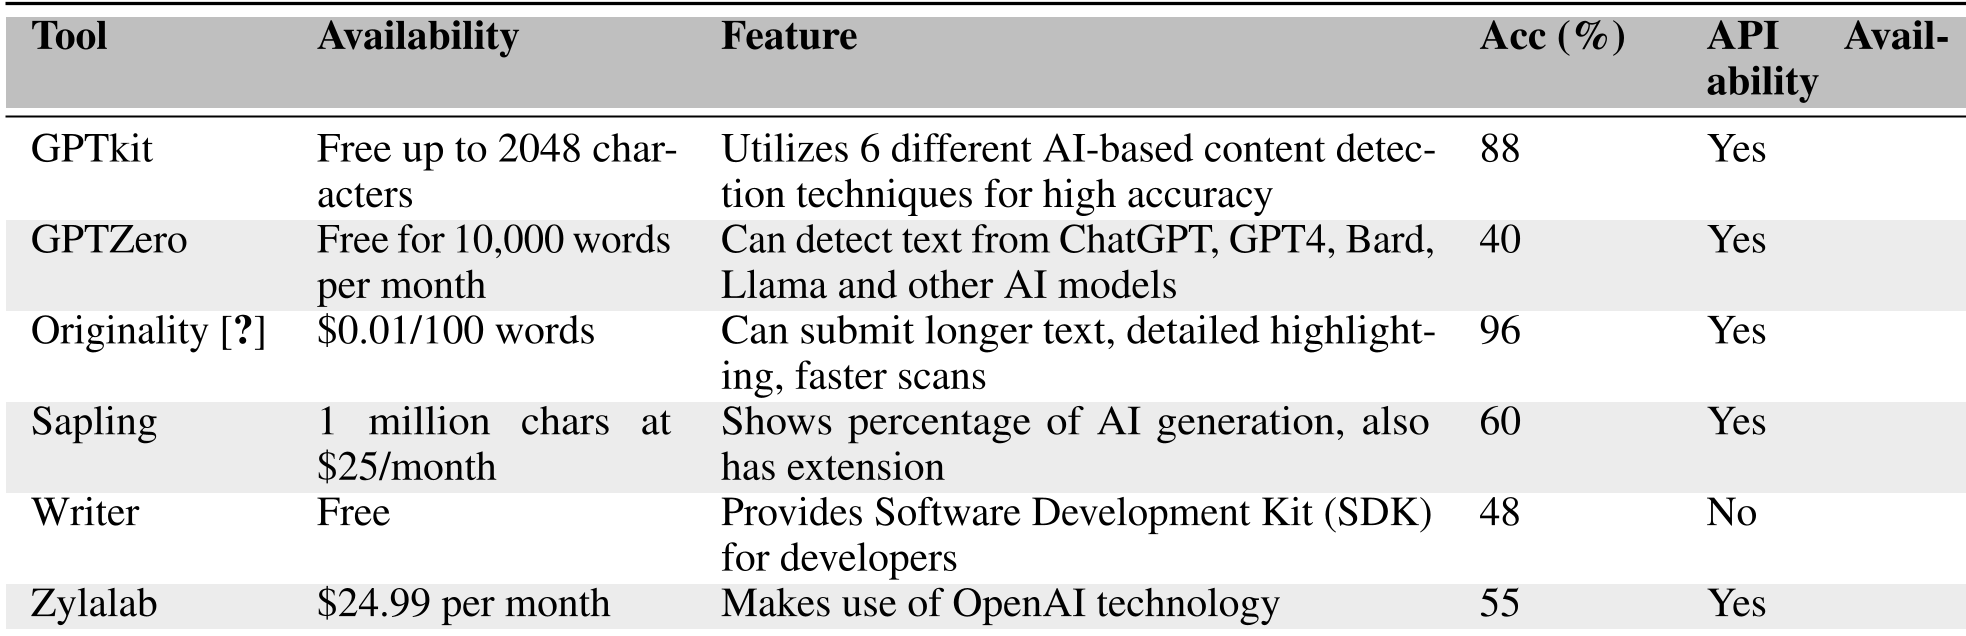 如表所示,尽管 Originality.ai 等商业工具声称高准确率,但在真实学术环境(包含用户微调和改写)中,其鲁棒性仍有巨大提升空间。
深度洞察:技术不是唯一的解药
本文最深刻的洞见在于:AIGC 检测是一场永远无法终结的技术战争。 当新的检测模型发布,更强大的对抗生成技术也会随之而来。
未来的教育出口:
- 考核重构:从考察“结果(作文/作业)”转向考察“过程(课堂答辩/手稿迭代)”。
- AI 协同而非禁止:制定 AI 使用的阈值和引用规范,训练学生如何“伦理地”使用 AI 辅助研究,而非单纯禁止。
- 可解释性检测:未来的 AI 检测器不应只给出一个概率数字,而应利用 SHAP 等归因方法指出文本中具体的“机器疑点”。
总结
这篇综述提醒我们,面对 LLM 的洪流,与其筑起日益脆弱的技术堤坝,不如重新审视学术评价的本质。当 AI 能够完美完成作业时,也许该改变的不是检测工具,而是作业本身。