
[arXiv 2024] SynCode:利用语法增强突破 LLM 结构化生成的幻觉瓶颈
SynCode: LLM Generation with Grammar Augmentation
本文提出了 SynCode,一种通过语法引导(Grammar-guided)来增强大语言模型(LLM)生成准确性的框架。该方法利用离线构建的 DFA Mask Store 结合在线增量解析,确保 LLM 生成的内容严格遵循上下文无关语法(CFG),如 JSON、SQL 及 Python/Go 等编程语言。
1. 核心速览 (Executive Summary)
TL;DR:大语言模型在生成代码(Python, Go)或结构化数据(JSON, SQL)时,即便微调后仍难以避免语法错误导致的解析失败。SynCode 引入了一种基于形式语言理论的硬约束机制,通过离线构建的 DFA 掩码库和在线增量解析,强制模型在每一步解码中仅能选择符合语法规范的 Token,从而在不损害模型能力的前提下,几乎消除了生成的语法“幻觉”。
背景定位:该工作是 SOTA 级的语法引导生成(Constrained Decoding) 方案,解决了词表对齐(Token Misalignment)和大规模语法处理效率两大工程难题。
2. 痛点与动机 (Problem & Motivation)
尽管 GPT-4 或 Llama 3 表现强劲,但在集成到复杂 AI 系统时,它们生成的 JSON 常常缺少括号,或生成的代码存在低级语法错误。现有约束方法存在以下致命缺陷:
- 高性能与精密性的权衡:如 llama.cpp 的局部约束方案在处理 Python 这种大型语法时效率极低。
- 词表不一致性 (Token Misalignment):LLM 的分词(如
def可能分裂成两个词)与编程语言的词法单元(Lexical Terminals)不对应,导致简单的正则表达式约束失效。 - 缺乏通用性:许多方法绑定了特定的解码算法(如只能 Beam Search),无法原生支持温度采样或贪婪搜索。
3. 方法论详解 (Methodology)
3.1 核心架构
SynCode 的工作流程如图 1 所示,主要分为离线预处理和在线过滤两个阶段:
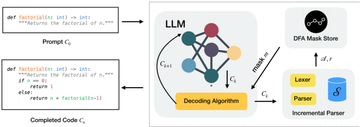
- 离线阶段(DFA Mask Store):针对目标语言(如 Python),为所有语法终结符构建 DFA,并预先计算在每个 DFA 状态下,词表中哪些 Token 是合法的。这些结果存储在二进制掩码表(Mask Store)中。
- 在线阶段(语法引导生成的两个步骤):
- 增量解析:利用 LR(1) 解析器实时处理已生成的文本,提取出当前还未结项的“残余字符串(Remainder)”和下一步可以对应的“接受序列(Accept Sequences)”。
- 掩码计算:根据解析结果,直接从 Mask Store 检索对应的二进制向量,并在 GPU 上进行快速的位运算(Union),生成当前步的词表掩码。
3.2 解决词表对齐
SynCode 巧妙地处理了 Token 与 Terminals 的错位。通过维护 Remainder(即当前正在被“拼凑”的词法单元),即使一个 Token 只是某个关键词的一半,DFA 状态转移也能准确捕捉其合法性。
4. 实验与结果 (Experiments & Results)
4.1 JSON 生成:零语法错误
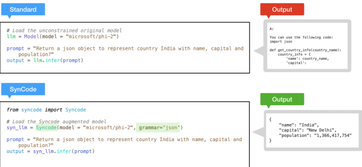
在 JSON-Mode-Eval 数据集上的测试表明,即便在提示词极具挑战性的情况下,SynCode 辅助下的模型(如 Llama-2-7B)在语法正确性上达到了 100%。
4.2 编程语言 (Python/Go) 的大规模削减
在 HumanEval 和 MBXP 数据集上,SynCode 将 Python 和 Go 的语法错误平均降低了 96.07%。剩余的微量错误通常源于模型达到了最大 Token 长度限制,而非产出了非法字符序列。
4.3 推理性能
与 Outlines 或 Guidance 等逐 Token 验证方法不同,由于 SynCode 使用了预计算的掩码表,其推理开销极低。在大规则集(如 Python 520 条规则)下,增量解析的优势愈发明显。
5. 深度洞察与总结 (Critical Analysis & Conclusion)
局限性与展望
- 语义 vs 语法:SynCode 能确保代码“能编译”,但不能确保“逻辑对”。例如,它会防止语法错位,但目前的 CFG 框架无法强制变量必须先定义后再使用(这是上下文本相关的)。
- 最大生成限制:如实验所示,如果模型逻辑陷入循环,虽然每一步都合法,但最终可能因长度截断导致不完整的程序。
总结
SynCode 为 LLM 的落地的可靠性补上了关键的一环。它不仅通过形式化的方法保证了健全性(Soundness),更通过增量算法实现了工程上的高可用性。对于需要模型输出稳定格式(如 API 调用、自动化脚本生成)的开发者来说,这是目前最完备的工具链之一。