
玛雅语词向量:图拓扑如何突破长尾数据的语义困境?
tacl-review-assignment-10639-Original+Submission+-+first+time+submission-23995 (1)
本文针对低资源语言尤卡坦玛雅语(Yucatec Maya),提出了首个基于图拓扑结构的词向量评估框架。通过引入 Node2Vec 方法克服数据稀疏与长尾分布,并在 5 名母语专家的验证下,实现了显著优于传统 distributional 模型的语义捕捉性能。
TL;DR
在现代 NLP 领域,词向量通常依赖海量文本。但对于仅有数十万 token 的尤卡坦玛雅语(Yucatec Maya),传统方法(Word2Vec, FastText)均告失败。本文提出通过 Node2Vec 图拓扑学习 代替传统的滑动窗口,成功捕获了被掩埋在长尾分布中的语义关联,其表现远超基线模型,并获得了母语专家的严格验证。
背景定位:低资源语言的“数字遗失”
在 90% 的世界语言处于“数字代表性不足”的现状下,尤卡坦玛雅语面临着双重挑战:数据极其稀疏(Type-Token Ratio 仅 0.085)且形态高度复杂。传统的分布式表示(Distributional Hypothesis)在面对“单次词”(Hapax Legomena)时,往往会因为上下文信息不足而产生毫无意义的向量空间碎片。
核心痛点:为什么 SOTA 模型在玛雅语上“翻车”了?
- 维度坍塌 (Dimensional Collapse):Word2Vec 需要高频共现来估计稳定的向量。在小语料库中,随着维度增加,模型因参数过载而失效。
- 形态噪声 (Morphological Noise):FastText 曾是处理形态丰富语言的利器,但在玛雅语中,固定长度的字符 n-gram 却意外捕获了大量无关的词缀干扰,导致相关性指标转负(ρ ≈ -0.080)。
- 盎格鲁中心主义偏见 (Anglocentric Bias):以往的评估常将英文数据集(如 MC-30)强行翻译。本文通过 Human-in-the-loop 流程,构建了首个由玛雅语母语专家审定的语义黄金标准。
方法论详解:从“窗口计数”到“拓扑游走”
作者不再将每个滑动窗口视为独立的训练实例,而是将整个语料库编织成一张全局共现加权图 。
1. 全局图构建
通过等式 (1) 累加所有句子中的共现关系: 这一步保证了即使是低频词,也能通过与其相邻的高频核心词建立连接。
2. Node2Vec 的随机游走
不同于 Word2Vec 局限于 的物理距离,Node2Vec 利用**随机游走(Random Walks)**在图中探索“朋友的朋友”。这种机制实际上起到了一种“语义桥梁”的作用,即使两个词从未在同一句中同时出现,只要它们在图拓扑中拥有相似的邻域,就能获得相近的向量。
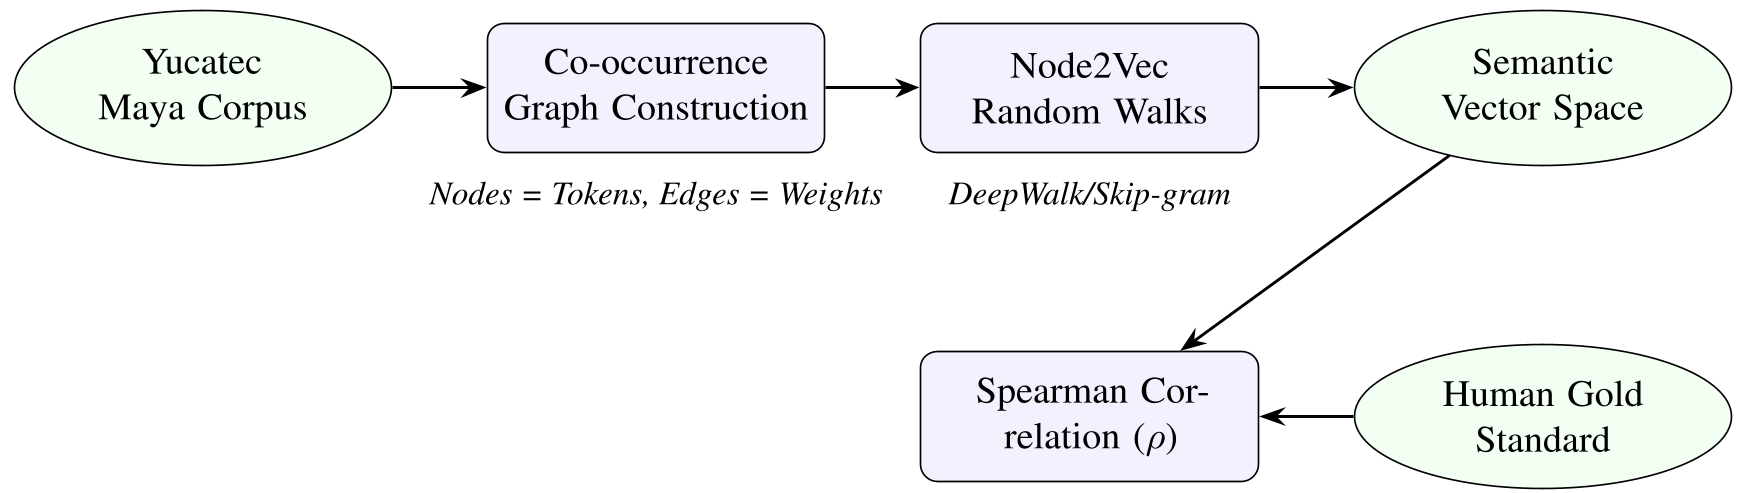 图 1:从语料构建到专家验证的 Human-in-the-loop 全流程
实验与结果:图理论的压制性优势
实验结果非常震撼(见下图 3 和表 5):
- Node2Vec (300d):达到了 ρ = 0.567,在高共识词对(High Consensus)上更是飙升至 0.807。
- Word2Vec:在 100d 以后相关性迅速下降,最终失去显著性(p > 0.05)。
- FastText:表现最差,其 n-gram 机制在小样本环境下完全失效。
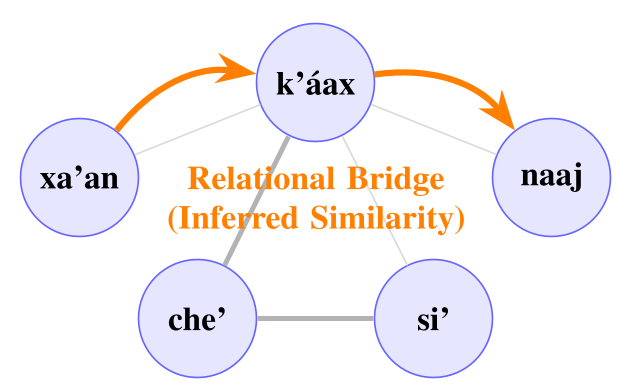 图 4:左侧分布式模型因信号弱而导致空间破碎;右侧图方法通过全局拓扑实现了语义聚合。
深度洞察:为什么这种方法有效?
从物理直觉上看,Node2Vec 强制模型去关注“结构等价性”。在玛雅语中,一个词根可能产生几十种词缀变化,Word2Vec 把它们看作相互独立的实体。而 Node2Vec 通过在图中“散步”,将这些分散的节点重新汇聚。
局限性与挑战
- 计算开销:图的构建和随机游走生成比单纯扫描文本要昂贵得多。
- 语料偏差:目前语料仍以新闻(Jornada Maya)为主,对口语和方言的捕捉尚有欠缺。
总结与启示
这项研究不仅是玛雅语数字振兴(Digital Revitalization)的里程碑,更为所有低资源语言处理提供了一个重要启示:在数据不足时,不要盲目追求模型规模,而应利用图结构的先验知识来补足统计信号的缺失。 只有尊重语言自身的形态逻辑,并结合专家直觉,才能在 NLP 的世界坐标系中实现真正的语言平等。