
Thinking with Visual Primitives:让 AI 像人一样“指着图”进行思考
Thinking with Visual Primitives
DeepSeek-AI 提出了 Thinking with Visual Primitives (基于视觉原语的思考) 框架,旨在解决多模态大模型 (MLLM) 中的“指代鸿沟”问题。通过将坐标点 (Points) 和边界框 (Bounding Boxes) 作为“最小思考单元”交织进推理链,该模型在空间推理、复杂计数和拓扑导航(如迷宫和路径追踪)中达到了媲美 GPT-5.4、Claude-Sonnet-4.6 和 Gemini-3-Flash 的 SOTA 水平。
TL;DR
DeepSeek-AI 发布的这篇论文标志着多模态推理从“感知时代”向“认知指代时代”的跨越。通过引入 Visual Primitives (视觉原语) —— 即点(Points)和框(Boxes),模型不再仅仅用文字喃喃自语,而是在推理过程中实时在图像上“打点”和“画框”。这种“边指边想”的模式极大地解决了模型在复杂空间任务中的幻觉问题,在迷宫导航、密集计数等任务中全面超越了 GPT-5.4 和 Claude-4.6。
痛点深挖:为什么“看清”不代表“想通”?
在多模态领域,业界长期存在一个误区:只要分辨率够高、Patch 分得够细,模型性能就会变强。这被称为解决“感知鸿沟 (Perception Gap)”。
然而,作者指出更核心的问题是 “指代鸿沟 (Reference Gap)”。
- 语言的局限性:当你试图用文字描述迷宫中上百个转折点,或者计数几十个重叠的物体时,纯文字推理链(CoT)会迅速丢失空间感。
- 逻辑崩溃:由于语言无法精准对应连续的视觉坐标,模型在推理的第 N 步往往已经不知道第 1 步提到的“左边那个红色的球”具体在哪了,从而导致连锁的逻辑错误。
核心方法:将视觉标记作为“最小思考单元”
不同于以往将坐标作为最终输出(Post-hoc)的方法,本项目将坐标点和框**交织(Interleave)**进 Reasoning Trace 中。
1. 架构:极致的视觉压缩
DeepSeek 采用了基于 Compressed Sparse Attention (CSA) 的架构。一个 756x756 的图像,最初有接近 3000 个 token,经过 3x3 空间压缩和 CSA 机制,最终进入 KV 缓存的视觉 entry 只有 81个。这种 7056 倍的惊人压缩率,证明了高效的推理不需要冗余的视觉特征,而需要精准的逻辑锚点。
2. 训练机制:从专家到全才
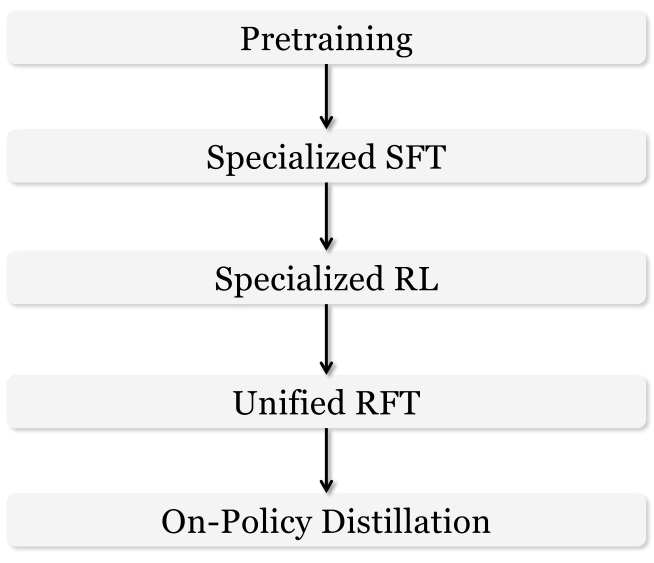
- 数据清洗 (The Rigorous Filtering):作者从 9.7 万个原始数据源中,通过语义(筛掉无意义代码)和几何(筛掉遮挡和截断)两步严格过滤,最终提炼出高质量样本。
- 强化学习 (Specialized RL):利用 GRPO 算法,不再仅仅根据最终答案给奖励,而是针对“格式、质量、准确性”三个维度定制 Reward Models。例如,在迷宫任务中,如果模型穿墙了,会被给予极大的惩罚;如果探索了更多的合法路径,则会有进度奖赏。
- 在线策略蒸馏 (OPD):先训练“识框”和“打点”两个专家模型,再通过 OPD 将两者的能力融合进一个统一模型中。
实验战绩:拓扑推理的飞跃
在传统的 VQA 任务中,该模型与 GPT-5.4 等旗鼓相当;但在真正考验“System-2”推理能力的 拓扑推理 (Topological Reasoning) 任务中,表现出了断层式领先。
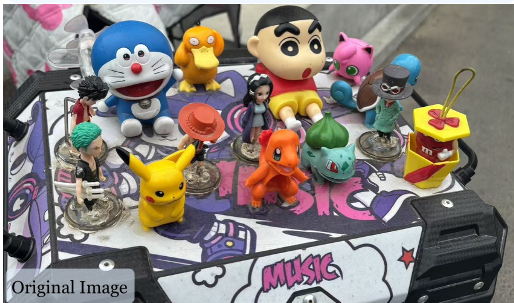
- 计数能力:通过“Batch Grounding”策略,模型可以先圈定所有可能目标,再进行统计,在 Pixmo-Count 上达到了 89.2 的高分。
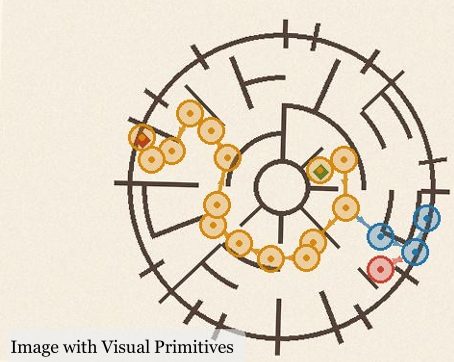
- 拓扑导航:在迷宫和路径追踪任务中,模型能够输出完整的坐标序列轨迹。在 DS_Path_Tracing 任务上,领先第二名(GPT-5.4)近 10 个百分点。
深度洞察:迈向 System-2 智能
这篇文章最启发人的地方在于:它模拟了人类处理复杂视觉问题的直觉——“指点江山”。当我们数数时,我们会用手指指着物品;当我们解迷宫时,我们会用笔尖勾勒路径。
Visual Primitives 就是 AI 的“指尖”。
局限性与未来
- 触发依赖:目前仍依赖显式的触发词(Trigger words)来激活视觉原语思考,未来模型应具备自发调用该能力的意识。
- 分辨率限制:虽然推理能力强,但在极小目标的识别(感知层面)依然受限于输入分辨率。
总结
Thinking with Visual Primitives 证明了:多模态大模型的下一步演进,不是单纯的参数增加或像素提升,而是认知与视觉坐标的深度耦合。这种让模型在“物理坐标”上进行逻辑建模的方法,为实现真正的具身智能和通用视觉推理铺平了道路。