
CUDRT:重新定义 LLM 生成文本检测的“五大作战维度”
Towards Reliable Detection of LLM-Generated Texts: A Comprehensive Evaluation Framework with CUDRT
本文提出了 CUDRT,一个针对大规模语言模型(LLM)生成文本检测的综合评估框架与中英双语基准测试。该框架将 LLM 的文本操作细化为五大类(Create, Update, Delete, Rewrite, Translate),并在 Llama 3、GPT-4 等前沿模型上进行了系统评估,旨在提升检测器在真实多语言环境下的可靠性与泛化能力。
TL;DR
随着 GPT-4 和 Llama 3 等模型的普及,区分“人写”还是“机生”已成为信息安全、版权保护领域的深水区课题。来自中国人民大学等机构的研究者提出了 CUDRT 框架,首次从 Create(生成)、Update(更新)、Delete(删除)、Rewrite(改写)、Translate(翻译) 五个维度对 LLM 行为进行解构,并建立了一个涵盖 48 万样本的中英双语基准。
核心洞察:并不是所有的 LLM 任务都一样好识别,“Delete(删除/精简)”任务中留下的机器特征最为深刻,训练此类数据最能显著提升检测器的泛化能力。
1. 现状之痛:为什么现有检测器总被“打脸”?
目前的检测技术主要分为基于度量(Metric-based)(如分析困惑度 PPL)和基于模型(Model-based)(如微调 RoBERTa)。然而,现有的 Benchmark(如经典的 HC3)大多局限于 QA(问答)场景。
作者指出,在真实应用中,LLM 更多扮演的是“协作者”角色:
- Update:帮我润色这段话 (Polish)。
- Delete:帮我总结这段长文 (Summary)。
- Rewrite:把这段话写得更专业点。
如果检测器只见过“问答题”,当面对被 LLM 稍微“动过手术”的潤色文本时,往往会彻底失灵。
2. CUDRT 核心机制:全方位的“操作员”视角
CUDRT 将 LLM 的活动抽象为 5 种核心 Operation,这种分类法更贴近人类使用 LLM 的物理直觉:
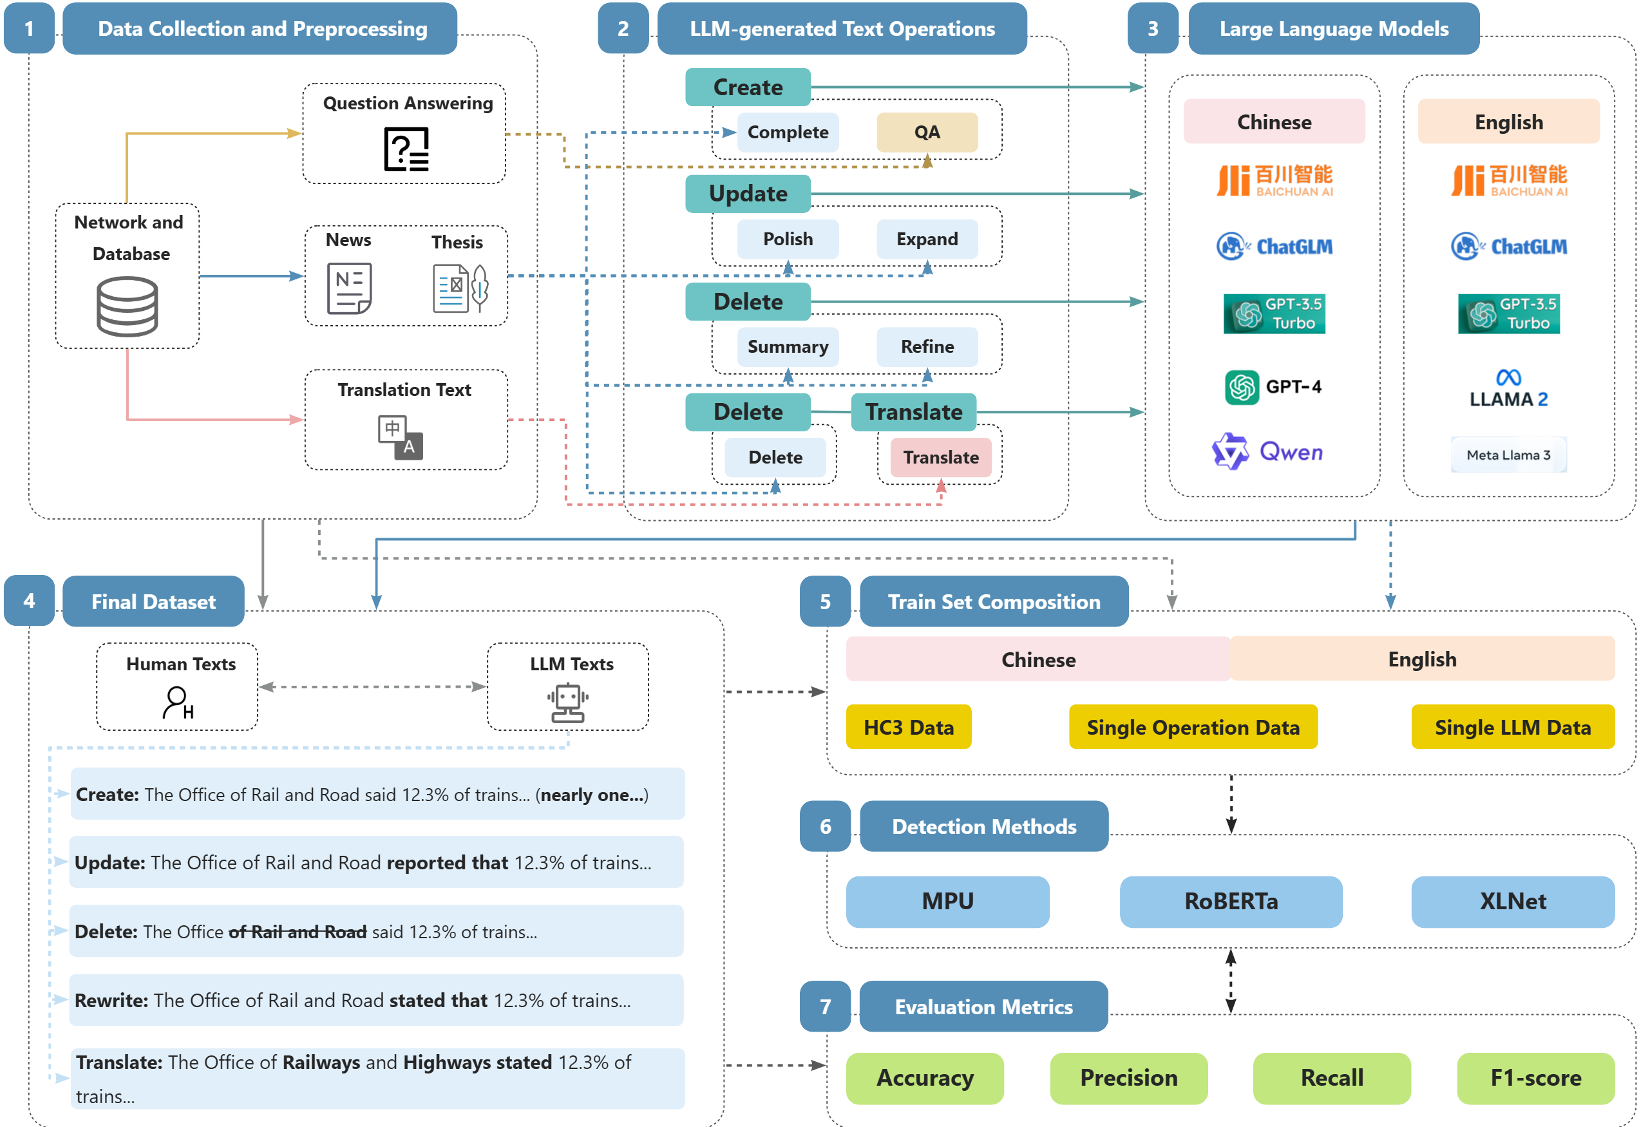
- Create (Complete/QA):从无到有,这是目前被研究最多的。
- Update (Polish/Expand):保留原意,细节微调。
- Delete (Summary/Refine):去冗余。实验证明,LLM 在精简文本时会引入独特的逻辑模式(如 PPL 分布极度集中)。
- Rewrite:深层语义重组。
- Translate:跨语言转换。
3. 实验发现:谁才是检测界的“泛化之王”?
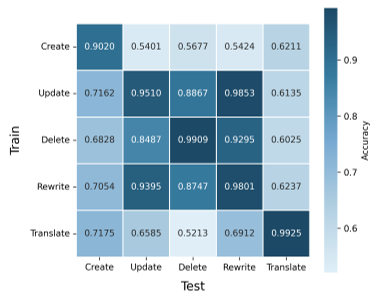
在跨操作(Cross-Operation)训练测试中,研究人员发现了一个非常有趣的现象:
- “Delete” 数据的奇效:如果你的训练预算有限,只能选一种数据练手,选“Delete(删除)”。如热力图所示,在 English 场景下,基于 Delete 训练的 RoBERTa 在所有测试任务上几乎都达到了 0.98 以上的准确率。作者推测,这是因为 LLM 在做精简时会对文本结构进行“大手术”,留下的统计特征比简单的 QA 问答要深刻得多。
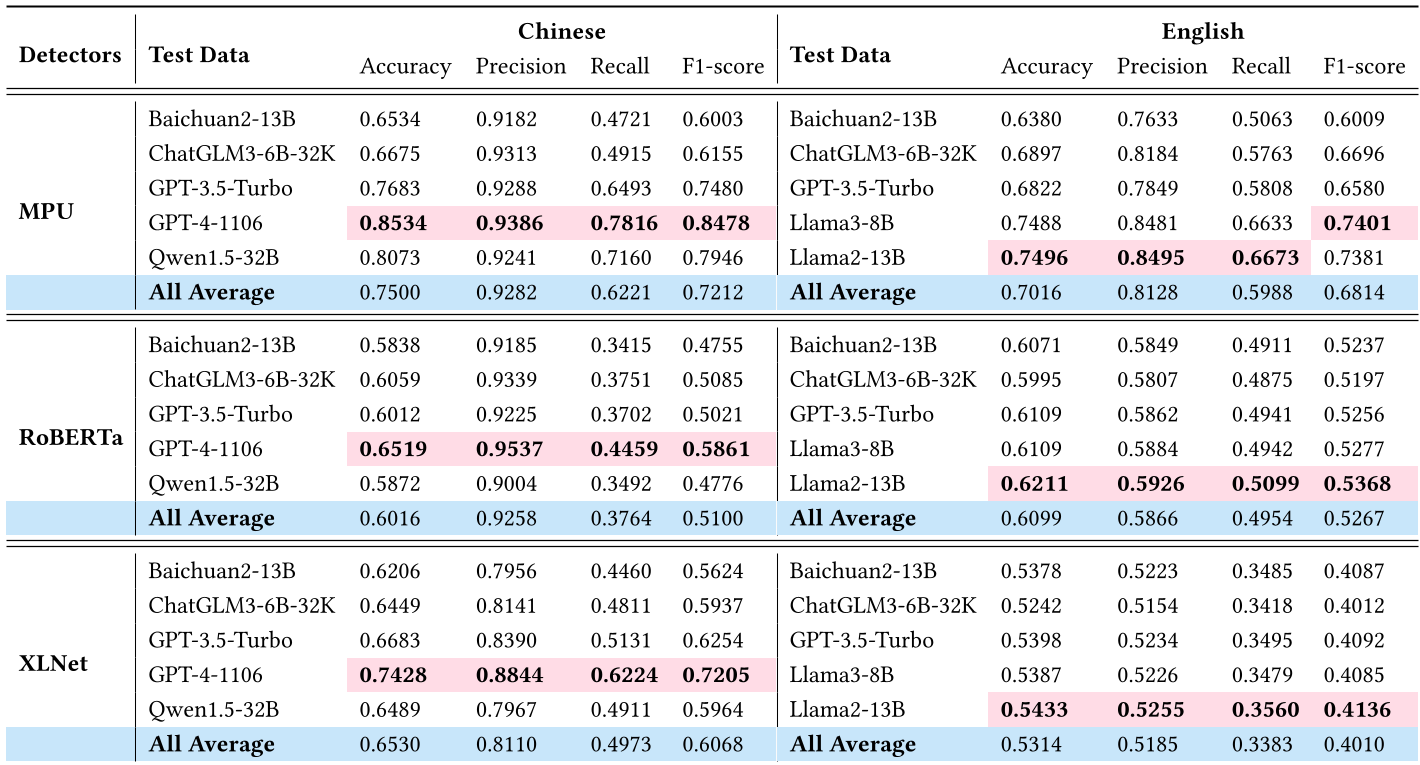
- 中英文难度差异:实验显示,中文生成的识别难度普遍高于英文。尤其是针对国产模型(如 Baichuan2, ChatGLM3),现有的主流检测器(如在 HC3 上练出来的版本)准确率大幅下滑,表明不同语言背景训练出的 LLM 存在显著的“生成指纹”差异。
4. 深度洞察:给开发者的三条建议
- 别只盯着 GPT 练模型:跨模型(Cross-LLM)实验显示,用 GPT-4 和 Qwen1.5 训练出来的检测器泛化性最好,因为它们生成的文本最具“代表性”。
- 关注短文本降级:在 Translate 和 Delete 操作中,文本通常较短,此时模型检测能力会显著下降。
- 多语言适配迫在眉睫:现有的检测器多表现出“英语强、中文弱”的偏向,针对特定母语环境下 LLM 的生成逻辑进行建模是未来的核心增长点。
总结
CUDRT 不仅仅是一个数据集,它通过 Operation-based classification 揭示了 LLM 生成文本检测的本质——我们检测的不是“一段话”,而是“一种处理逻辑”。在对抗日益剧烈的生成环境中,CUDRT 为构建下一代鲁棒性检测系统提供了科学的指引。
本博客基于论文《Towards Reliable Detection of LLM-Generated Texts: A Comprehensive Evaluation Framework with CUDRT》解读。