
VBGRU:数据自筛选与变分推理双重驱动下的长时序列预测突破
A Variational Bayesian Deep Network with Data Self-Screening Layer for Massive Time-Series Data Forecasting
本文提出了一种集成数据自筛选层(DSSL)的变分贝叶斯深度预测网络(VBGRU),专门用于大规模时间序列数据预测。该方法通过最大信息距离系数(MIDC)筛选输入特征,并利用变分推理优化 GRU 权重,在北京市 PM2.5 预测任务中达到了 SOTA 精度。
核心速览
TL;DR:针对大规模时间序列数据中的冗余和噪声问题,本文提出了一个包含数据自筛选层(DSSL)和变分贝叶斯门控循环单元(VBGRU)的模型。它不仅能通过 MIDC 系数自动剔除“看似相关实则冗余”的特征,还通过将网络权重分布化,解决了传统深度学习模型容易在噪声数据上过拟合的顽疾。
背景定位:该工作是针对工业传感器预测场景的一项“架构优化+不确定性建模”融合研究,通过引入贝叶斯视角,为经典 GRU 模型在处理噪声环境下的鲁棒性提供了新的 SOTA 基准。
痛点深挖:数据越多,预测越准吗?
在空气质量预测或工业 IoT 场景中,虽然我们能获取数百个维度的传感器数据,但这些数据往往存在以下问题:
- 冗余致盲:例如 PM2.5 和 AQI 之间存在极高的相关性,但同时输入两个变量并不会提供额外信息,反而增加了计算负担。
- 噪声污染:传感器的测量误差(Noise)会被确定性模型误认为是特征,导致模型在预测时产生剧烈波动。
现有研究(如 LSTM, CNN-LSTM)大多关注如何堆叠更深的架构,却忽略了从源头提升输入质量和模型自身的抗噪性。
方法论详解:从数据清洗到权重分布化
1. DSSL:智能的数据“守门员”
作者设计了一个数据自筛选层(Data Self-Screening Layer, DSSL)。其核心工具是 MIDC(Maximal Information Distance Coefficient)。
- MIC 捕捉非线性相关性。
- DE(距离熵) 衡量冗余度。 MIDC 通过贝叶斯超参数优化,自动学习如何平衡相关性与冗余,只保留最有价值的特征。
2. VBGRU:将确定性改为不确定性
传统的神经网路权重 是一个固定值。VBGRU 则认为 应当服从一个高斯分布: 通过变分推理(Variational Inference),模型学习的不再是单纯的数值,而是均值 和方差 。每次前向传播时,通过蒙特卡洛采样(Monte Carlo Sampling)获取权重。
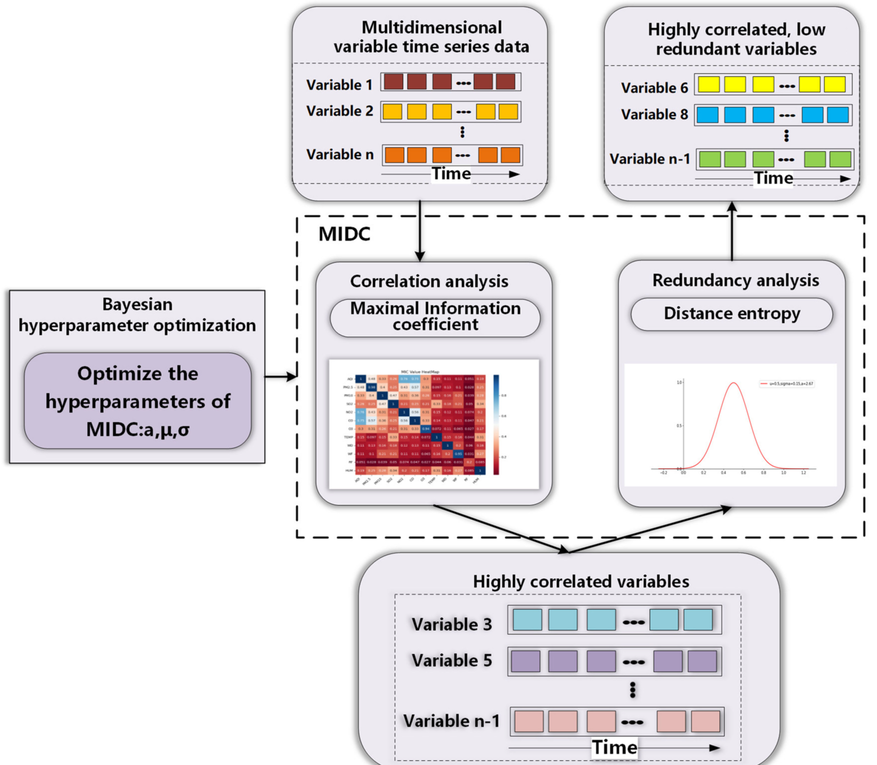 图 1:DSSL 层架构与变量筛选流程
实验与结果
在针对北京市(以官园监测站为中心)24 小时 PM2.5 预测的实验中,VBGRU 展现了统治级的数据表现。
- 精度对比:在与 LSTM, GRU, ConvLSTM, TCN 等 5 种基线模型对比中,VBGRU 的 RMSE、MSE 和 MAE 均为最低。
- 鲁棒性验证:通过 10 折交叉验证的“小提琴图”,可以看到 VBGRU 的误差分布极其集中且均值较低,这反映了模型在面对非平稳数据(Non-stationary Data)时极强的泛化能力。
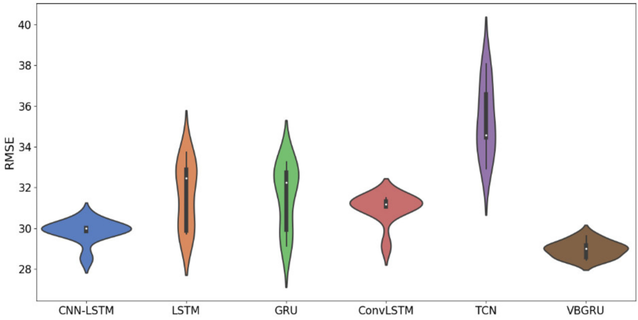 图 2:不同模型的交叉验证误差分布(小提琴图)
深度洞察
VBGRU 的成功其实揭示了深度学习在工业领域应用的一个重要趋势:回归统计直觉。
- 特征质量胜过架构复杂度:通过 DSSL 减少输入维度,模型的收敛速度反而提升,且由于减少了无效干扰,精度也随之提高。
- 贝叶斯是噪声的天敌:变分推理通过引入随机性,起到了一种类似动态 Dropout 的正则化效果,使得模型能够自动忽略那些随机波动的噪声。
局限性:尽管 VBGRU 在精度上优势明显,但由于每回合预测均需要多次采样计算平均,其训练时间(44.81s)略高于标准的 GRU(39.97s)。在对实时性要求极其严苛且算力有限的嵌入式设备上,仍有优化空间。
总结
本文提出的 VBGRU 模型成功证明了在海量时序数据面前,“克制”地筛选特征与“拥抱”随机性是不确定性环境下的生存之道。这对于金融市场分析、大规模工业预测、以及多模态时序建模具有重要的参考价值。