
[Entropy 2022] 变分贝叶斯深度网络:引入数据自筛选机制,攻克大规模时序预测中的冗余与噪声
A Variational Bayesian Deep Network with Data Self-Screening Layer for Massive Time-Series Data Forecasting
本文提出了一种结合数据自筛选层(DSSL)与变分贝叶斯门控循环单元(VBGRU)的深度学习网络,用于大规模时间序列预测。该方法通过 MIDC 系数剔除冗余数据,并利用变分推理提升模型在噪声环境下的鲁棒性,在 PM2.5 预测任务中达到 SOTA 性能。
TL;DR
针对大规模时间序列预测中存在的数据冗余和传感器噪声两大痛点,北京工商大学的研究团队提出了一种集成“数据自筛选层 (DSSL)”与“变分贝叶斯门控循环单元 (VBGRU)”的新型架构。该模型通过一种新颖的 MIDC 指标筛选出高相关、低冗余的变量,并利用变分推理将确定性网络转变为随机权重网络。实验表明,该方法在北京市 PM2.5 精准预测任务中展现了极强的鲁棒性和预测精度。
背景定位:大数据不等于“好数据”
在 AI 驱动的环境监测或工业预测中,研究者往往倾向于采集尽可能多的关联变量。例如,预测 PM2.5 时会引入 PM10、SO2、温度、湿度及周边站点的观测值。然而,这类“大数据”往往伴随着两个致命问题:
- 信息过载与冲突:变量间存在极强的空间相关性(如相邻站点数据近似重复),直接输入会导致模型被冗余信息淹没。
- 观测噪声:传感器误差会导致模型过拟合(Overfitting),使预测结果在面对突发异常波动时表现糟糕。
核心机制:从 DSSL 到 VBGRU
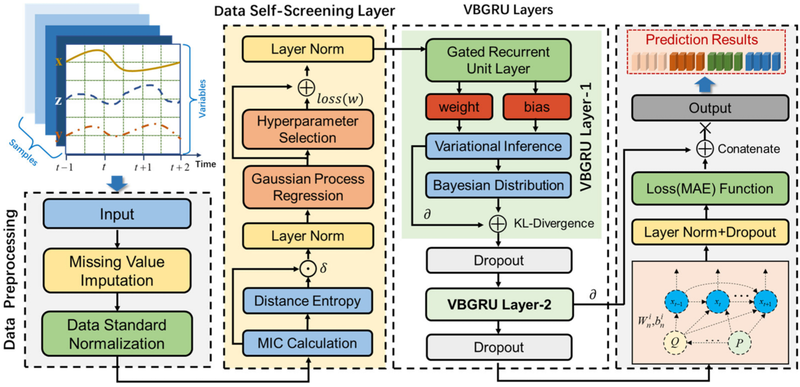
1. 数据自筛选层 (DSSL):信息的“精炼厂”
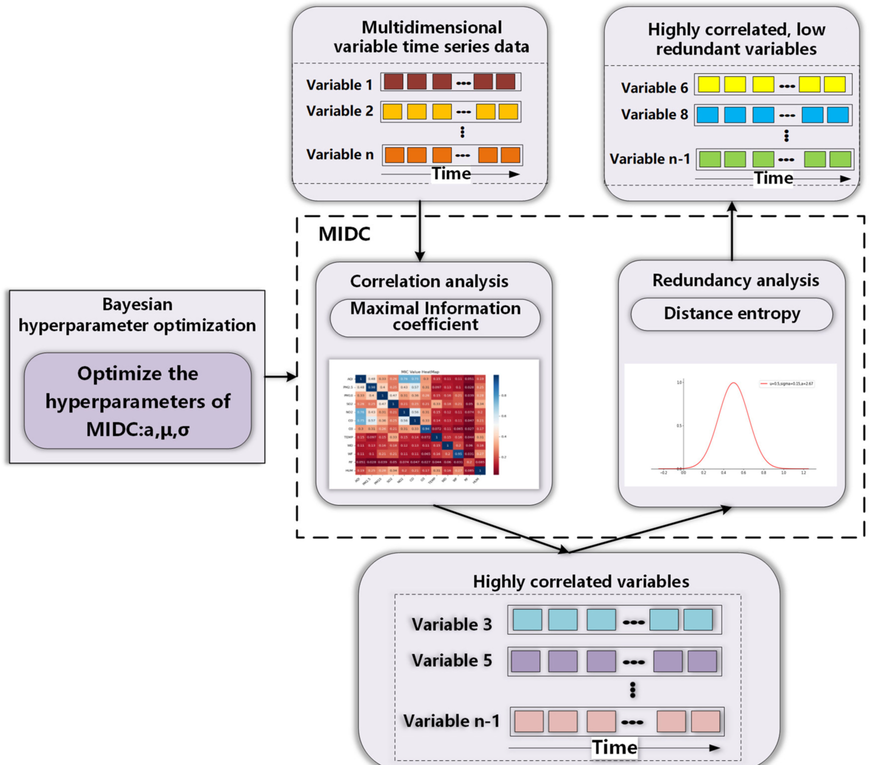
作者认为,简单的相关系数(如 Pearson 或 MIC)只能反映两个变量是否“相关”,却无法判断它们是否“冗余”。为此,他们提出了 最大信息距离系数 (MIDC)。
- 核心直觉:利用最大信息系数 (MIC) 衡量相关性,利用距离熵 (Distance Entropy) 衡量冗余度。
- 自适应优化:通过贝叶斯超参数优化,DSSL 能够针对不同的输入数据集自动调整筛选阈值,确保进入模型的信息既全又精。
2. 变分贝叶斯 GRU:对抗不确定性
传统的 GRU 网络权重是固定的,而 VBGRU 则认为权重应该是一个概率分布。
- 变分推理 (Variational Inference):在训练过程中,模型不再学习权重的具体数值,而是学习其均值和方差。
- 随机采样:在推理时,通过蒙特卡洛采样获取权重,使得模型能够输出具有“置信度”的预测值。这种机制天然具有正则化作用,极大提升了模型在面对传感器噪声时的泛化能力。
实验战绩:SOTA 性能验证
研究人员利用北京市 2017-2021 年的空气质量数据进行了长达 24 小时的 PM2.5 预测实验。
筛选效益
实验对比显示,虽然 AQI 与 PM2.5 的相关性 (MIC) 极高,但由于其冗余度也高,引入后提升有限。而 MIDC 选择的 CO 变量虽然 MIC 略低,但有效信息量大,使 RMSE 显著下降。
基线对比
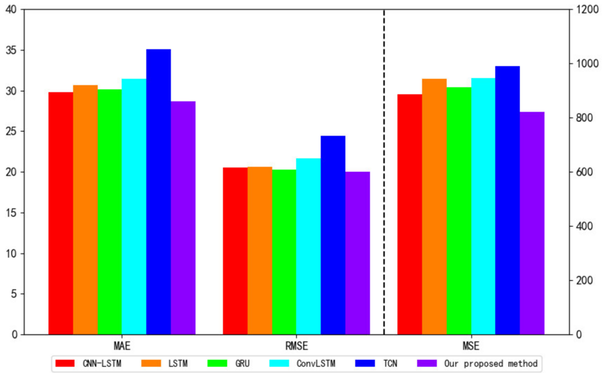
在与 LSTM、CNN-LSTM、TCN 等主流模型的 10 折交叉验证对比中,VBGRU 表现优异:
- RMSE 指标:VBGRU 为 28.59,较 TCN (35.05) 降低了 18.4%。
- 鲁棒性:通过小提琴图分析可见,VBGRU 的误差分布最为集中,证明其在不同时段的表现极其稳定。
深度洞察
本文的成功在于对“Inductive Bias(归纳偏置)”的精准把握。在时序预测中,并非网络越深、堆叠的卷积层越多就越好。通过变分推理引入概率思维,能够弥补传感器硬件带来的先天不足(噪声);而 DSSL 则是在信息论层面为深度学习做减法。
局限性探讨:变分推理虽然提升了鲁棒性,但多次采样推理(Monte Carlo Sampling)会在一定程度上增加预测时的延迟。对于极高频的实时交易预测场景,如何在计算开销与不确定性建模之间取得平衡,仍是值得进一步研究的方向。
总结
VBGRU 配合 DSSL 层的设计,为处理海量、高噪的时序数据提供了一套完整的逻辑闭环。它告诉我们:理解数据的本质属性(相关性与冗余性),往往比单纯追求模型架构的复杂化更为有效。