
VGGT-Ω:馈送式重建的大模型时代,从几何重构到空间理解的飞跃
VGGT- Ω
VGGT-Ω 是一款最先进的馈送式(Feed-forward)3D 重建模型,通过在大规模静态及动态场景数据上进行参数与数据扩张(Scaling),在 Sintel 等基准测试中实现了性能突破,其相机估计精度提升幅度高达 77%。
TL;DR
牛津大学 VGG 团队联合 Meta AI 发布了 VGGT-Ω,这是对馈送式(Feed-forward)3D 重建模型的一次全方位升级。通过极致的架构优化(Register Attention)和前所未有的数据扩张(4M 序列),VGGT-Ω 不仅在静态场景,而且在极具挑战的动态场景中也全面超越了基于优化的传统方法(如 COLMAP 和 MegaSaM)。更重要的是,它证明了几何重建任务可以产生极强的底层特征,直接赋能机器人(VLA)和多模态理解。
1. 为什么我们需要 VGGT-Ω?(痛点分析)
在 3D 重建领域,传统的 SfM(运动恢复结构)通常依赖复杂的非线性优化,速度慢且在特征缺失时极易崩溃。虽然之前的 VGGT 证明了单次前向传导(Feed-forward)也能做重建,但它面临三个核心挑战:
- 计算资源陷阱:全局注意力机制(Global Attention)的复杂度随帧数二次增长。
- 显存吞噬者:高分辨率卷积解码头在训练时占据了额度极高的显存。
- 数据极度匮乏:高质量、大规模的 3D/4D 标注数据极难获取,尤其是涉及动态运动的视频。
2. 核心架构:Register Attention 与极简解码器
为了突破上述限制,作者对 Transformer 架构进行了定点手术。
2.1 Register Attention:跨帧交互的“高速路”
作者观察到全局注意力矩阵其实非常稀疏(如下图所示)。
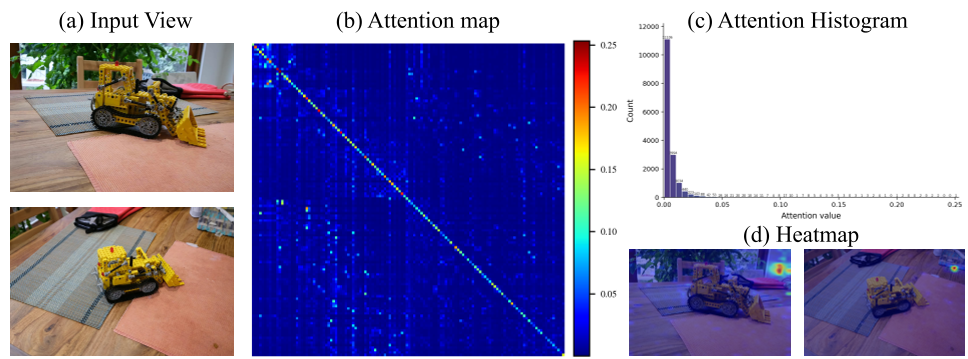
既然信息不需要全量交换,作者引入了 Register Attention:
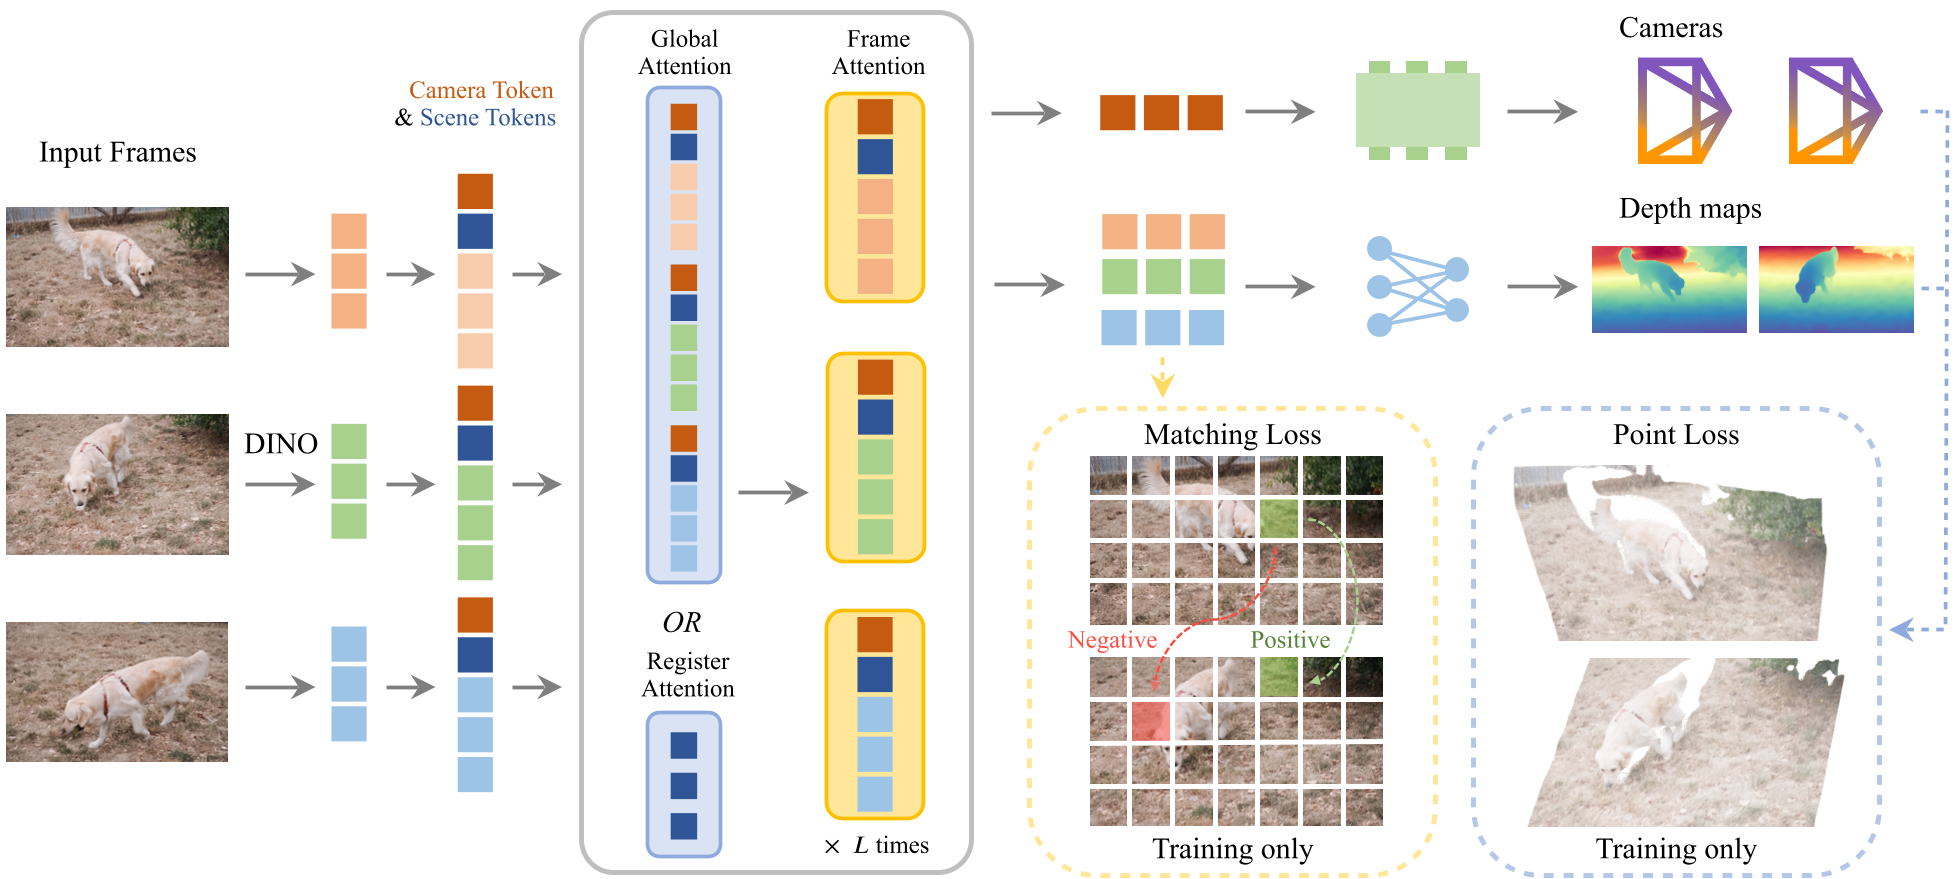
- 在 25% 的全局层中,取消所有图像 Token 间的直接对比。
- 仅允许每帧的 Registers(场景 Token) 进行跨帧交互。
- 直觉:Registers 充当了场景信息的“压缩包”和“路由器”,大大降低了计算量,同时保持了全局一致性。
2.2 极致的训练效率提升
- 移除冗余头:不再显式预测 Point Map 和 Tracking Head,而是通过辅助 Loss 直接监督骨干网络。
- Pixel Shuffle 替代卷积:在解码器末端使用 MLP + Pixel Shuffle 替代高分辨率卷积层,节省了大量前向激活值的存储空间。
- 成果:训练显存占用仅为前作的 30%,这使得训练 10B 参数 的巨型重建模型成为可能。
3. 数百万级的 3D 数据工厂
重建模型的上限由数据质量决定。作者开发了一套极其严格的自动标注管线:
- VLM 预筛选:用大模型先剔除掉那些剪辑过的、糊成一片的烂片。
- 动态掩码:用 Grounding DINO 扣掉行人和车辆,保证几何计算的鲁棒性。
- 多重一致性校验:通过重投影误差和监督几何滤波器(XGBoost),只保留 2% 最完美的标注。
最终,模型吞噬了 400 万条 标注序列和 1800 万条 无标签视频(通过 Teacher-Student 自监督学习),形成了恐怖的几何先验。
4. 实验结果:全方位的制霸
VGGT-Ω 在静态和动态重构上都展现了霸主地位。在 Sintel 这种充满动态物体的复杂视频中,其表现堪称惊艳。
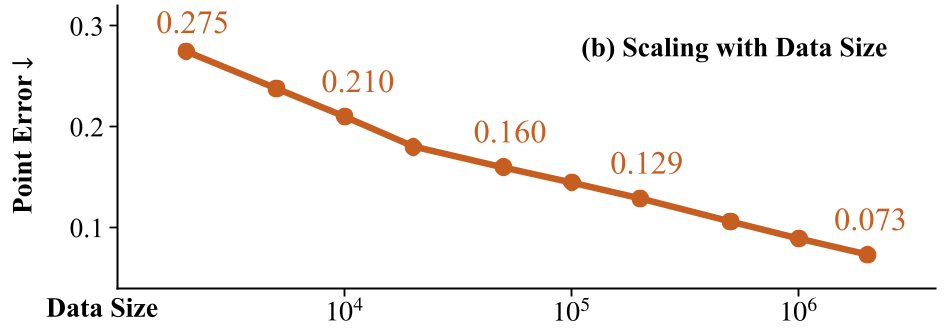
- 性能扩张:实验明确显示,重建精度遵循 Power-law(幂律)Scaling,即模型越大、数据越多,精度越强(且尚无封顶迹象)。
- 对比 SOTA:相较于之前的王者 Depth Anything 3 (DA3),VGGT-Ω 的轨迹更连续,在重复纹理(如下雪天)下表现更稳。
5. 跨越几何:走向通用空间表征
这篇论文最令人振奋的发现是 Registers 的价值:
- 赋能机器人:将预训练好的 VGGT-Ω Register 直接喂给 VLA 模型(如 OpenVLA),任务成功率显著提升。
- 对齐语言:仅通过极少量的微调,这些 Register 就能与语言描述(如“一个阳光明媚的客厅”)对齐,证明了重建任务能自发催生语义理解。
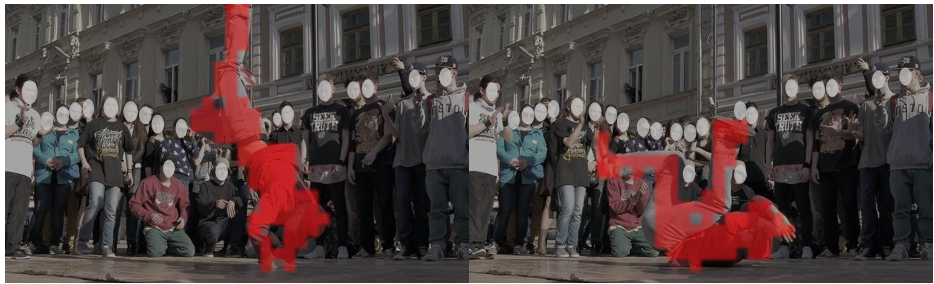
- 动觉学习(Motion Awareness):即便没有显式监督,模型中间层的特征聚类也能精准分离出运动物体(如舞者)。
6. 总结与启示
VGGT-Ω 宣告了 3D 重建不再是一个孤立的几何优化问题,而是一个可以被“规模化”解决的 AI 任务。
- 简单胜过复杂:优先保证主干网络(Backbone)的简洁和数据吞吐量,比设计复杂的解码头更有利于扩张。
- 几何是理解的基石:强力的几何表征可以自然地与语言对齐,成为构建未来“万能模型(Omni-model)”平衡物理定律的关键。