
VIST3A:缝合视频生成器与 3D 模型,开启文本转 3D 的新范式
VIST3A: Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video Generator
本文提出了 VIST3A 框架,通过“模型缝合”(Model Stitching)技术将预训练视频生成器的潜空间与现成的 3D 重建网络(如 AnySplat, MVDUSt3R)直接连接。该方法在 Text-to-3D 任务上实现了 SOTA 性能,能够从文本直接生成高质 3D Gaussian Splatting (3DGS) 和点云图。
TL;DR
传统的 Text-to-3D 模型要么依赖缓慢的每场景优化(SDS),要么必须从头训练复杂的 3D 解码器。VIST3A 提出了一个天才的设想:既然视频生成器懂“动态变化”,3D 重建模型懂“几何结构”,我们能否直接把它们“缝”在一起? 该研究通过模型缝合(Model Stitching)和直接奖励微调(Direct Reward Finetuning),实现了从文本到高精度 3DGS 和点云的直接生成。
背景定位
目前 3D 生成领域正从“基于优化的生成”转向“端到端潜空间扩散模型(LDM)”。然而,现有的 3D LDM 往往在解码器(Decoder)上栽了跟头——它们训练的解码器无法匹敌那些在超大规模 3D 数据上预训练的感知模型(如 DUSt3R)。VIST3A 正是这种矛盾下的产物,它立志于作为生成器与感知模型之间的“粘合剂”。
核心动机:为什么要“缝合”?
作者发现,现有的 2D-to-3D 扩散模型面临两个核心瓶颈:
- 解码器能力上限:强行重新训练一个 3D VAE 既费时又无法利用 3D 视觉领域的最新成果(Foundation Models)。
- Latent 空间的断层:即使生成器生成了多视角图像的潜变量,这些变量往往不在 3D 解码器的理想分布内,导致生成的 3D 物体“扭曲”或“闪烁”。
方法论详解:如何实现无缝连接?
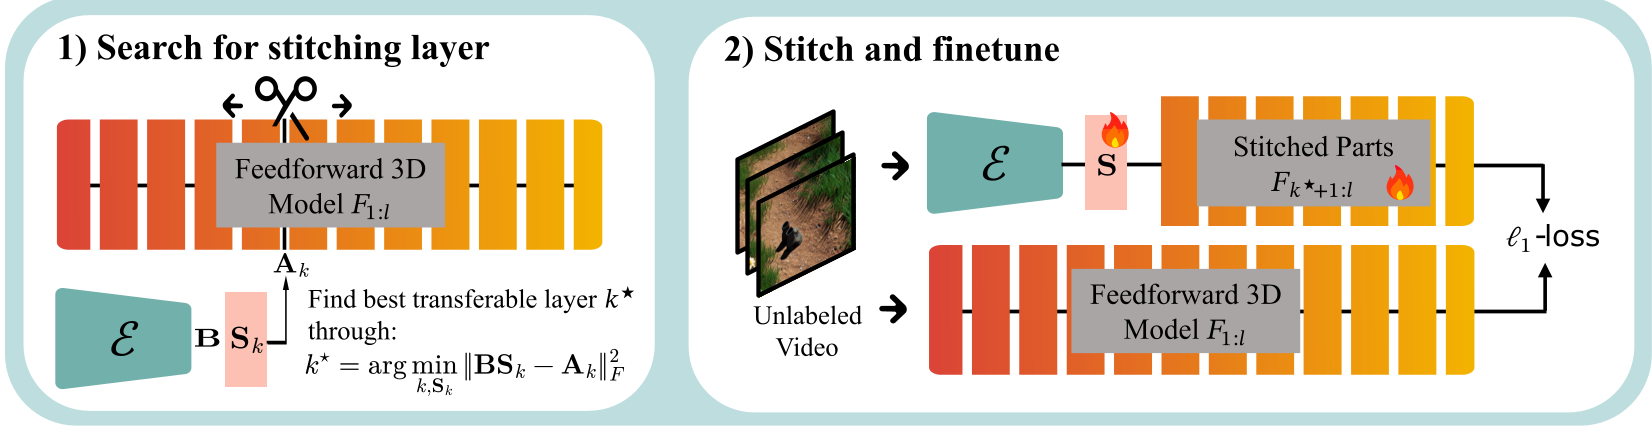
1. 模型缝合 (Model Stitching)
VIST3A 的精髓在于它不是去重新设计一个网络,而是去做“手术”。
- 寻找切口:作者通过线性最小二乘法分析,寻找 3D 重建网络(如 AnySplat)中哪一层的特征与视频 VAE 的 Latent 最匹配。实验发现,**早期层(Early Layers)**通常包含更丰富的底层特征,更适合缝合。
- 线性层补丁:在 VAE 编码器和 3D 解码器之间插入一个简单的卷积缝合层(Convolutional Stitching Layer),以对齐空间和时间维度。
2. 直接奖励微调 (Direct Reward Finetuning)
缝合完成后,生成器可能还没意识到它现在服务的是一个 3D 解码器。为此,作者引入了强化学习驱动的对齐:
- 质量奖励:使用 CLIP 和 HPSv2 评价渲染图的审美和指令遵循度。
- 几何一致性奖励:强制要求 3D 重建后的渲染图与视频解码器输出的原始图在像素级和感知级(LPIPS)上一致。
实验与结果:性能的飞跃
VIST3A 在多个权威榜单上展现了统治力。特别是在 DPG-Bench(长文本解析)任务中,其表现远超此前的 SOTA 方法 SplatFlow 和 Director3D。

- 视觉一致性:生成的 3D 场景不仅符合物理规律,且纹理细节极其精细。
- 泛化性:该框架支持多种 Video Backbone(如 Wan 2.1, CogVideoX)和多种 3D 形式(3DGS, Pointmap)。
深度洞察与总结
VIST3A 的成功表明,模型能力是可以跨域搬运的。我们不需要为每一个新任务训练一个巨型 VAE,通过寻找不同网络特征空间之间的“公约数”,我们可以像拼积木一样组合出强大的多模态系统。
局限性: 目前的缝合高度依赖于视频 VAE 的时间顺序。如果输入的视图是完全无序的,编码器可能会失效,这要求模型在处理非视频源数据时仍需显式的视角排序。
未来展望: 这种缝合的思想未来可能扩展到 4D 动态场景生成,或者更复杂的机器人交互环境生成中。