
VIST3A:缝合视频生成器与 3D 重建模型,开启 Text-to-3D 高清新范式
VIST3A: Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video Generator
本文提出了 VIST3A 框架,通过 Model Stitching(模型缝合)技术将预训练视频生成器的潜空间与现成的 3D 重建网络直接连接,构建高性能的 3D VAE。该方法显著提升了 Text-to-3D 生成的几何一致性和视觉质量,在 T3Bench 和 SceneBench 等多个基准测试中刷新了 SOTA 战绩。
TL;DR
传统的 Text-to-3D 生成要么慢得离谱(由于逐场景优化),要么几何畸变严重(解码器训练不足)。来自苏黎世联邦理工学院(ETH Zurich)和 Google 的研究者们提出了 VIST3A,核心思路非常暴力且优雅:既然视频生成器懂动态,3D 重建模型懂空间,何不直接把它们“缝好”?通过 Model Stitching 建立连接,再用 Direct Reward Finetuning 解决对齐,VIST3A 在 3D 高斯泼溅(3DGS)生成上实现了质的飞跃。
1. 痛点深挖:为什么 3D 生成总是“差点意思”?
在 3D 生成领域,目前主流的潜在扩散模型(LDM)存在一个“阿喀琉斯之踵”——解码器(Decoder)。
大多数方法为了将 2D 潜空间映射到 3D,会强行训练一个临时的解码器。但这带来两个致命问题:
- 数据饥渴:高质量带标签的 3D 数据极度匮乏,导致这些解码器往往需要从零开始学习空间想象力,效果远逊于专门的 3D 视觉基座模型。
- 对齐脱节:生成器生成的潜变量往往不在解码器的“食谱”里,导致渲染出的结果充满了伪影和视觉闪烁(Texture Flicker)。
2. 核心机制:Model Stitching —— 神经网络手术
VIST3A 的第一步是 Model Stitching(模型缝合)。研究者发现,虽然视频 VAE 和 3D 重建模型(如 MVDUSt3R, AnySplat)是独立训练的,但它们的内部表示空间其实存在某种“默契”。
如何缝合?
- 层级搜索:在 3D 重建模型中寻找一个特定的层 ,使得该层激活值与视频编码器的潜变量(Latent)之间,只需要一个简单的线性变换就能高度重合。
- 线性过渡:插入一个 Conv3D 卷积层作为“缝合模块”。
- 模块复用:直接弃掉 3D 模型的前半部分,保留其推理精度极高的后半部分作为 3D 解码器。
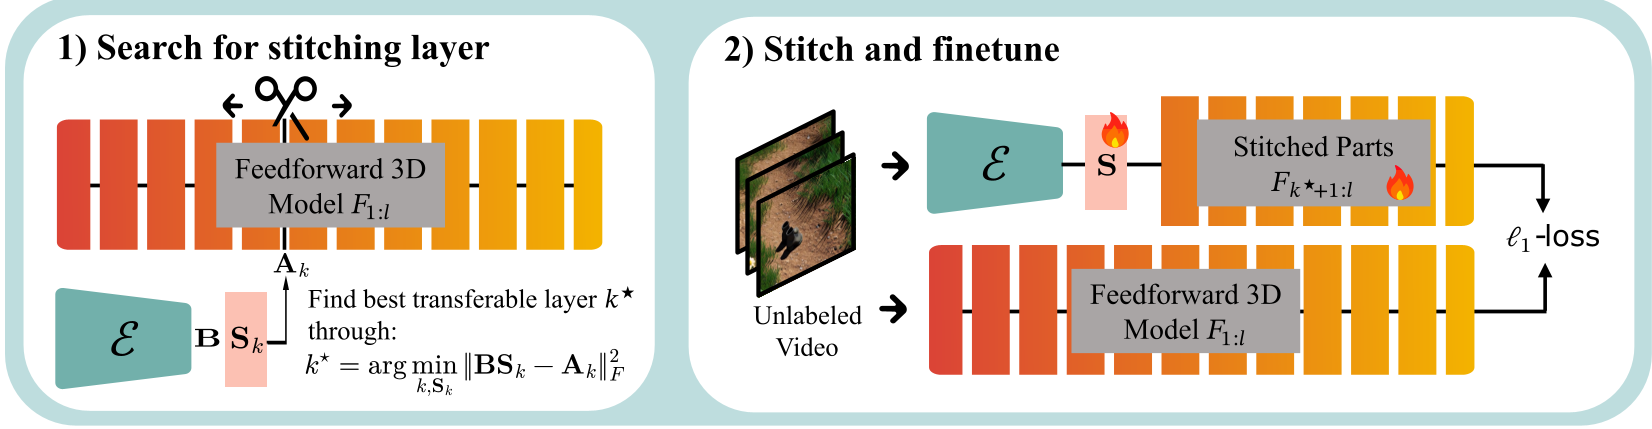 图 1:VIST3A 的缝合与对齐流程。上半部分展示了如何通过线性变换连接两个异构模型。
这种做法的神奇之处在于:它几乎不需要改变 3D 基座模型的权重,就能让原本生成视频的潜空间具备输出高质量点云或 3DGS 的能力。
3. 强化对齐:Direct Reward Finetuning
缝合完成后,生成器生成的 Latent 可能还是不够“利于解码”。为此,VIST3A 引入了 Direct Reward Finetuning(直接奖励微调)。
不同于传统的生成损失(Generative Loss),VIST3A 设计了三重奖励机制:
- 多视图质量:使用 CLIP 和 HPSv2 确保生成的图像好看且符合 prompt。
- 3D 表现质量:对渲染出的 3D 场景再次评价。
- 3D 一致性:计算 decoded 图像与 rendered 图像之间的 距离和 LPIPS 损失,强迫生成器产生在几何上完全一致的潜变量。
4. 实验结果:刷新学术坐标系
VIST3A 的表现堪称惊艳。在与 SplatFlow, Director3D 等前沿方法的对比中,VIST3A 在图像美感(Aesthetic)和几何一致性(Coherence)上展现了统治力。
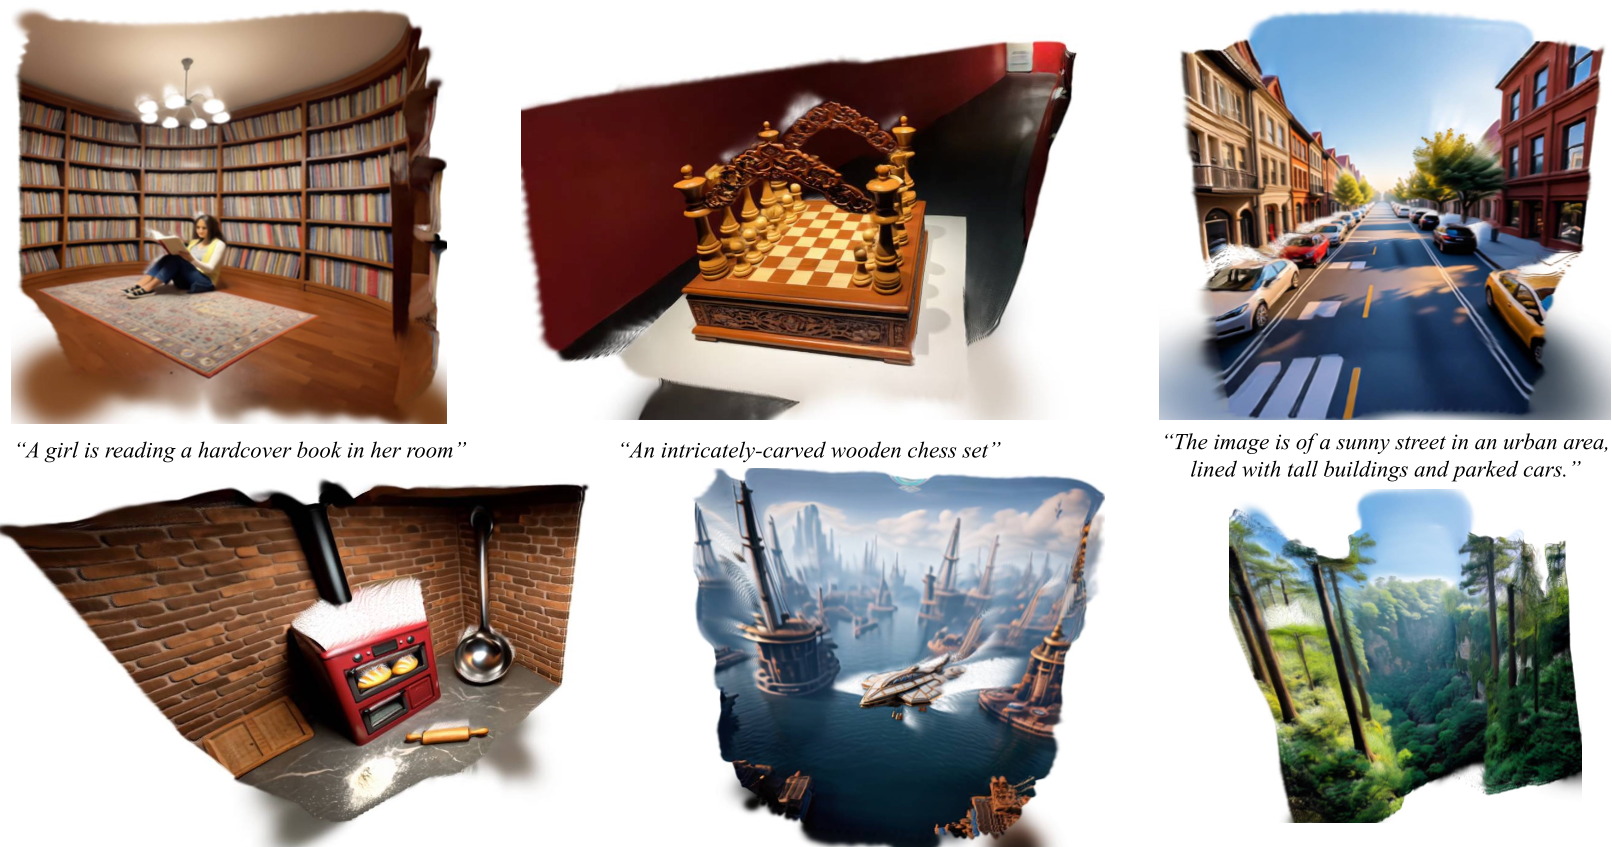 图 2:在 SceneBench 上的定性对比。VIST3A(最右)生成的森林和气球场景在细节丰富度和空间逻辑上明显优于基线模型。
关键定量指标:
- DPG-Bench:在处理非常长且复杂的 Prompt 时,VIST3A 的对齐分数(Align)相比前代 SOTA 提升了约 20%。
- 鲁棒性:消融实验(Ablation Study)证明,这种集成式的 VAE 结构对潜空间的噪声更具免疫力,重建精度非常稳定。
5. 深度洞察与展望
VIST3A 最核心的贡献不在于推出了一个新的 3D 模型,而在于提供了一种跨模态能力的迁移范式。
- 启发:我们并不总是需要从头训练昂贵的 Foundation Model。通过寻找异构模型之间的线性对应关系,我们可以像拼乐高一样组合出更强大的 AI 助手。
- 局限性:由于编码器继承自视频模型,它对输入帧的顺序有一定要求(必须像平滑的视频序列)。对于完全乱序的多视角图片,其表现可能会有所波动。
总结
VIST3A 证明了“缝合”也是一种硬科技。它通过将视频生成的前沿研究与 3D 重建的几何严谨性结合,为 VR/AR 和游戏行业提供了一个低成本、高产出的 3D 内容自动化方案。
本文由资深学术技术主编基于 arXiv 原文重构输出。如需引用,请参考 VIST3A 官方项目页面。