
VIST3A:视频生成器与 3D 重建器的完美“封神缝合”
VIST3A: Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video Generator
VIST3A 提出了一种创新的 Text-to-3D 框架,通过将预训练的视频生成器(如 Wan, SVD)与高性能 3D 重建网络(如 AnySplat, MVDUSt3R)进行“模型缝合 (Model Stitching)”,实现了高质量、几何一致的 3D 场景生成。该模型在 T3Bench 和 SceneBench 等多个基准测试中显著超越了现有的 SOTA 方法。
TL;DR
VIST3A 提出了一种极其聪明的思路:既然视频生成器懂“时序一致性”,3D 重建器懂“几何结构”,为什么不把它们缝在一起?通过模型缝合 (Model Stitching) 和奖励微调 (Reward Finetuning),VIST3A 成功将 Wan、Hunyuan 等视频基础模型转化为高效的 Text-to-3D 生成器,生成的 3D 场景在清晰度和空间一致性上均刷新了记录。
痛点与动机:为什么 3D 生成总是在“闪烁”?
目前的 Text-to-3D 领域主要有两条路:一是类似 DreamFusion 的分步优化,慢得离谱;二是 Pipeline 方案,先生成多视图图片再做重建。
然而,Pipeline 方案存在一个致命伤:潜空间不兼容。视频生成器的输出是为了“好看”,而重建网络的输入需要严谨的“几何逻辑”。当我们将视频 VAE 的 Latent 传入 3D 解码器时,往往会因为特征偏移导致模型崩坏。以往的做法是耗费巨额算力去重训练,但这极大限制了基础模块的可插拔性。
方法论详解:如何优雅地进行“缝合”?
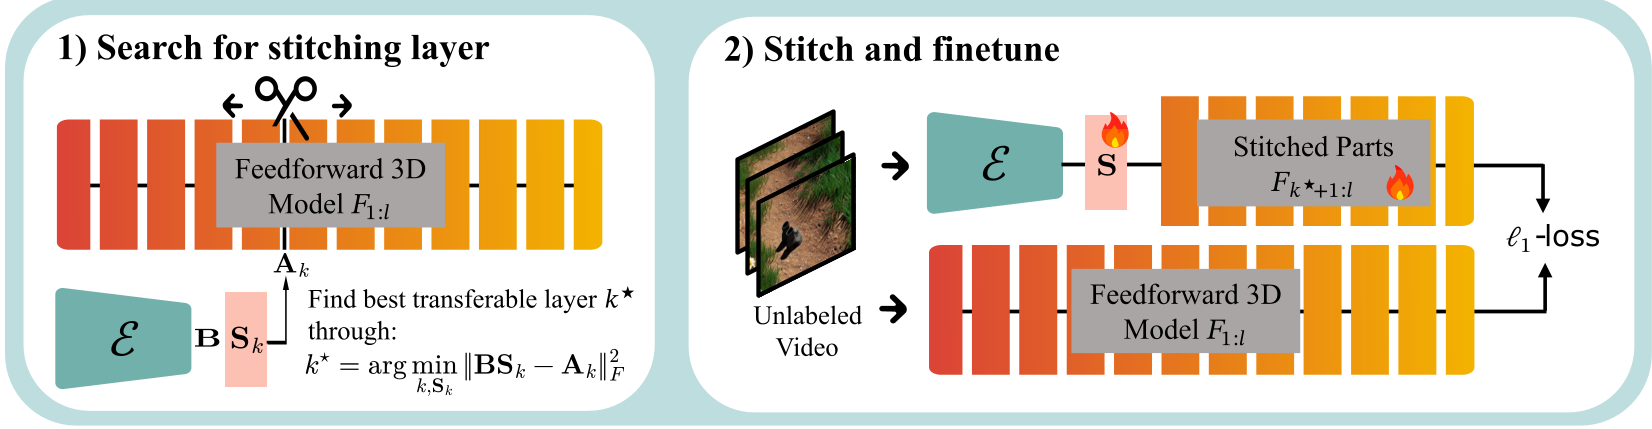
1. 寻找最契合的“接口层”
作者并没有盲目添加 Adapter,而是通过实验发现,预训练 3D 解码器的某些中间层与视频生成器的 Latent Code 存在极强的线性相关性。他们通过最小化 Frobenius 范数,找到了最优的缝合层级和线性变换矩阵 :
这种方法只需要极少量的无标签数据,就能让 3D 解码器“听懂”视频生成器的语言。
2. 模型架构
VIST3A 的整体流程是:Text Prompt -> Video Latent Generator -> Stitched Decoder -> 3D Representation (3DGS 或 Pointmap)。
3. 基于奖励的对齐微调
缝合后,为了让生成的结果不仅“能看”而且“精准”,作者引入了直接奖励微调 (Direct Reward Finetuning)。
- 质量奖励:利用 CLIP 或 HPS 模型评估文本匹配度与审美。
- 一致性奖励:通过渲染结果与解码结果的 损失和 LPIPS 来强迫生成器产出几何一致的特征。
实验与结果:全方位碾压 SOTA
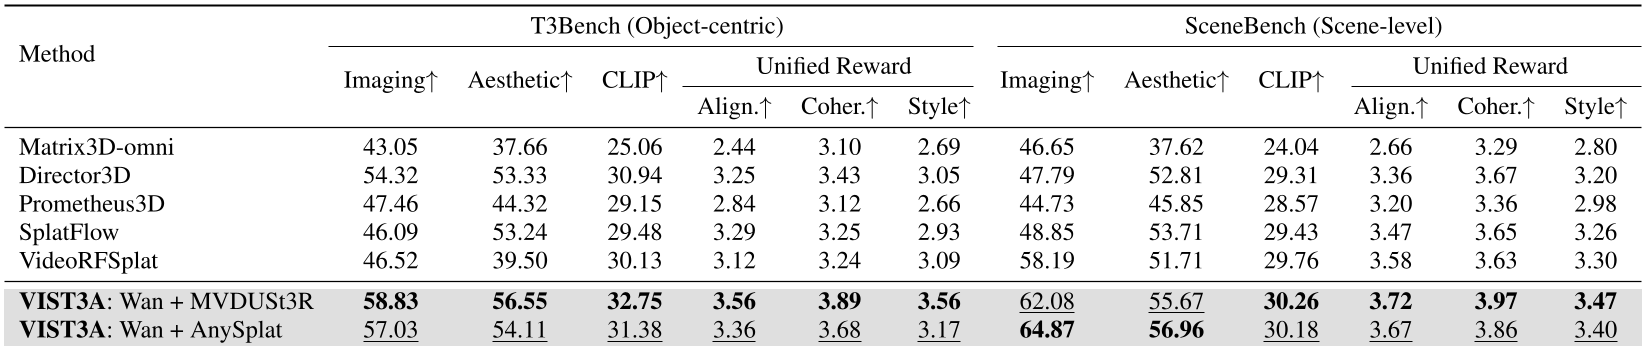
在 T3Bench 的评测中,VIST3A 展现了恐怖的统治力。无论是在物体中心(Object-centric)还是复杂场景(Scene-level)任务下,其在成像质量、审美评分以及文本对齐度上均大幅领先于之前的基线模型(如 SplatFlow, Director3D)。
消融实验揭秘
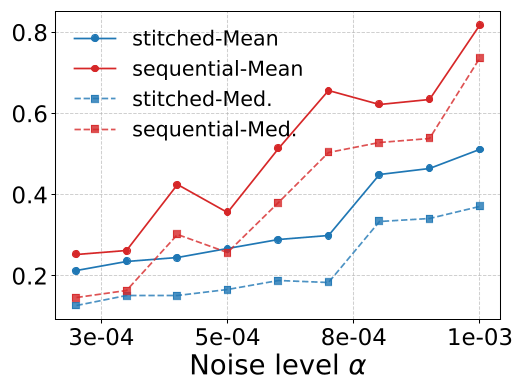
通过消融实验(Ablation Study)可以看到,如果不进行奖励微调(Finetuning-free),模型容易产生伪影;而加入 3D 一致性奖励后,场景的稳定性显著增强,不再有恼人的纹理漂移。
深度洞察:3D 生成的未来在“组装”而非“重建”
VIST3A 的核心贡献不仅仅是一个 SOTA 模型,它提供了一种解耦的研究范式。
- 基础模型的可扩展性:如果明天出了更强的视频生成模型(如 Sora 开源版),开发者可以在几分钟内通过“缝合”将其转化为 3D 生成器。
- 效率与质量的平衡:这种方法避开了耗时的 per-scene 过程,同时也利用了视频模型内生的时序连贯性来替代昂贵的 3D 监督。
局限性分析:尽管 VIST3A 表现优异,但其性能高度依赖于基础视频生成器的质量。如果视频生成器本身产生明显的伪影(Artifacts),缝合后的解码器也难以为继。
未来,这类“模型缝合”技术可能会扩展到多模态的各个领域,让我们可以像组装乐高一样,构建出拥有多个领域专家能力的超强智能体。