
VIST3A:缝合视频基础模型与 3D 重建,开启高精度 Text-to-3D 新范式
VIST3A: Text-to-3D by Stitching a Multi-view Reconstruction Network to a Video Generator
VIST3A 是一个创新的 Text-to-3D 生成框架,通过“模型缝合”(Model Stitching)技术将预训练视频生成器的潜空间与前馈 3D 重建网络连接。该方法在不需要大规模 3D 标注的情况下,实现了高保真、几何一致的 3D 高斯泼溅(3DGS)和点图生成,刷新了多个基准测试的 SOTA 记录。
TL;DR
VIST3A 提出了一种极其“聪明”的方法来解决 Text-to-3D 的难题:它不再试图去训练一个笨拙的 3D 解码器,而是直接寻找现成的“王牌”,通过**模型缝合(Model Stitching)**技术,将顶尖的视频生成器(如 Wan 2.1)和 3D 重建模型(如 MVDUSt3R)强行“接骨”。这种方法不仅让生成的 3D 场景几何精度更高,而且利用 直接奖励微调 解决了生成与解码之间的不匹配问题。
1. 背景定位:拒绝重复造轮子
在 Text-to-3D 领域,现有的 Latent Diffusion Models (LDM) 遇到了瓶颈。目前的做法通常是找个 2D 扩散模型,再从头训练一个转换 3D 的解码器。
然而,作者敏锐地发现:
- 数据集贫瘠:高质量、大规模的 3D 标注数据太难搞了。
- 解码器太弱:从头练的 3D 解码器根本打不过像 DUSt3R 这样已经在海量视觉数据上“卷”出来的 3D 基础模型。
- 逻辑断层:生成器在潜空间(Latent Space)里自娱自乐,解码器在 3D 空间里自说自话,两者缺乏默契。
2. 核心直觉:模型“接骨术” (Model Stitching)
VIST3A 的核心贡献在于其对 Model Stitching 的重新思考。
2.1 寻找最合适的“那一层”
既然两个模型都是处理视觉信息的,它们的内部表示一定有相似之处。作者通过计算潜变量(Latents)与 3D 复原模型各中间层 activation 之间的线性相关性(最小二乘法),找到了最佳缝合位置。实验发现,3D 模型的早期层与潜变量的线性关系最强,这说明潜空间中保留了丰富的低级几何特征。
2.2 极简的缝合层
一旦确定了位置,作者只用了一个简单的线性 Conv3D 层作为“粘合剂”。即便两个模型是独立训练的,通过简单的线性变换,就能实现近乎无损的连接。
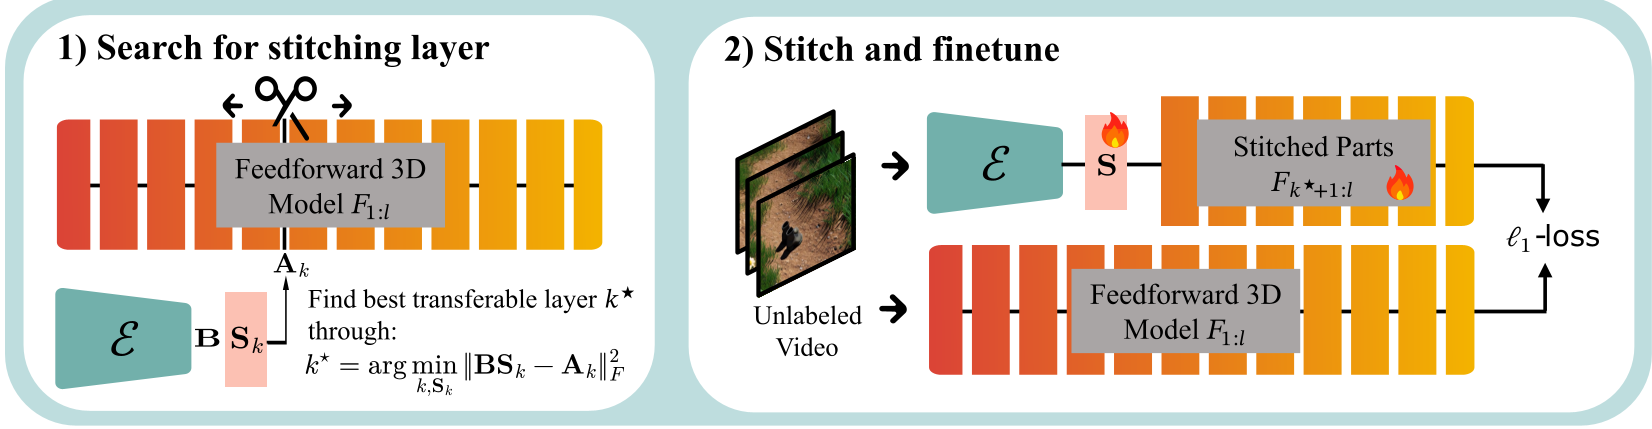 图 1:VIST3A 的模型缝合与对齐流程。上半部分展示通过线性缝合构建 3D VAE,下半部分展示利用奖励微调对齐生成器。
3. 强化对齐:直接奖励微调
仅仅缝合还不够,为了让生成器生成的 Latents 真正对 3D 解码器“胃口”,VIST3A 引入了 Direct Reward Finetuning:
- 质量奖励:利用 CLIP 和 HPSv2 评价解码后的图像效果。
- 一致性奖励:强制要求解码后的 2D 视角与直接渲染的 3D 结果保持像素级和感知级(LPIPS)的对齐。
- 全轨迹优化:与传统的单步损失不同,该方法反向传播通过整个去噪路径,确保推理时的稳定性。
4. 实验战绩:多项全能
VIST3A 不仅在物体生成(Object-centric)上出色,在复杂的场景级生成(Scene-level)上也表现惊人。
- SOTA 碾压:在 T3Bench 和 SceneBench 上,成像质量超过前人 SOTA 10% 以上。
- 长文本理解:在处理超长描述(DPG-bench)时,分数从 60 暴涨至 85 左右,展现了视频基础模型带来的语义理解红利。
- 全模态支持:除了 3D 高斯泼溅(3DGS),它还能直接吐出点图(Pointmap)和相机位姿。
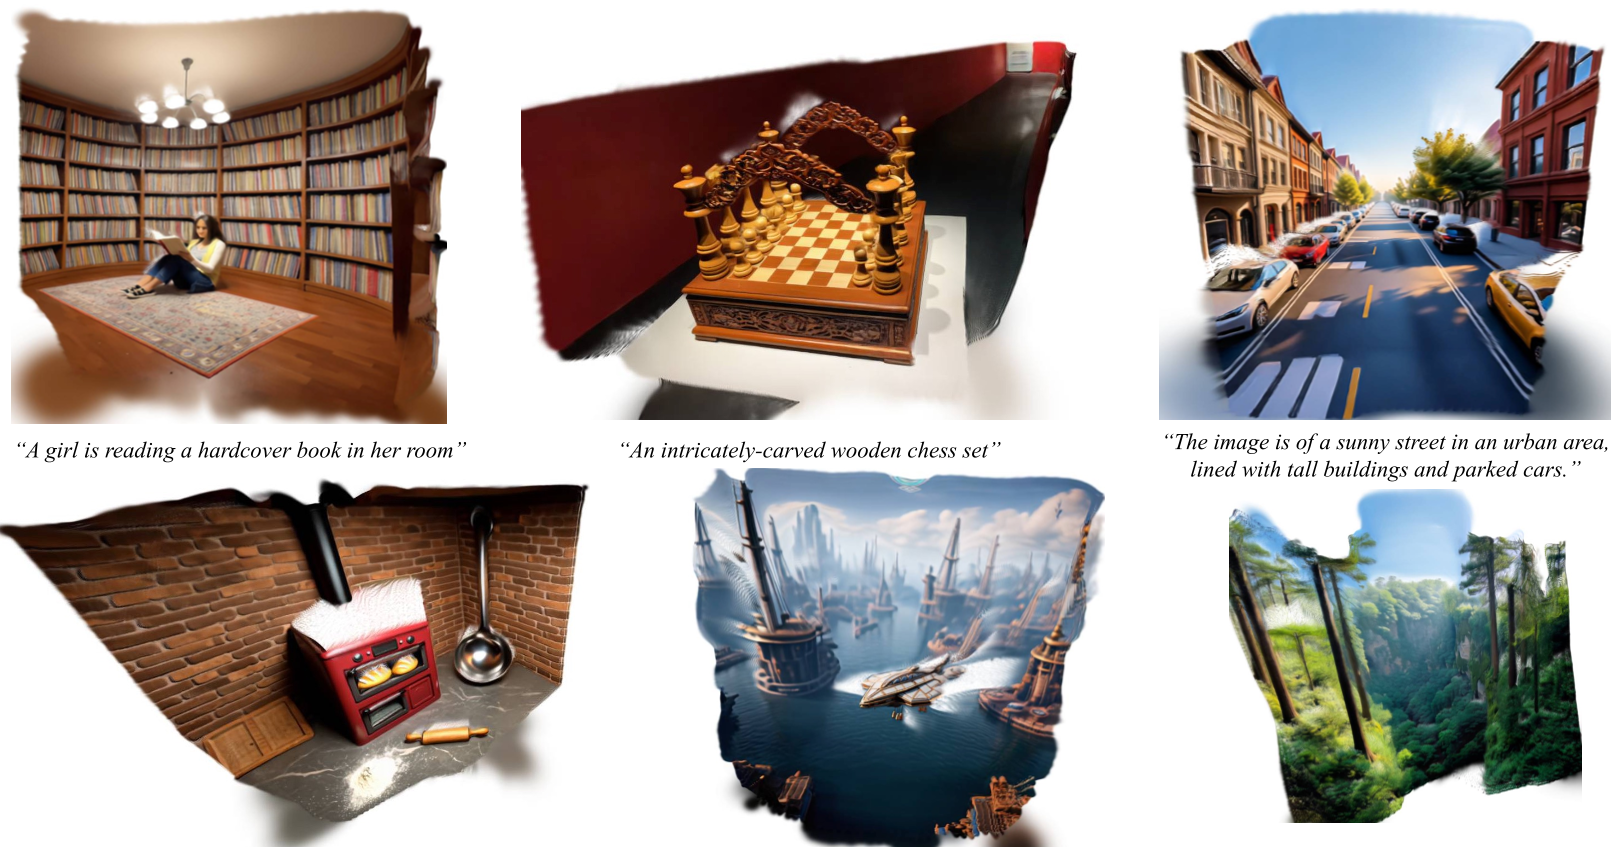 图 2:在 SceneBench 上的定性对比,VIST3A 生成的场景在光影衔接和几何连贯性上明显优于基线模型。
5. 深度洞察与总结
为什么 VIST3A 这么强?
- 降维打击:利用了预训练视频模型(如 Wan 2.1)的海量常识,这远超任何专门的 3D 生成器。
- 站在巨人肩膀上:通过 Stitching 避开了 3D 学习中的“冷启动”问题,直接继承了专业重心重建模型的能力。
- 鲁棒性强:实验显示,这种集成架构比传统的“先生成图再转 3D”的串联模式更能忍受潜空间的噪点扰动。
局限性:由于编码器源自视频模型,输入视角需要按一定的视频顺序(Smooth transitions)排列才能获得最佳性能。
结语:VIST3A 告诉我们,未来的 AI 开发可能不再是“堆数据、暴力训练”,而是如何像“拼乐高”一样,将分散在各个领域的最强组件优雅地组合在一起。