
VGPO:对抗视觉遗忘,让多模态模型在深度推理中“过目不忘”
Visually-Guided Policy Optimization for Multimodal Reasoning (2)
本文提出了 VGPO (Visually-Guided Policy Optimization),一种旨在增强视觉语言模型 (VLM) 多模态推理能力的强化学习框架。该方法通过利用模型内部隐藏状态的相似度来定位视觉重点,并结合双粒度优势重加权策略,在数学推理和视觉依赖任务上显著提升了 SOTA 性能。
TL;DR
大语言模型在多模态(VLM)领域展现了惊人的推理潜力,但它们往往患有“远视症”:在逻辑推导的起初会瞥一眼图像,但随着推理步数增加,它们会逐渐忘记视觉信息,陷入“文本自嗨”,导致推理错误。VGPO (Visually-Guided Policy Optimization) 框架通过模型内部状态的自发引导,在强化学习阶段实施“注意力补偿”,成功解决了时间视觉遗忘问题,在数学推理等多项指标上刷新了 SOTA。
背景定位:为何 VLM 总是“睁眼说瞎话”?
在学术界,通过带验证奖励的强化学习(RLVR)来提升模型推理能力已成主流。然而,作者通过深入调研发现,VLM 存在一种天然的 Text-dominated 偏置。
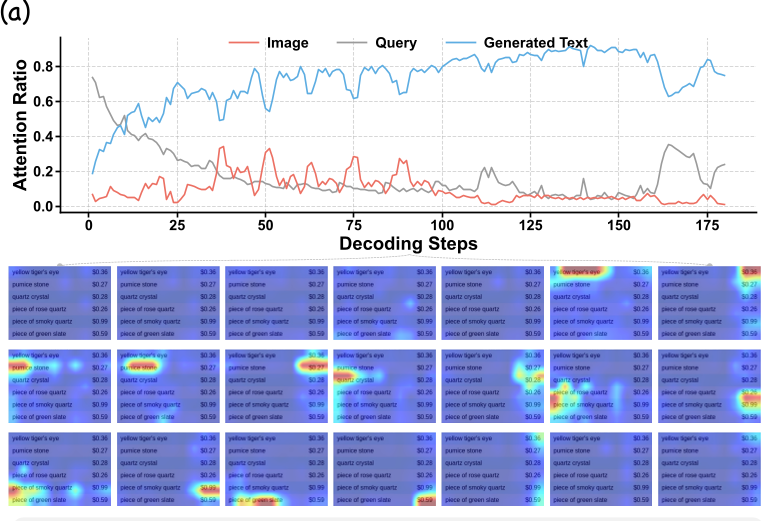 图 1:实证研究显示,随着推理步数增加(蓝色线),模型对图像的注意力(红色线)迅速衰减。
这种现象被称为 Temporal Visual Forgetting(时间视觉遗忘)。正确样本通常能在后期维持较高的视觉关注度,而错误样本则在推理后期几乎完全丢失了视觉锚点。
方法论:无需外部监督的“内省式”引导
以往的方法(如 VAPO 或 PAPO)往往依靠外部 GPT-4 验证或 KL 散度对比,这增加了推理开销。VGPO 的直觉非常优雅:模型其实知道自己在看哪里,只是它忘了坚持。
1. 视觉聚焦评分 (Visual Focus Score)
VGPO 提取图像 Token 的隐藏状态作为“视觉原型”,计算当前生成 Token 与该原型的余弦相似度。这个分数 能够精准反映当前步骤是否真的在“参考图像”。
2. 视觉注意力补偿 (VAC)
为了对抗遗忘,作者设计了一个线性补偿机制: 简单来说,推理步数越靠后( 越大),模型如果还能关注到视觉信息,就会获得更高的重加权激励。这是一种“后期增益”策略。
3. 双粒度优势重加权
VGPO 将上述补偿信号整合进 GRPO 强化学习框架中:
- Intra-trajectory (轨迹内):识别并强化单条推理路径中真正与视觉相关的“高光 Token”。
- Inter-trajectory (轨迹间):在多个采样结果中,优先奖励那些展现出卓越全局视觉一致性的回复。
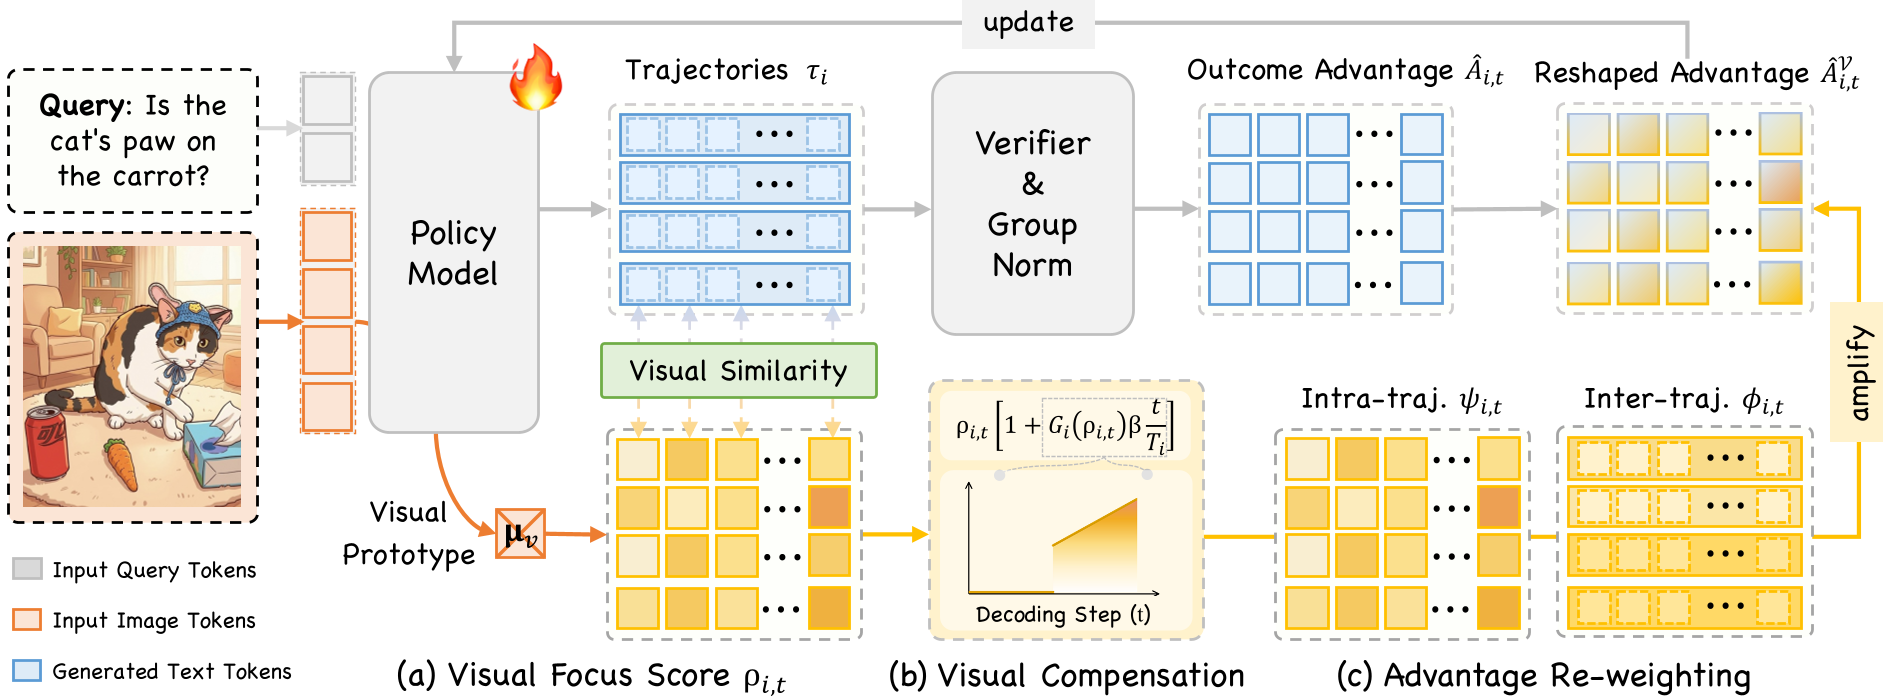 图 2:VGPO 框架流程:从隐藏状态提取聚焦分,到实施后期补偿,最后进行双粒度重加权更新。
实验战绩:SOTA 的成色
VGPO 在 Qwen2.5-VL 全系列上都表现出了碾压级的性能提升。
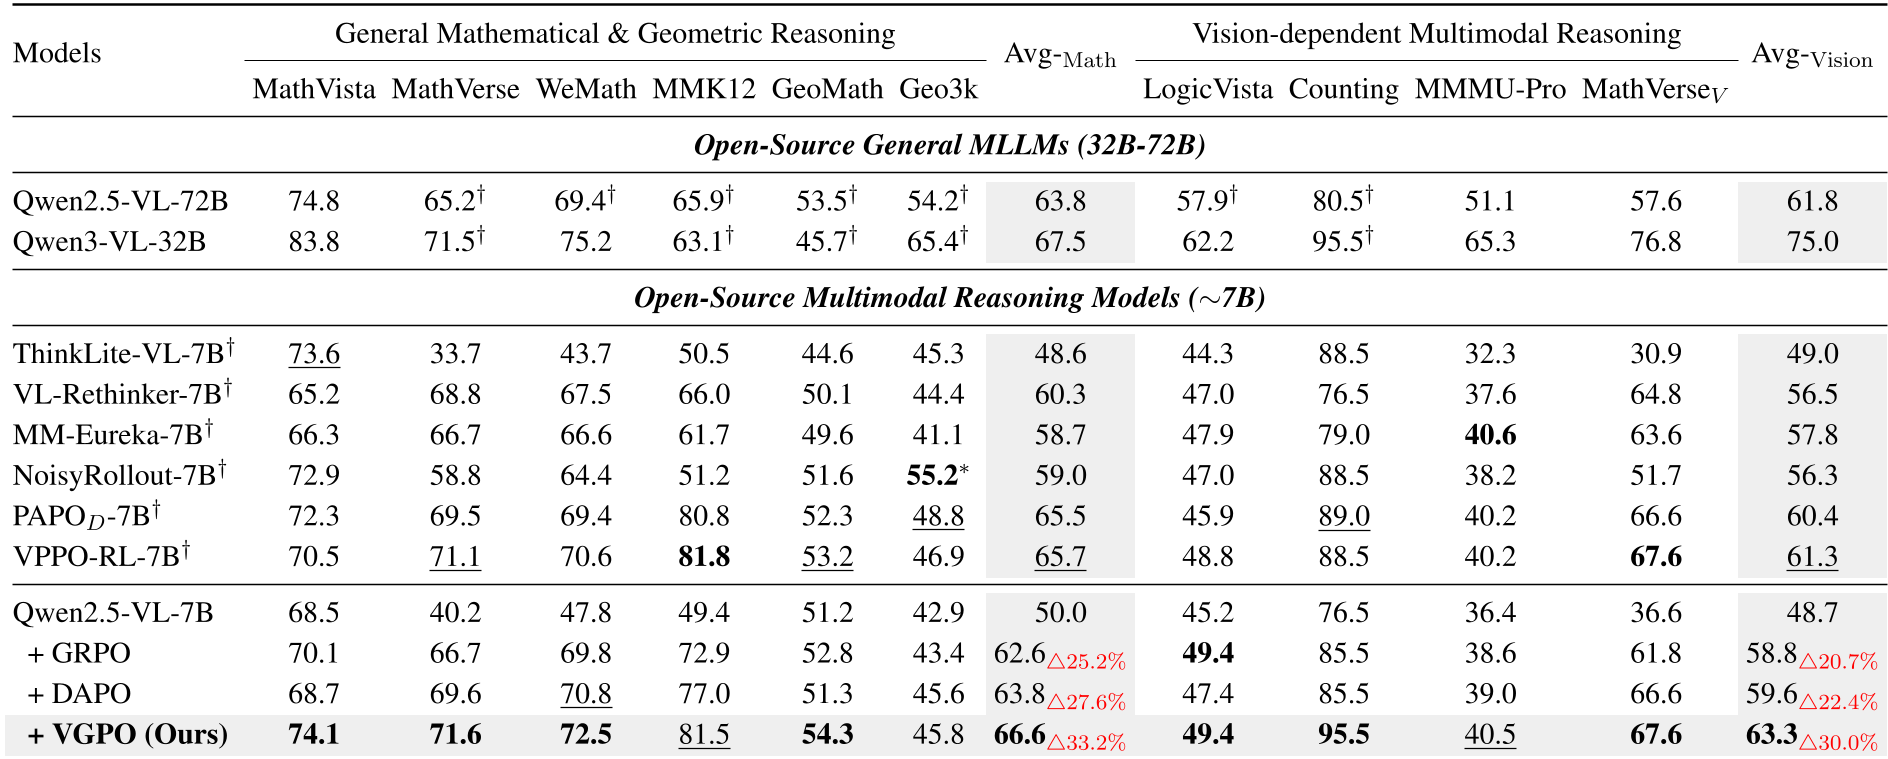 表 1:在 MathVista, LogicVista 等基准测试中,VGPO 显著优于传统的 GRPO 和 DAPO。
深度见解:
- 训练稳定性:在大规模模型(如 32B)上,传统的强化学习常因奖励稀疏导致剧烈震荡,而 VGPO 提供的“视觉引导”作为一种辅助信号,极大地平滑了学习曲线。
- 效率优先:由于只利用
output_hidden_states,VGPO 与 Flash Attention 3 完全兼容,相比提取 Attention weights 的方案,计算开销降低了 20% 以上。
总结与局限
VGPO 成功证明了:提升多模态推理的关键未必是更强的逻辑,而是更持久的观察。
局限性分析:
- 上限受限于 Encoder:如果 Vision Encoder 初始特征提取出错(见文章末尾的 Failure Case),VGPO 可能会“自信地”加强错误。
- 启发式补偿:线性补偿虽然有效,但未必对所有推理模式都是最优的(如纯计算步骤可能不需要强视觉关注)。
未来的方向将在于如何实现更动态、上下文感知的视觉依赖调整。