
世界动作模型 (WAMs):开启具身智能的“物理直觉”时代
World Action Models: The Next Frontier in Embodied AI
本文系统性地提出了“世界动作模型”(World Action Models, WAMs)这一新兴范式,旨在将具身智能从单纯的“观察-动作”映射提升为联合建模环境动力学与动作生成的预测型架构。该综述正式定义了 WAMs 的分类学(级联式与联合式),并全面梳理了其在物理常识理解和零样本泛化方面的 SOTA 成就。
TL;DR
如果说传统的 VLA 模型模型是“见招拆招”的条件反射。那么 World Action Models (WAMs) 则为机器人安装了一个“模拟大脑”。它不仅学习如何做动作(Action),更通过预测未来状态(Future State)来理解物理规律,从而在复杂、长程的任务中展现出前所未有的泛化性与鲁棒性。
现状痛点:机器人缺乏“物理常识”
当前的 Vision-Language-Action (VLA) 模型(如 RT-2, OpenVLA)虽然在语义泛化上取得了巨大进步,但它们本质上是黑盒映射:输入图像,输出动作。这种**反应式映射(Reactive Mapping)**存在致命缺陷:
- 缺乏预见性:模型不知道动作下去后世界会变成什么样,导致在接触密集型任务中容易动作变形。
- 数据效率低下:严格依赖专家演示数据(),无法吸收互联网上百亿小时的“无动作标注”人类视频。
WAMs 的公式革命:从预测动作到预测未来
WAMs 的核心思想是将具身智能任务重新表述为一个联合分布的预测问题: 这与传统 VLA 只关注 有本质区别——模型现在必须同时回答两个问题:“我该怎么做?”以及“世界会因此变成什么样?”。
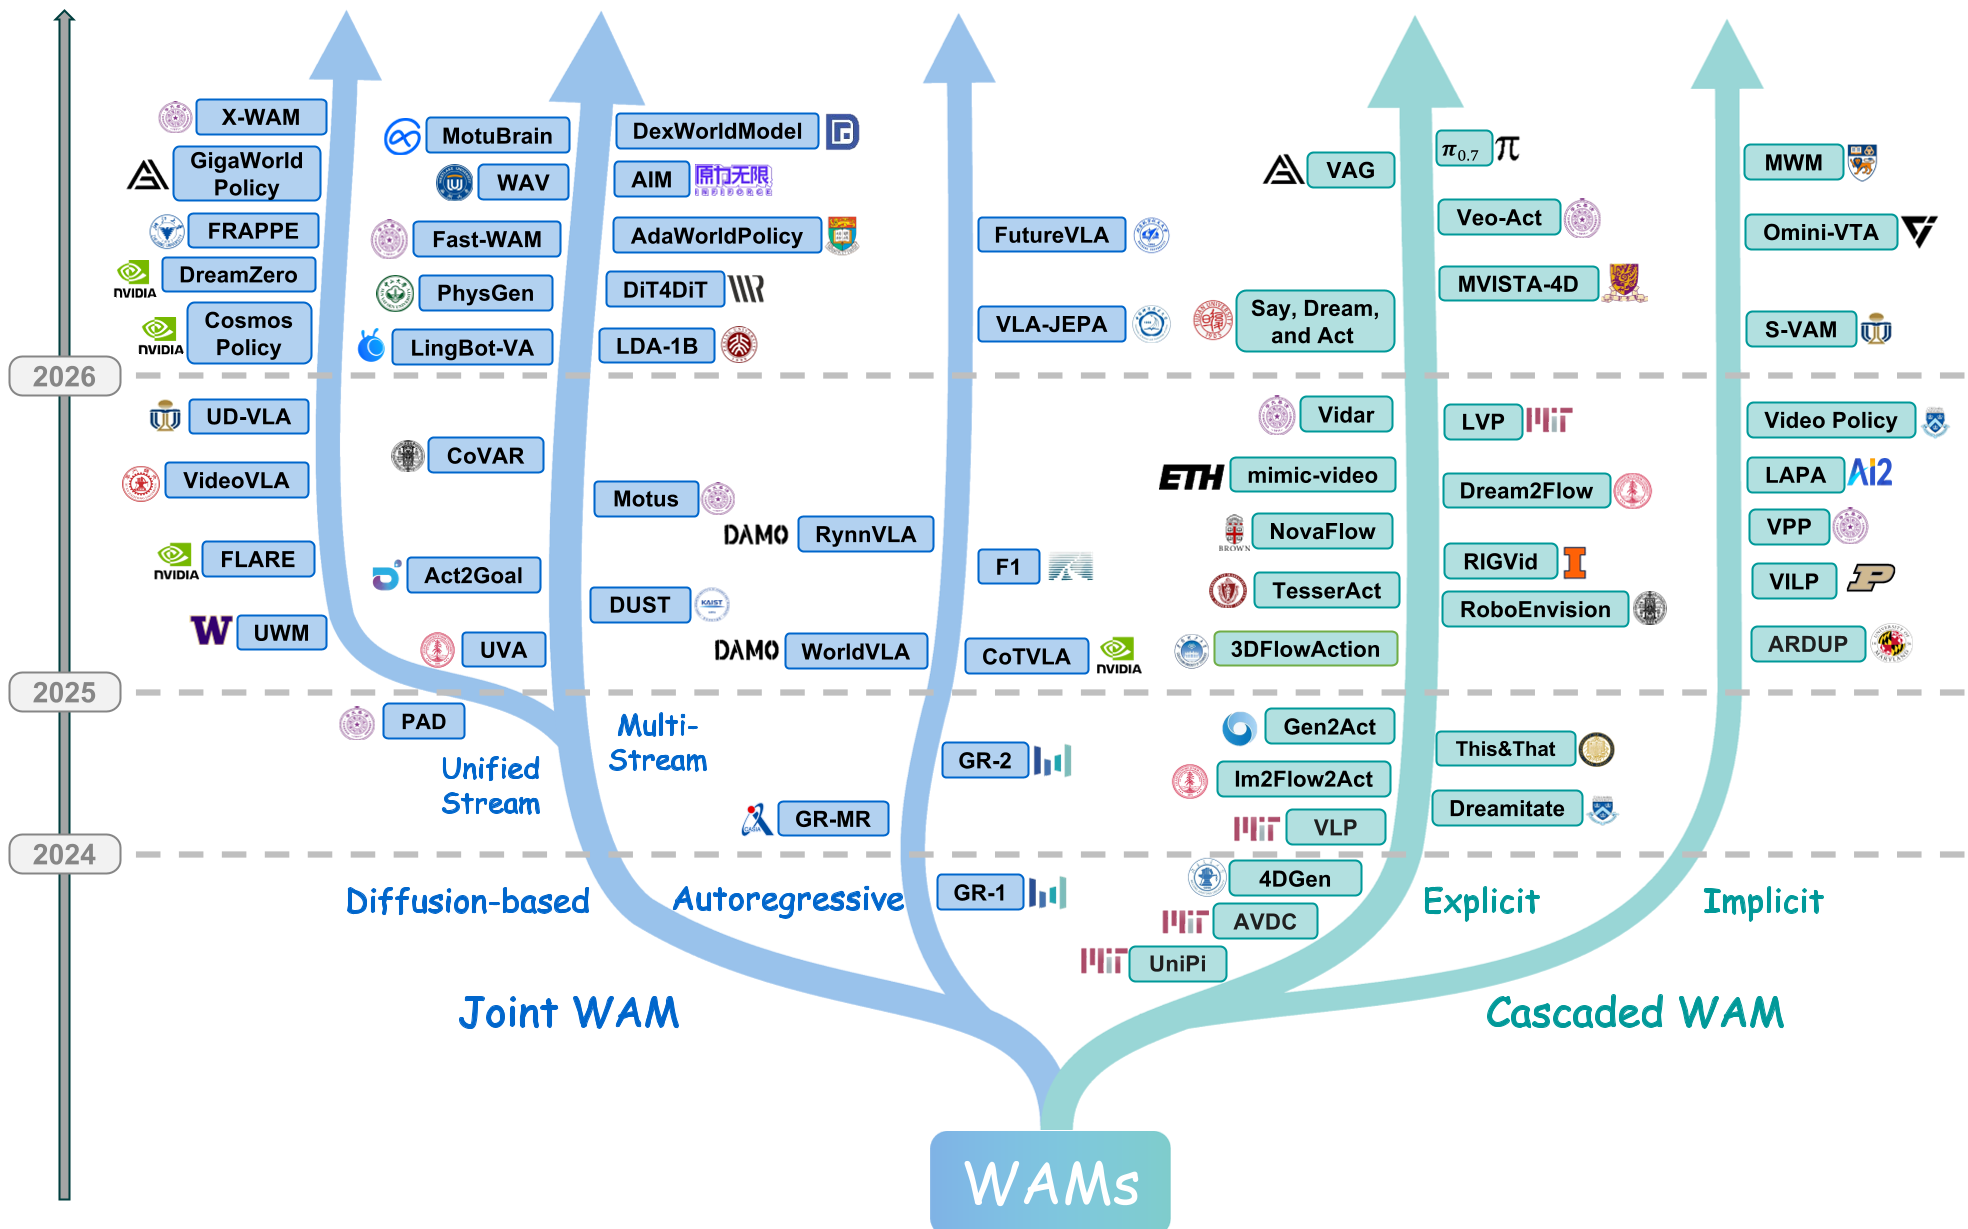
架构解析:级联式 vs 联合式
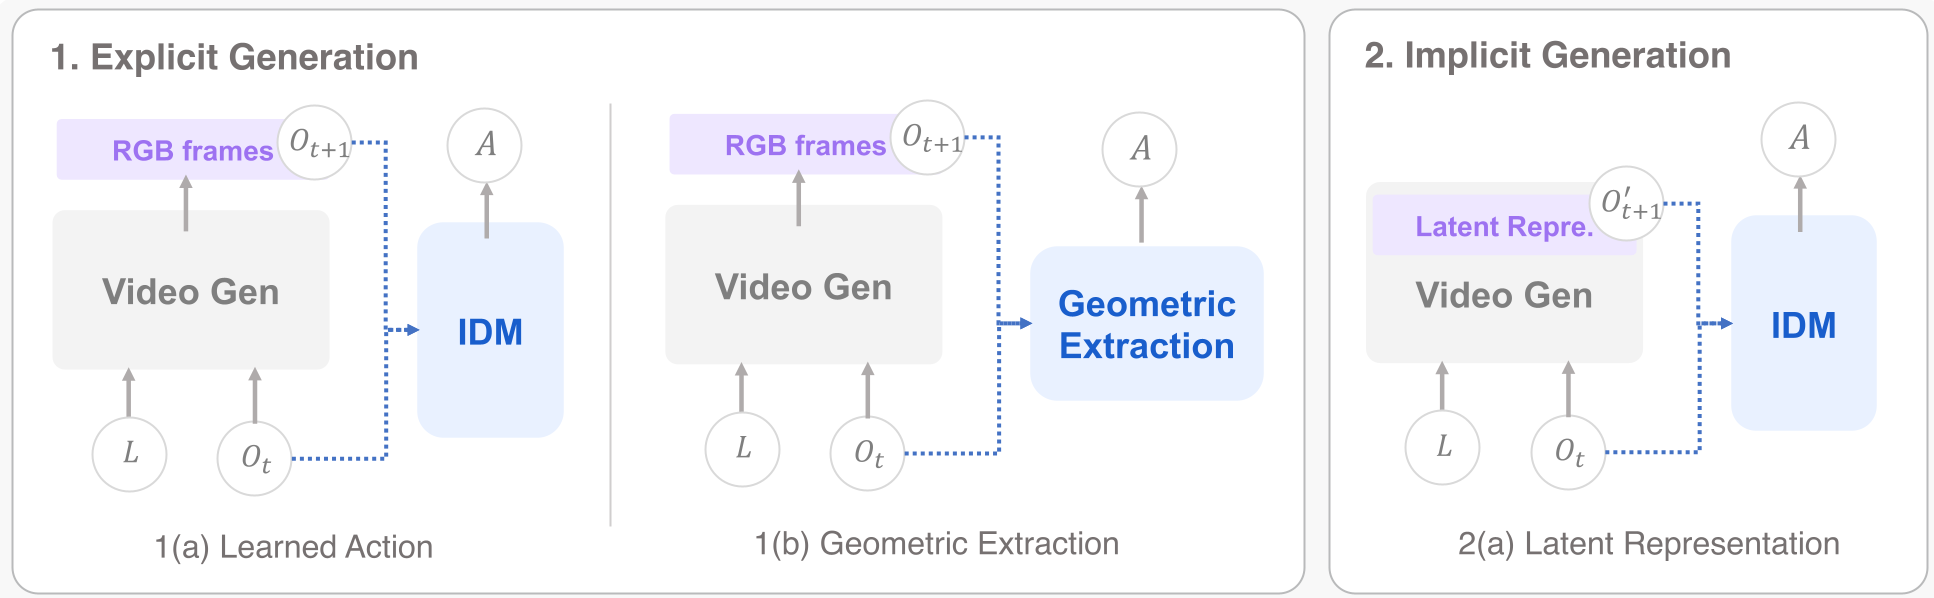
1. 级联式 WAM (Cascaded WAM)
级联式架构采用“显式规划”的逻辑。模型先生成一个未来的视觉蓝图(如像素视频或轨迹流),再由动作解码器执行该蓝图。
- 优势:解耦了物理建模和运动学控制,可以充分利用强大的预训练视频生成模型(如 Sora, Wan 2.1)。
- 关键公式:
2. 联合式 WAM (Joint WAM)
联合式架构则更追求“深度耦合”,在单个网络(通常是 Diffusion Transformer 或 Autoregressive LLM)中同步生成状态和动作。
- Unified Stream(单流):将未来图像的 Latent 和 Action Token 放在同一个序列里丢进 DiT 进行 Denoising。
- 特性:物理直觉直接渗透进动作生成过程,延迟更低,一致性更强。
实验战绩:物理常识的威力
论文综述了大量实验结果,证明了引入世界模型后的本质提升:
- 泛化性能:在 Libero 任务中,通过联合建模,模型能够更好地处理物体遮挡和复杂的接触动力学。
- 数据缩放:WAMs 允许模型在大量无标注的人类视频上进行预训练,学习诸如“重力”、“碰撞”等通用物理规律。
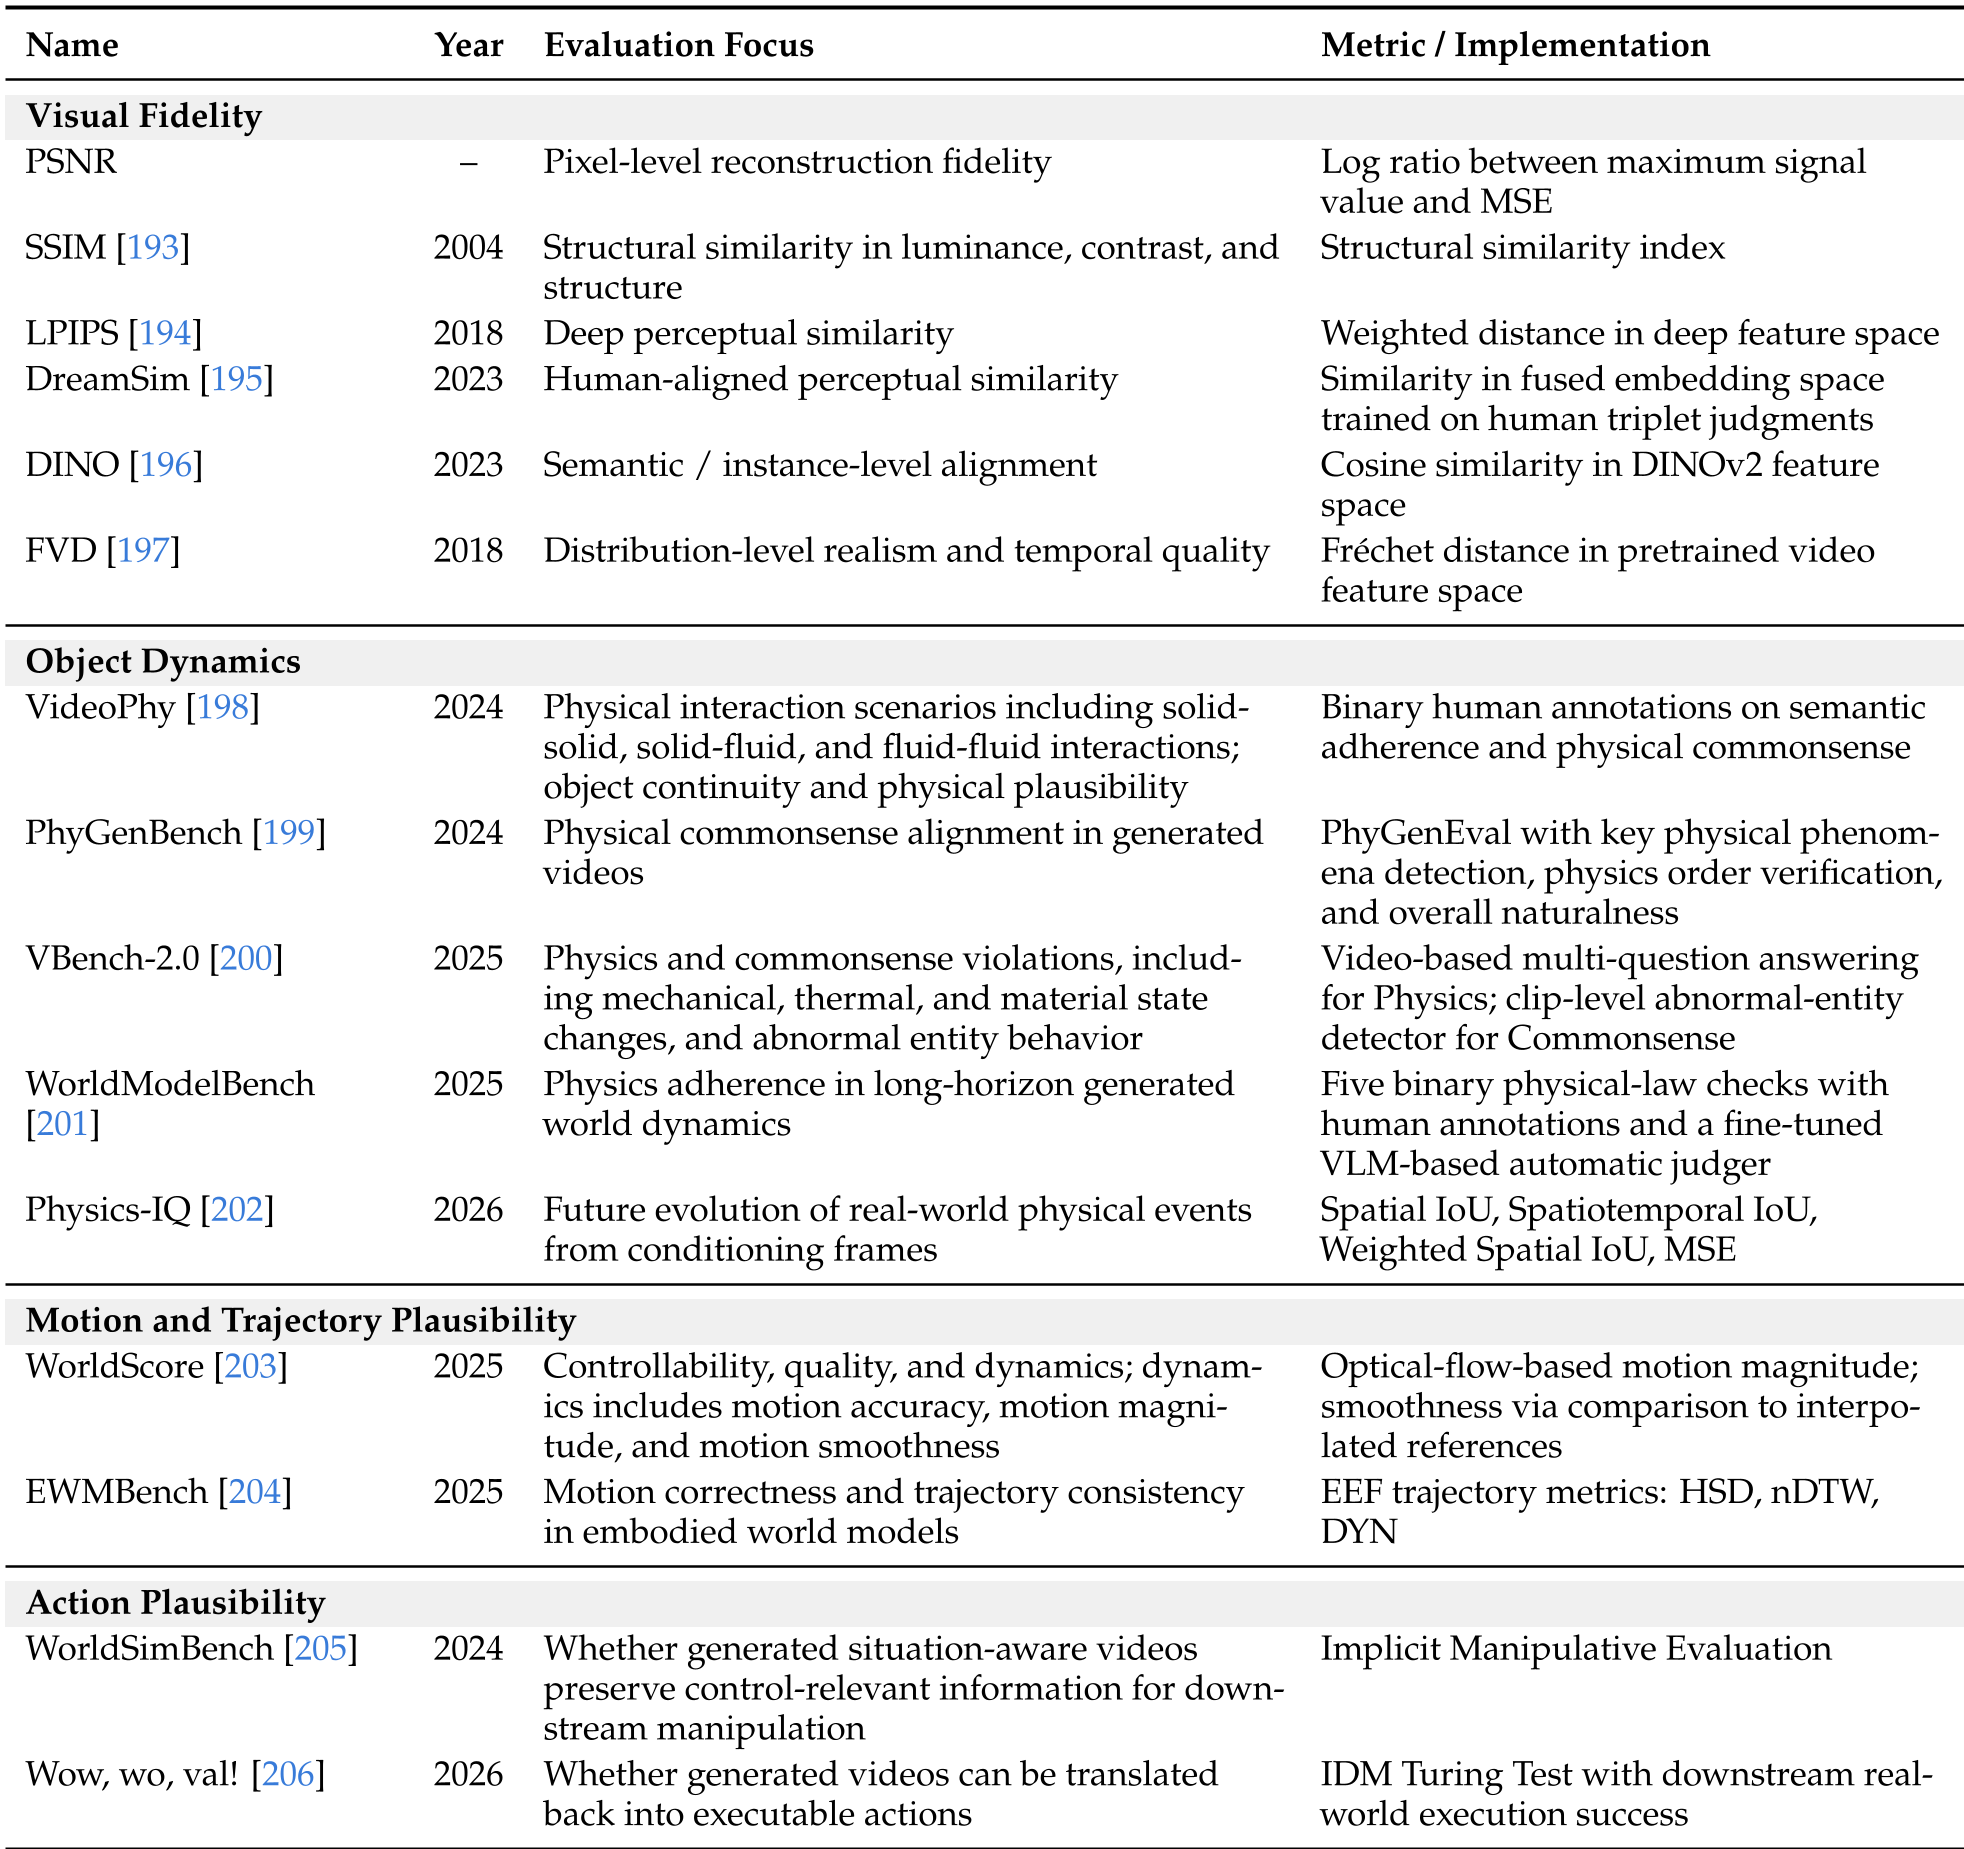
- 评价体系:除了任务成功率,WAMs 还引入了视觉保真度(FVD)、物理连贯性和“动作合理性”等维度,确保模型不是在“瞎画图”。
深度洞察与总结
WAMs 的兴起标志着机器人学习正进入其“物理模拟器内置化”的阶段。
关键趋势总结:
- 从像素到潜空间:显式像素预测虽然直观但计算量大,未来的 WAMs 将更多地在 Latent Space(如 JEPA 架构)中进行因果推理。
- 多模态融合:视觉只是物理世界的一部分。未来的 WAMs 需要预测触觉(Tactile)和力反馈(Force),这对于精细化的装配任务至关重要。
局限性分析: 目前的 WAMs 面临巨大的“推理延迟税”。预测未来的视觉状态极其消耗算力,如何在保持 50Hz 以上控制频率的同时进行高保真预测,是通向商业部署的最后一公里。
结论: World Action Models 赋予了机器人“闭眼思考”的能力。这不再仅仅是端到端的模仿学习,而是向着真正的通用物理智能迈出的一大步。